
Elasticsearch
Elasticsearch 概述
Elasticsearch 是什么
Elasticsearch 是一个基于 Lucene 的搜索服务器,具有 近实时 特性、分布式 能力的 全文搜索和分析引擎,基于 RESTful web 接口。
Elasticsearch 是用 Java 语言 开发的,并作为 Apache 许可条款下的 开放源码 发布,是一种流行的企业级搜索引擎。
Elasticsearch 是最受欢迎的企业搜索引擎,其次是 Apache Solr,他们都是基于 Lucene。
Lucene 是 Apache 的开源搜索引擎类库,提供了高性能的搜索引擎 API,但 Lucene 只限于 Java 语言开发,且不支持水平扩展,Elasticsearch 继承了 Lucene 的倒排索引的特性,还提供了分布式能力,支持水平扩展,提供 Restful 接口,可被任何语言调用。
Elastic Stack
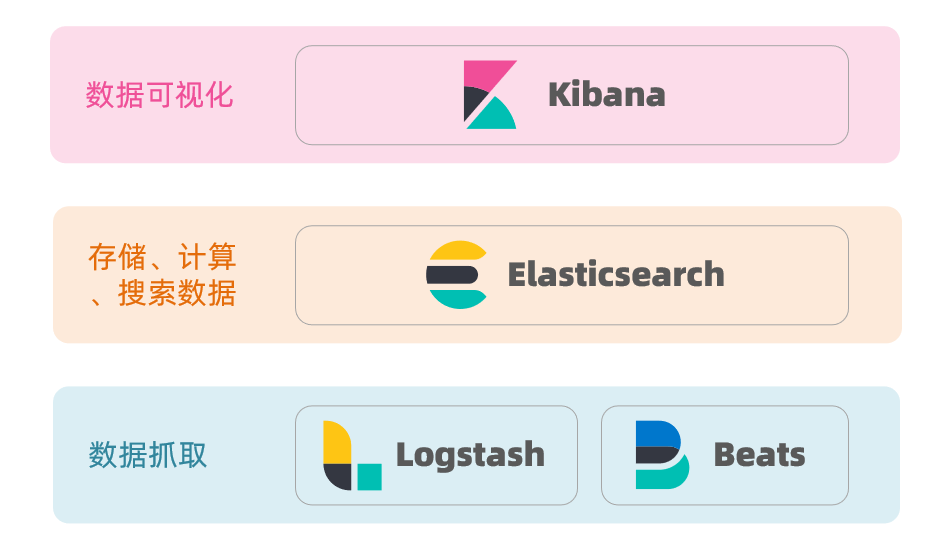
Elastic 技术栈,包括:
- Beats:负责数据采集。
- Logstash:负责日志的收集、解析、转换。
- Kibana:负责可视化、浏览和管理数据。
- Elasticsearch:Elastic Stack 的核心,负责存储、搜索、分析数据。
前三个就是 ELK,供了一整套分布式日志系统的解决方案。
Elasticsearch 发展历史
- 2004 年 Shay Banon 基于 Lucene 开发了 Compass
- 2010 年 Shay Banon 重写了 Compass,取名为 Elasticsearch。
2026 年 7 月版本:9.4.3
为什么要用 Elasticsearch
全文检索
- 执行
SELECT * FROM goods WHERE name LIKE '%xxx%'时,无法使用索引,只能全表扫描,再进行字符串匹配来实现这种模糊查询,实际上还是精确匹配,在百万级别及以上的数据量下响应极慢。 - Elasticsearch 通过倒排索引快速定位某个词的位置,支持中文分词,支持相关性排序、模糊搜索、拼写纠错等
- 执行
复杂查询
- 当查询条件超过 3 个(如:价格区间 + 品牌 + 颜色 + 库存 + 排序),SQL 会变得极其臃肿,且多字段组合索引难以覆盖所有场景。同理,如果把每个搜索项都建上索引,会非常影响 MySQL 的写入操作的性能。对于
LIMIT 100000, 10这样的深分页,MySQL 需要在内存中丢弃大量数据,导致查询超时甚至内存溢出(OOM)。 - ES 的 Filter(过滤器) 上下文会利用 Bitset(位图) 快速进行多条件交集计算,无论条件多复杂,性能损耗极小。同时,它通过 Search After 或 Scroll 游标机制,彻底解决了深分页带来的性能断崖问题。
- 当查询条件超过 3 个(如:价格区间 + 品牌 + 颜色 + 库存 + 排序),SQL 会变得极其臃肿,且多字段组合索引难以覆盖所有场景。同理,如果把每个搜索项都建上索引,会非常影响 MySQL 的写入操作的性能。对于
聚合分析
- 对上亿条数据进行 GROUP BY 分类统计、求平均值、计算百分位(Percentiles)时,不仅执行时间以分钟计,还极易因内存消耗过大导致数据库崩溃。
- ES 基于列式存储(Doc Values) 进行聚合计算。它不需要遍历整个文档,而是按列读取数据,配合分布式计算能力,能在秒级返回上亿数据的统计报表。
在互联网或电商领域引入 ES,很多是为了解决这些场景的问题。
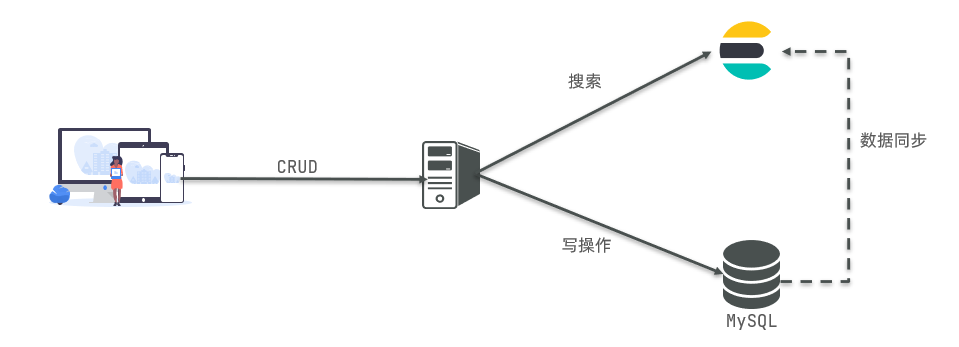
合适的架构设计:MySQL 负责事务性写入(增删改),结构化字段的精确查询,事务类型操作,保证 ACID(原子性、一致性、隔离性、持久性),Elasticsearch 负责复杂查询(复杂检索、聚合分析),通过 Canal 或 DataX 等中间件异步同步数据,提供极致的查询性能,本质上是将“读”和“写”的数据库解耦,用专业的工具做专业的事,体现了 CQRS(命令查询职责分离) 的核心思想。
倒排索引
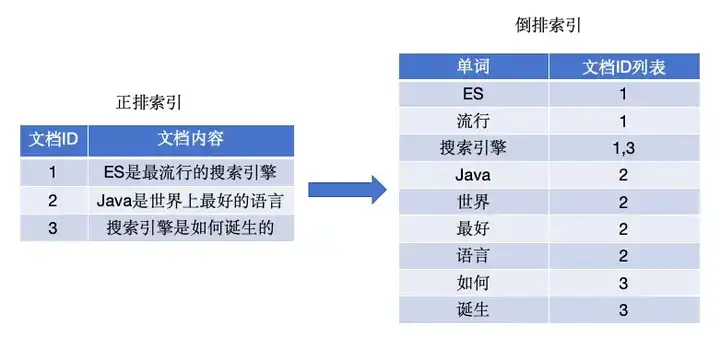
- 正排索引(正向索引):类似 MySQL 的关系数据库使用的基本都是正向索引。通过文档 ID 去查找关键词(文档内容),但是遇到模糊查询只能逐行扫描数据并匹配符合条件的字符串,全表扫描,随着数据量增加,其查询效率也会越来越低。
- 倒排索引(反向索引):是基于正排索引的特殊转换,将每一个文档(Document)的数据利用算法分词,得到一个个词条(Term)。搜索时,会对搜索语句也进行分词,再通过词条查找到文档 ID,最后通过正排索引查询文档 ID 所对应的文档。
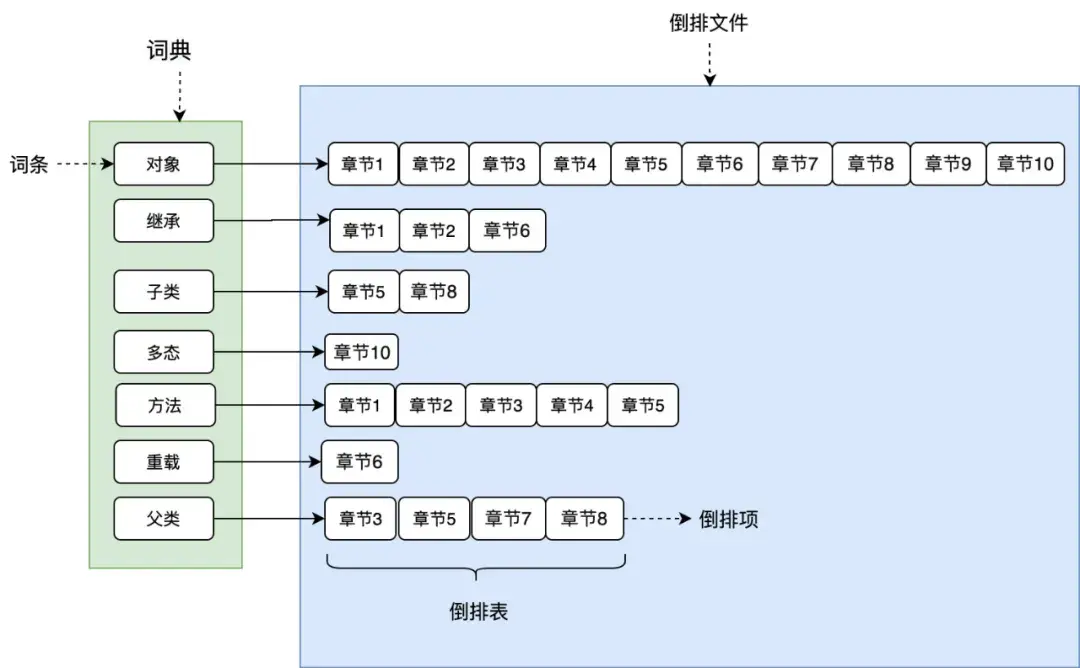
索引类似于一本书的目录页,记录了书中所有文章的章节序号、章节名字、概况以及文章地址的页码,我们可以通过目录来定位文章内容的具体地址。而倒排索引类似于将书本内容的所有文字编排成一个关键词的词典,每个关键词都有一个列表与其对应,这个列表就是倒排表,存放的是章节文档编号和词频等信息。
这引申出倒排索引的两个重要部分:词典和倒排列表。
- 词典(Term Dictionary):记录了所有文档的单词与倒排列表的关联关系,单词词典会比较大,一般通过 B+树来实现,以满足高性能的插入与查询。词典在内存中存储。词典里的单词就是 词条(Term),词条时索引里面最小的存储和查询单元,对于英文来说是一个单词,对于中文来说一般指分词后的一个词。
- 倒排列表(Posting List):记录了单词对应的文档结合,倒排列表中的每个元素就是一个倒排项。倒排列表往往顺序地存储在磁盘的某个文件里,这个文件被称之为 倒排文件 (Inverted File)。
- 文档 ID,等同于数据库主键;
- 词频(Term Frequency),该单词在文档中出现的次数,主要是用于打分;
- 位置(Positon),单词在文档中分词的位置,用于语句搜索;
- 偏移(Offset),记录单词的的位置;
分词器
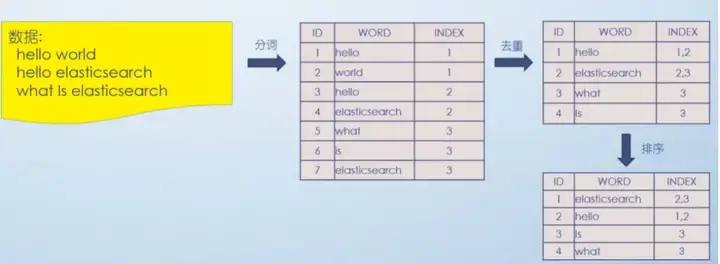
没有分词器的话,就没有词典,也就构建不了倒排索引了。
分词器的主要工作是,把用户输入的一段文本,按照一定的逻辑,转换成一系列单词,然后对单词去重、排序。
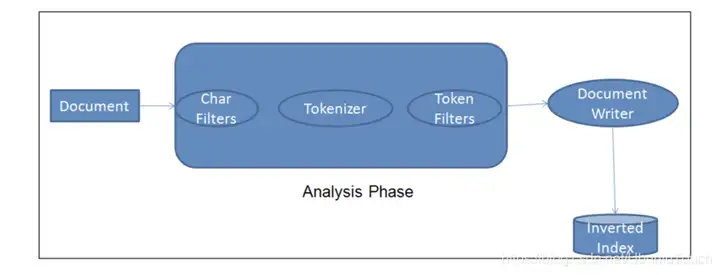
分词器一般由三个部分组成:
- 字符过滤器(Character Filters),对原始文本进行处理,最常见的就是第一种;
- 分词器(Tokenizer),顾名思义,将原始文本按照特定的规则切分为单词,默认的是 Standard Tokenizer;
- Token 过滤器(Token Filter),将切分的单词进行加工,如:大小写转换,去掉停用词,加入同义词,等等。
Elasticsearch 入门、安装、部署
安装 Elasticsearch
官网:Elastic — 搜索 AI 公司 | Elastic
下载最新版并解压
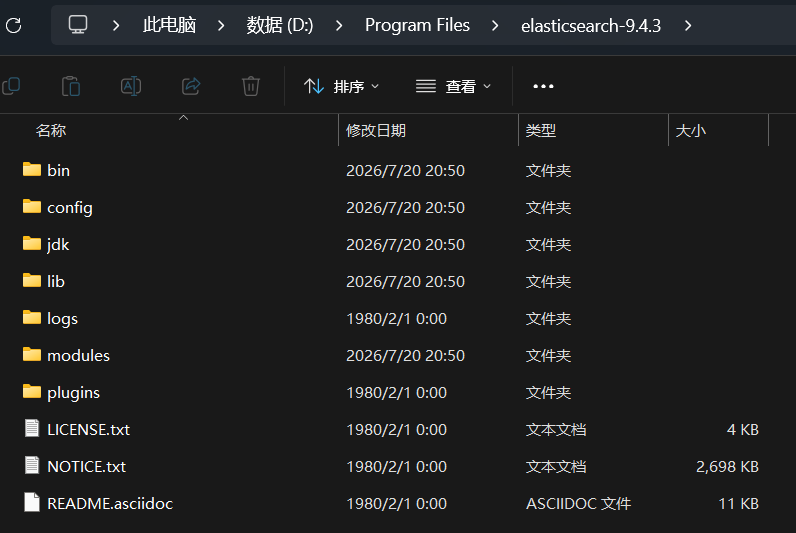
建议添加 bin 目录进入 PATH 环境变量
运行 bin/elasticsearch.bat
修改 jvm 参数,ES 会自动设置 JVM 的内存值为你电脑内存的一半,即如果你电脑的内存是 32G 他则默认携带 -Xms16g、 -Xmx16g 参数。所以如果你电脑内存小的话,需要配置一下 config/jvm.options 文件
其他配置
#修改集群名称
cluster.name: my-elasticsearch

#修改节点名称
node.name: node3

#数据储存节点
path.data: /data01/es/data

#集群日志存储
path.logs: /data01/es/logs

#网络绑定
network.host: 0.0.0.0

#可以成为master节点
cluster.initial_master_nodes: ["node3"]

#跨域配置
http.cors.enabled: true
http.cors.allow-origin: "*"
测试连接,默认端口 9200,默认协议 https,默认账号 elastic,控制台打印密码
重置控制台密码:elasticsearch-reset-password -u elastic
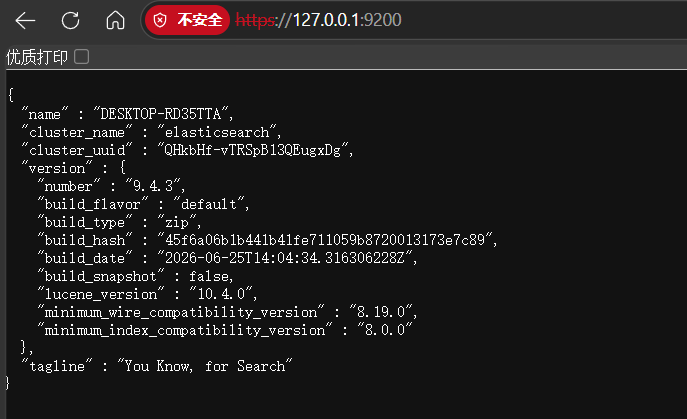
学习测试环境中,取消 https 和密码认证,修改核心配置文件 config/elasticearch.yml,然后重启 ES
xpack.security.enabled: false

xpack.security.http.ssl:
  enabled: false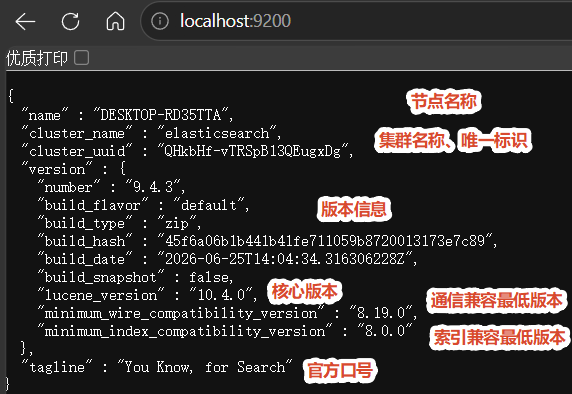
安装 elasticsearch-head
elasticsearch-head 是用于监控 Elasticsearch 状态的客户端插件,包括数据可视化、执行增删改查操作等的一款开源软件。可选。
git clone git://github.com/mobz/elasticsearch-head.git
cd elasticsearch-head
npm install
npm run start
安装 kibana
Kibana 是为 Elasticsearch 设计的开源分析和可视化平台。
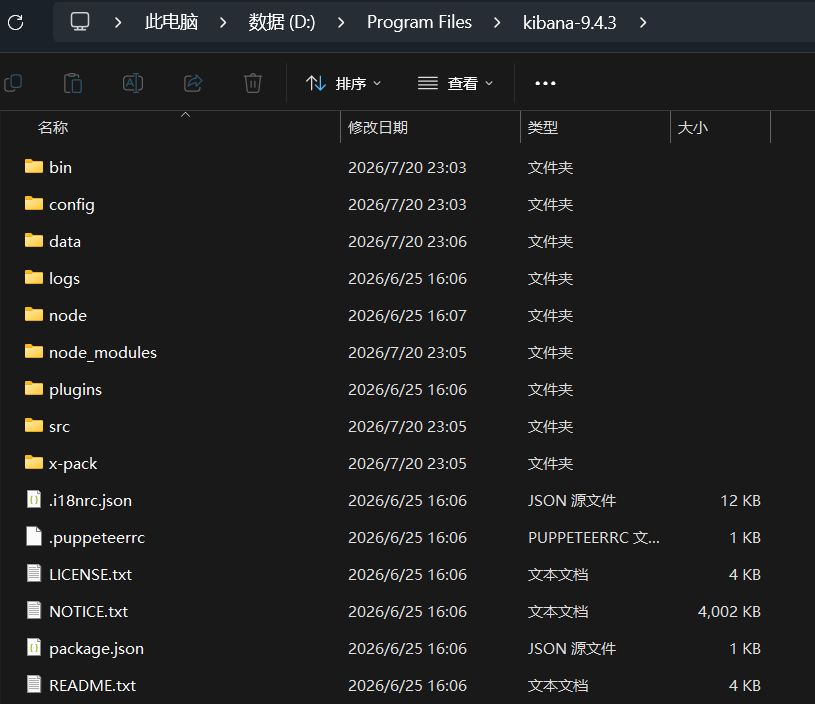
建议添加 bin 目录进入 PATH 环境变量
修改核心配置文件
#监听端口

server.port: 15601

#允许所有的ip访问
server.host: "0.0.0.0"

#es集群节点
elasticsearch.hosts: ["http://localhost:9200"]

# 如果 Elasticsearch 启用了安全特性,需要添加认证信息:
#es 用户
elasticsearch.username: "elastic"

#es密码
elasticsearch.password: "密码"

#将kibana 设置为中文
i18n.locale: "zh-CN"
启动 bin/kibana.bat
登录方式,获取 token bin\elasticsearch-create-enrollment-token.bat --scope kibana,或者使用账号密码登录。
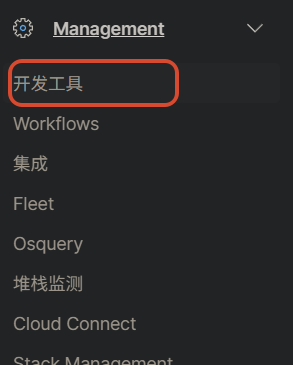
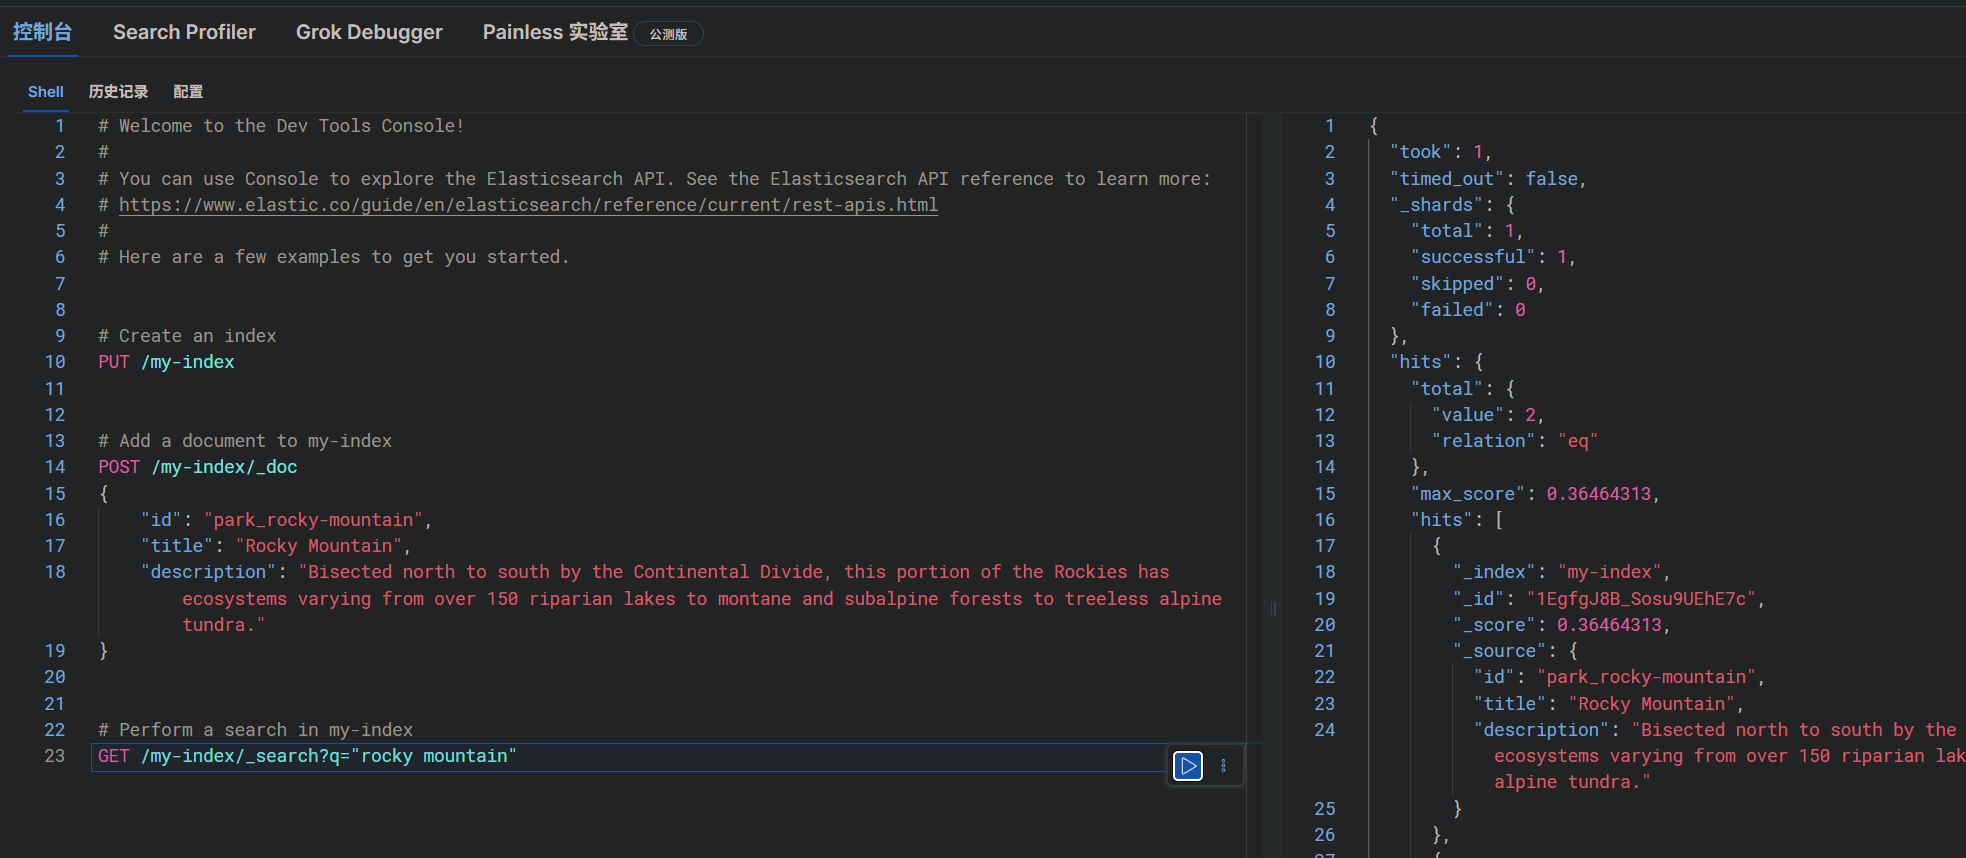
打开控制台测试,
安装 ik 插件
ES 默认的 standard analyzer 按字符边界切分,英文按空格切没问题,中文没有空格,就变成逐字切分。可以用_analyze API 直接看切分结果:
POST /_analyze
{
  "analyzer": "standard",
  "text": "无线降噪耳机"
}
输出的是逐字拆分 ["无", "线", "降", "噪", "耳", "机"]
因此建议安装 ik 分词器 提供中文支持
在线安装:elasticsearch-plugin install https://get.infini.cloud/elasticsearch/analysis-ik/你的ES版本
离线安装:在仓库 Index of: analysis-ik/stable/ 中下载对应版本插件,直接将文件解压,放入到 ES 安装目录 plugins 目录下,比较新的版本要求文件命名使用 analysis-ik

重启 ES 测试
ik_smart 让用户的搜索尽可能的准确。
POST _analyze
{
  "analyzer": "ik_smart",
  "text": "我是中国人"
}
输出 ["我", "是", "中国人"]
ik_max_word 尽可能多的分词
POST _analyze
{
  "analyzer": "ik_max_word",
  "text": "我是中国人"
}
输出 ["我", "是", "中国人", "中国", "国人"]
IK 分词器还提供了扩展词汇的功能
在 ik 目录编辑 config/IKAnalyzer.cfg.xml
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE properties SYSTEM "http://java.sun.com/dtd/properties.dtd">
<properties>
        <comment>IK Analyzer 扩展配置</comment>
        <!--用户可以在这里配置自己的扩展字典 *** 添加扩展词典-->
        <entry key="ext_dict">ext.dic</entry>
</properties>
Elasticsearch 核心概念
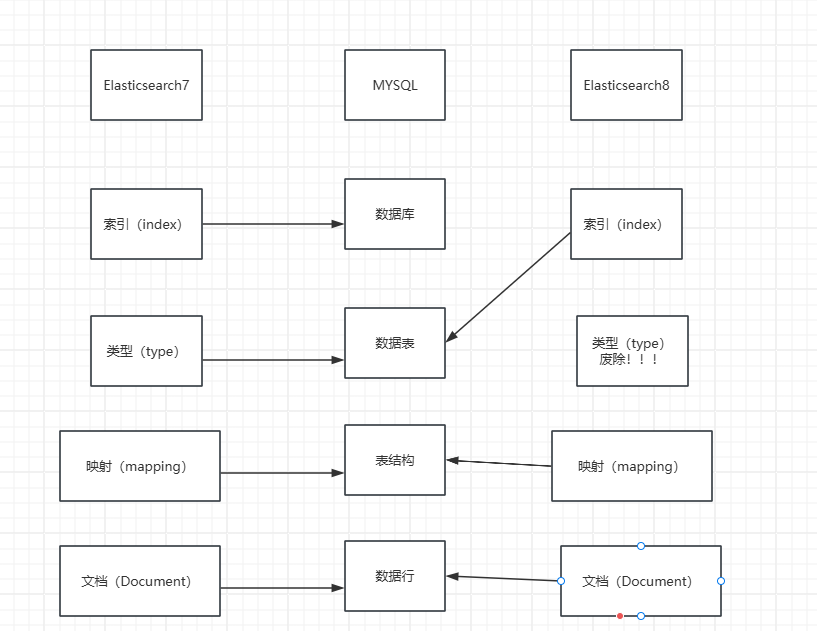
elasticsearch 中有很多独有的概念,与 mysql 中略有差别,但也有相似之处。
节点(Node)
就像一个数据库实例
运行了单个实例的 ES 主机称为节点。
一个 Elasticsearch 服务启动实例就是一个节点(Node)。节点通过 node.name 来设置节点名称,如果不设置则在启动时给节点分配一个随机通用唯一标识符作为名称。
集群 (Cluster)
就像整个数据库服务器
一个或多个 节点 的集合,它们共同存储数据集群。每个节点配置相同的 cluster.name 即可加入集群,默认值为 “elasticsearch”。
索引(index)
索引就像数据库或数据表
在 Elasticsearch 6.x 及更早版本中,有一个 类型(Type) 的概念,那时候一个索引可以包含多个 Type,每个 Type 类似于一张表。因为一个索引下可以定义多个表结构。但从 Elasticsearch 7.0 开始,Type 被废弃,一个索引只能存储一种类型的文档,这就使得索引直接对标为表。官方推荐为每个数据模型单独创建索引。
一个索引就是一个拥有几分相似特征的文档的集合,ES 将数据存储于一个或多个索引中。
新建索引(PUT)
PUT /索引名/文档id
{请求体}
映射(mapping)
就像数据库中定义的表结构
映射是定义文档及其包含的字段如何存储和索引的过程。
例如
 哪些字符串字段应该被视为全文字段。
 哪些字段包含数字、日期或地理位置。
 文档中所有字段的值是否应该被索引到 catch-all _all 字段中。
 日期值的格式。
 用于控制动态添加字段的映射的自定义规则。
每个索引都有一个映射类型,它决定了文档的索引方式。
文档(document)
就像数据库里的一行数据
文档是索引中的一条数据记录,以 JSON 格式存储,是 ES 中信息存储和检索的基本单位
字段(Field)
就像表中的一列
文档中的属性
分片 (Shard)
就像数据库的分表
索引可以拆分为多个分片,分布在不同节点上,以实现水平扩展。
副本(Replica)
数据备份
分片的拷贝,用于提高数据的高可用性和查询的并发能力
DSL
就像 SQL 语句
DSL 是 elasticsearch 提供的 JSON 风格的请求语句,用来操作 elasticsearch,实现 CRUD。在 ES 中,通过 RESTful API 把 DSL 的 JSON 数据包发送给服务器。
有多种方法可以向 Elasticsearch 发出命令。
- 通过在浏览器中或使用
curl命令 - 通过 Kibana 的控制台工具
Elasticsearch 基础操作
主要都在围绕着数据的 CRUD 进行处理:
| CRUD command | HTTP/REST command |
|---|---|
| Create | PUT or POST |
| Read | GET |
| Update | PUT or POST |
| Delete | DELETE |
以下介绍一些常见 API,详情参阅 中文文档 、 官方文档 和 官方 API 文档
集群操作
查看集群信息
# 集群统计信息
GET /_cluster/stats
# 查看集群健康
GET /_cluster/health
# 查看所有节点健康
GET /_nodes/stats
# 查看指定节点健康
GET /_nodes/XWubzYH-QJexlyqnwEIWUQ/stats
索引操作
# 新建索引
PUT /students
# 新建索引及映射
PUT /news
{
  "mappings": {
    "properties": {
      "title": {
        "type": "text",
        "analyzer": "ik_max_word",
        "search_analyzer": "ik_smart"
      },
      "content": {
        "type": "text",
        "analyzer": "ik_max_word",
        "search_analyzer": "ik_smart"
      },
      "author": {
        "type": "keyword"
      },
      "tags": {
        "type": "keyword"
      },
      "publish_date": {
        "type": "date",
        "format": "yyyy-MM-dd||yyyy-MM-dd HH:mm:ss"
      }
    }
  }
}
# 查看索引
get /students
# 修改索引,如映射
PUT /students/_mapping
{
  "properties": {
    "email": {
      "type": "keyword"
    },
    "create_time": {
      "type": "date",
      "format": "yyyy-MM-dd||yyyy-MM-dd HH:mm:ss"
    }
  }
}
# 删除索引
delete /students
文档操作
# 新增文档 无自定义ID
POST /news/_doc/
{
  "title": "新闻标题",
  "content": "新闻内容",
  "author": "作者",
  "tags": ["标签1", "标签2"],
  "create_time": "2026-07-15 09:00:00",
  "publish_date": "2026-07-15"
}
# 新增文档 自定义ID
POST /news/_doc/1
{
  "title": "新闻标题1",
  "content": "新闻内容1",
  "author": "作者",
  "tags": ["标签1", "标签2"],
  "create_time": "2026-07-15 09:00:00",
  "publish_date": "2026-07-15"
}
# 新建文档 批量
POST /news/_bulk
{ "index": {"_id": "2"} }
{ "title": "新闻标题2", "content": "新闻内容2", "author": "张三", "tags": ["标签1", "标签2"], "create_time": "2026-07-15 09:00:00", "publish_date": "2026-07-15" }
{ "index": {"_id": "3"} }
{ "title": "新闻标题3", "content": "新闻内容3", "author": "张三", "tags": ["标签1", "标签2"], "create_time": "2026-07-15 09:00:00", "publish_date": "2026-07-15" }
# 查询文档 指定ID
GET /news/_doc/2
# 查询全部文档
GET /news/_search
# 查询文档 根据查询条件
GET /news/_search
{
  "query": {
    "match": {
      "title": "修改"
    }
  }
}
# 修改文档 全量更新
PUT /news/_doc/1
{
  "title": "修改后的标题",
  "content": "这是修改后的内容",
  "author": "作者",
  "tags": ["修改后标签1", "修改后标签2"],
  "create_time": "2026-07-15 09:00:00",
  "publish_date": "2026-07-15"
}
# 修改文档 局部更新
POST /news/_update/2
{
  "doc": {
    "title": "只改标题",
    "tags": ["更新"]
  }
}
# 删除文档 根据id
DELETE /news/_doc/3
# 删除文档 根据查询条件
POST /news/_delete_by_query
{
  "query": {
    "match": {
      "tags": "标签1"
    }
  }
}
# 删除文档 批量
POST /news/_bulk
{ "delete": {"_id": "1"} }
{ "delete": {"_id": "2"} }
Elasticsearch 常用查询
查询所有 match_all
select * from news;GET /news/_search
{
"query": {
"match_all": {}
}
}匹配查询 match
ES 的 match 匹配类型查询,会把查询条件进行分词 ,然后进行查询,多个词条之间是 or 的关系。
SELECT * FROM news WHERE title LIKE '%电影%' AND title LIKE '%国产%'GET /news/_search
{
"query": {
"match": {
"title": "电影国产"
}
}
}多字段匹配查询 multi_match
SELECT * FROM news WHERE title LIKE '%AI%' OR content LIKE '%AI%'GET /news/_search
{
"query": {
"multi_match": {
"query": "AI",
"fields": ["content","title"]
}
}
}关键字精准查询 term
不分词 。
SELECT * FROM news WHERE author = '周雪';GET /news/_search
{
"query": {
"term": {
"author": {
"value": "周雪"
}
}
}
}多关键字精准查询 terms
SELECT * FROM news WHERE author IN ('周雪', '刘洋');GET /news/_search
{
"query": {
"terms": {
"author": [
"周雪",
"刘洋"
]
}
}
}指定查询字段 _source
SELECT title, tags FROM news;GET /news/_search
{
"_source": ["title", "tags"],
"query": {
"match_all": {}
}
}排除查询字段 includes、excludes
- includes: 用来指定想要显示的字段
- excludes:用来指定不想要显示的字段
GET /news/_search
{
  "_source": {
  	"excludes":["title","author"]
  },
  "query": {
    "match_all": {}
  }
}
组合查询 bool
{
  "bool": {
    "must": [ ... ],       // 相当于 SQL 的 AND
    "should": [ ... ],     // 相当于 SQL 的 OR(有时会影响 _score)
    "must_not": [ ... ],   // 相当于 SQL 的 NOT
    "filter": [ ... ]      // 也类似 AND,但不影响打分(性能更好)
  }
}GET /news/_search
{
"query": {
"bool": {
"must": [
{ "term": { "author": "陈静" } }
],
"should": [
{ "match": { "title": "病" } },
{ "match": { "title": "学生" } }
],
"minimum_should_match": 1,
"must_not": [
{ "match": { "tags": "科技" } }
]
}
}
}范围查询 range
GET /news/_search
{
  "query": {
    "range": {
      "publish_date": {
        "gte": "2026-07-15",
        "lte": "2026-07-31"
      }
    }
  }
}
模糊匹配查询 Fuzzy
Fuzzy(编辑距离),表示把一个词变成另外一个词需要多少步操作。这个操作可以是
- 插入 (sic - > sick)
- 删除 (black -> lack)
- 置换 (box -> fox)
- 转置 (act -> cat)
为了找到相似的术语,Fuzzy 查询会在指定的编辑距离内创建一组搜索词的所有可能的变体或扩展。然后对返回每个扩展进行匹配查询。
{
  "query": {
    "fuzzy": {
      "title": {
        "value": "动漫",
        "fuzziness": 1
      }
    }
  }
}
字段排序 sort
多字段+得分(_score)排序
GET /news/_search
{
  "sort": [
    {
      "author": {
        "order": "asc"
      },
      "publish_date": {
        "order": "desc"
      }
      { "_score":{"order": "desc"}}
    }
  ]
}
短语匹配查询 Match_phrase、slop
Match_phrase 匹配一个短语(多个词之间的顺序、位置都要一致)
{
  "query": {
    "match_phrase": {
      "content": {
        "query": "票房突破    亿",
        "slop": 2
      }
    }
  }
}
高亮查询 highlight
除了返回的原始内容外,额外再返回 highlight 字段,highlight 字段里包含了高亮后的字符串,默认是通过 <em> 进行包裹。
GET /news/_search
{
  "query": {
    "multi_match": {
      "query": "病",
      "fields":["title","content"]
    }
  },
  "highlight":{
    "fields":{
        "title":{},
        "content":{}
    }
  }
}
分页查询 from、size
GET /news/_search
{
  "query": {
   "match_all": {}
  },
  "from":10,
  "size":20
}
聚合查询 aggs
聚合 = 在查询匹配到的结果集上进行统计/分组/计算,可以理解为 SQL 里的 GROUP BY 、COUNT、 SUM 、AVG 、MAX、 MIN
非常用查询 Prefix、Wildcard、Exists、Script
- 前缀匹配查询(Prefix)
- 通配符查询(Wildcard)
- 字段存在查询(Exists)
- 复杂脚本查询(Script)
SpringBoot 整合 Elasticsearch
Java 客户端选择
- Elasticsearch Java API Client:ES 官方的基于 REST 的高级客户端(推荐),提供类似 DSL 语句的用法。
- Java Rest Client
- Java Low Level Rest Client:基于 REST 的高级客户端( ES 8 已废弃)
- Java High Level Rest Client: 底层客户端,只提供 HTTP 封装,不解析 JSON。
- Spring Data Elasticsearch:Spring 提供的 Elasticsearch 的数据访问封装,支持 Repository 风格的接口编程。
- easy-es:国人团队开发,风格类似 MyBatis-Plus
Springboot3 整合 Spring Data Elasticsearch
Spring 官方文档 Elasticsearch Clients :: Spring Data Elasticsearch
引入依赖
Springboot 3.4 版本
<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
    <modelVersion>4.0.0</modelVersion>
    <parent>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-parent</artifactId>
        <version>3.4.0</version>
        <relativePath/> <!-- lookup parent from repository -->
    </parent>
    <groupId>com.example</groupId>
    <artifactId>springboot-elasticsearch-demo</artifactId>
    <version>0.0.1-SNAPSHOT</version>
    <name>springboot-elasticsearch-demo</name>
    <description>springboot-elasticsearch-demo</description>
    <url/>
    <licenses>
        <license/>
    </licenses>
    <developers>
        <developer/>
    </developers>
    <scm>
        <connection/>
        <developerConnection/>
        <tag/>
        <url/>
    </scm>
    <properties>
        <java.version>17</java.version>
    </properties>
    <dependencies>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-data-elasticsearch</artifactId>
        </dependency>
        <dependency>
            <groupId>org.projectlombok</groupId>
            <artifactId>lombok</artifactId>
            <version>RELEASE</version>
            <scope>compile</scope>
            <optional>true</optional>
        </dependency>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-test</artifactId>
        </dependency>
    </dependencies>

    <build>
        <plugins>
            <plugin>
                <groupId>org.springframework.boot</groupId>
                <artifactId>spring-boot-maven-plugin</artifactId>
            </plugin>
        </plugins>
    </build>

</project>
yml 配置文件
spring:
  application:
    name: springboot-elasticsearch-demo
  elasticsearch:
    uris: http://127.0.0.1:9200
#    username: elastic #如果有账号密码就要配置账号密码,否则可以不配置
#    password: 123456

#server:
#  port: 20000
创建 ES 实体类
@Data
@Document(indexName = "news")
@JsonIgnoreProperties(ignoreUnknown = true)
@AllArgsConstructor
@NoArgsConstructor
public class EsNews {

    @Id
    private String id;

    @Field(type = FieldType.Text, analyzer = "ik_max_word",searchAnalyzer = "ik_smart")
    private String title;//标题

    @Field(type = FieldType.Text, analyzer = "ik_max_word",searchAnalyzer = "ik_smart")
    private String content;//内容

    @Field(type = FieldType.Keyword)
    private String author;//作者

    @Field(type = FieldType.Keyword)
    private List<String> tags;//标签

    @JsonFormat(shape = JsonFormat.Shape.STRING, pattern = "yyyy-MM-dd HH:mm:ss", timezone = "GMT+8")
    @Field(type = FieldType.Date,pattern = "yyyy-MM-dd HH:mm:ss||yyyy-MM-dd")
    @JsonProperty("publish_date")
    private Date publishDate;//发布时间

    @JsonFormat(shape = JsonFormat.Shape.STRING, pattern = "yyyy-MM-dd HH:mm:ss", timezone = "GMT+8")
    @Field(type = FieldType.Date,pattern = "yyyy-MM-dd HH:mm:ss||yyyy-MM-dd")
    @JsonProperty("create_time")
    private Date createTime;//创建时间

    @Field(type = FieldType.Long)
    @JsonProperty("view_count")
    private Long viewCount;//阅读量


}
继承 ElasticsearchRepository 接口,该接口继承了 PagingAndSortingRepository(分页和排序接口)、CrudRepository(常用基础 crud 接口)
public interface EsNewsRepository extends ElasticsearchRepository<EsNews,String> {

}@NoRepositoryBean // 确保 Spring Data 不在运行时为其创建实例。
public interface ElasticsearchRepository<T, ID> extends PagingAndSortingRepository<T, ID>, CrudRepository<T, ID> {}测试,新增文档
@SpringBootTest
class SpringbootElasticsearchDemoApplicationTests {

    @Autowired
    private EsNewsRepository esNewsRepository;

    @Test
    void contextLoads() {
    }

    @Test
    @DisplayName("保存文档")
    void saveDoc(){
        EsNews news = new EsNews();
        news.setId("1");//如果不设置ID,Spring则会帮你生成一个ES风格的随机ID
        news.setTitle("电影《不能说的秘密》热映");
        news.setContent("内容:不能说的秘密............牛X..");
        news.setAuthor("周杰伦");
        news.setTags(Arrays.asList("电影", "国产"));
        news.setPublishDate(new Date());
        news.setCreateTime(new Date());
        news.setViewCount(100L);
        esNewsRepository.save(news);
    }
}
高阶用法 Elasticsearch Java API Client
	@Test
    void testClient() throws IOException {
        SearchResponse<EsNews> search = elasticsearchClient.search(r -> r.query(q -> q.matchAll(m -> m)), EsNews.class);
        System.out.println(search);
    }
CRUD 的方法和参数,分别不同:
查询的语句用的是 SearchRequest
更新的语句用的是 UpdateRequest
新增的语句用的是 CreateRequest
删除的语句用的是 DeleteRequest
批量操作语句用的是 BulkRequest
Elasticsearch 集群机制
发现机制
Elasticsearch 提供内置默认发现模块 Zen Discovery(发现模块的职责是发现集群中的节点以及选举 Master 节点),使 ES 内部可以通过一个相同的设置 cluster.name 就能将不同的节点连接到同一个集群。
- 自动组成集群:同一台机器上运行的节点会自动组成集群。
- 单播发现:如果集群的节点运行在不同的机器上,使用单播,你可以为 Elasticsearch 提供一些它应该去尝试连接的节点列表。当一个节点联系到单播列表中的成员时,它就会得到整个集群所有节点的状态,然后它会联系 Master 节点,并加入集群。
- 基于文件发现
- 通过插件扩展支持云环境和其他形式的发现。
Elasticsearch 默认被配置为使用 单播发现,以防止节点无意中加入集群。只有在同一台机器上运行的节点才会自动组成集群。
节点角色
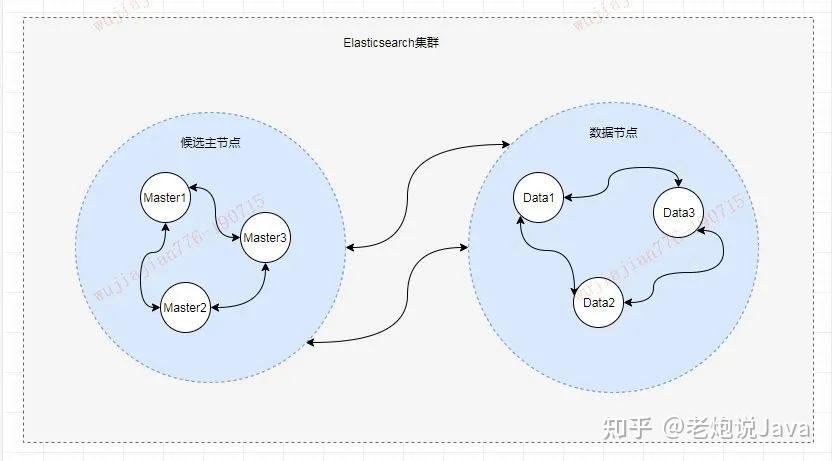
每个节点既可以是候选主节点也可以是数据节点,通过在配置文件 config/elasticsearch.yml 中设置即可,默认都为 true。
node.master: true  //是否候选主节点
node.data: true //是否数据节点- 数据节点:负责数据的存储和相关的操作,例如对数据进行增、删、改、查和聚合等操作,所以数据节点(Data 节点)对机器配置要求比较高,对 CPU、内存和 I/O 的消耗很大。
- 候选主节点:可以被选举为主节点(Master 节点),集群中只有候选主节点才有选举权和被选举权,其他节点不参与选举的工作。
- 主节点:负责创建索引、删除索引、跟踪哪些节点是群集的一部分,并决定哪些分片分配给相关的节点、追踪集群中节点的状态等,稳定的主节点对集群的健康是非常重要的。
如果某个节点既是数据节点又是主节点,那么可能会对主节点产生影响从而对整个集群的状态产生影响。因此为了提高集群的健康性,我们应该对 Elasticsearch 集群中的节点做好角色上的划分和隔离。可以使用几个配置较低的机器群作为候选主节点群。
脑裂现象
只要所有的节点都遵循同样的规则,得到的信息都是对等的,选出来的主节点肯定是一致的。
但分布式系统的问题就出在信息不对等的情况,这时候很容易出现脑裂(Split-Brain)的问题,即集群中不同的节点对于 Master 的选择出现了分歧,出现了多个 Master 竞争,此时数据更新时出现不一致。
原因:
- 网络问题: 集群间的网络延迟导致一些节点访问不到 Master,认为 Master 挂掉了从而选举出新的 Master,并对 Master 上的分片和副本标红,分配新的主分片。
- 节点负载: 主节点的角色既为 Master 又为 Data,访问量较大时可能会导致 ES 停止响应(假死状态)造成大面积延迟,此时其他节点得不到主节点的响应认为主节点挂掉了,会重新选取主节点。
- 内存回收: 主节点的角色既为 Master 又为 Data,当 Data 节点上的 ES 进程占用的内存较大,引发 JVM 的大规模内存回收,造成 ES 进程失去响应。
优化措施:
- 适当调大响应时间,减少误判。 通过参数
discovery.zen.ping_timeout设置节点状态的响应时间,默认为 3s,可以适当调大。 如果 Master 在该响应时间的范围内没有做出响应应答,判断该节点已经挂掉了。调大参数(如 6s,discovery.zen.ping_timeout:6),可适当减少误判。 - 选举触发。 我们需要在候选集群中的节点的配置文件中设置参数
discovery.zen.munimum_master_nodes的值。
Elasticsearch 原理
参考:2万字详解,彻底讲透 全文搜索引擎 Elasticsearch - 知乎
参考资料
ElasticSearch (ES 从入门到精通一篇就够了) - 不吃紫菜 - 博客园
分布式搜索引擎 Elasticsearch 的架构分析 - 知乎
Elasticsearch8(ES)保姆级菜鸟入门教程_elasticsearch 菜鸟教程-CSDN 博客
[Springboot3 整合 Elasticsearch8(elasticsearch-java)_springboot 整合 es8-CSDN 博客](https://blog.csdn.net/TinpeaV/article/details/149439900?spm = 1001.2014.3001.5501)