
前端专题
TailWindCSS 生成 CSS 的原理
MySQL 专题
索引覆盖和索引下推有什么区别
数据库三大范式是什么
InnoDB 与 MyIsam 有什么区别
TRUNCATE 和 DELETE 有什么区别
数据库的事务机制是怎样的
MySQL 的关联查询是什么
MySQL 的事务隔离级别有哪些
分库分表后 id 主键如何处理
[id 主键的处理问题](../数据库&缓存/MySQL高级/index.md#id 主键的处理问题 )
MySQL 中一条查询 SQL 的执行过程
[SQL 语句的执行过程](../数据库&缓存/MySQL高级/index.md#SQL 语句的执行过程)
如何读懂 SQL 的执行计划
[MySQL 执行计划分析](../数据库&缓存/MySQL高级/index.md#MySQL 执行计划分析)
Union 对比 Union ALL
[UNION 的使用](../数据库&缓存/MySQL基础/index.md#UNION 的使用)
Having 对比 Where
常见的索引原则
如何避免全表查询提升 SQL 查询性能
扩展:表空间是什么
如何优化 ORDER BY 查询
ORDER BY 与 WHERE 查询条件的优化 基本一致
索引覆盖,在索引中包含 ORDER BY 的列,使 MySQL 直接从索引中读取有序数据。
避免数学计算与使用函数
...
WHERE + ORDER BY 联合索引
sql-- 创建复合索引 ALTER TABLE orders ADD INDEX idx_user_order (user_id, order_date); -- 原始语句 索引提升性能 SELECT * FROM orders WHERE user_id =100 ORDER BY order_date DESC; -- 不符合最左前缀匹配原则 order_date 的索引本失效 SELECT * FROM orders WHERE user_id > 100 ORDER BY order_date DESC;调整排序缓冲区大小。原理:增大 sort_buffer_size。
sql-- 临时设置(全局需重启) SET SESSI0N sort_buffer_size = 4*1024*1024; -- 4MB处理分页深度翻页。子查询法解决或标签记录法解决
sql-- 低效(偏移量大时) SELECT * FROM products ORDER BY price LIMIT 100000, 20; -- 优化:用索引覆盖+子查询 SELECT * FROM products JOIN ( SELECT id FROM products ORDER BY price LIMIT 100000, 20 ) AS tmp USING(id);
如何处理 BLOB 和 CLOB 数据
如何在 MySQL 中进行数据脱敏
在 MySQL 中进行数据脱敏(Data Masking)是保护敏感信息(如身份证号、手机号、银行卡号等)的关键手段。
常见手段:
- 字符串替换函数
REPLACE():替换特定字符SUBSTRING() + CONCAT():部分隐藏INSERT():插入掩码字符RIGHT()/LEFT():保留部分字符
- 正则表达式替换(MySQL 8.0+)
- 自定义函数
- 视图,通过视图对外提供脱敏后的数据。
- 应用层脱敏
常见需求
手机号脱敏(保留前 3 后 4 位)
sqlSELECT CONCAT( LEFT(phone, 3), '****' , RIGHT(phone, 4) ) AS masked_phone FROM users;身份证脱敏
sqlSELECT CONCAT( LEFT(id_card, 1), REPEAT('*', LENGTH(id_card) - 5), RIGHT(id_card, 4) ) AS masked_id FROM users;姓名脱敏(保留姓氏)
邮箱脱敏(保留前两位和域名)
银行卡脱敏(保留前后 4 位)
sqlSELECT REGEXP_REPLACE(bank_card,'(\\d{4})(\\d+)(\\d{4})', '\\1***\\3') FROM payments;
GROUP BY 对比 DISTINCT
DISTINCT (去重)用于获取某些列的唯一值列表
作用:确保 SELECT 语句返回的结果集中所有列的组合值都是唯一的。它作用于整个选定的列列表。
聚合函数:在聚合计算前先对该列的值去重。SELECT COUNT(DISTINCT department) FROM employees;
GROUP BY (分组)用于根据某些列分组并统计
作用:将数据集根据一个或多个列的值分成不同的组。其主要目的是为了对每个组应用聚合函数进行汇总计算(如计数、求和、平均值、最大值、最小值)。
聚合函数:GROUP BY 的核心就是与聚合函数一起使用。select subject, avg(score) from student_scores group by subject;
如何使用和优化 LIMIT 子句进行分页(深分页问题)
在 MySQL 中,LIMIT 子句常用于分页查询,但处理不当可能导致性能严重下降(尤其在深分页场景)。
-- 主键 emp_no
-- 查询前10条
select * from employees ORDER BY emp_no limit 10;
-- 分页查询
select * from employees ORDER BY emp_no limit 10000, 10;
-- 等价写法
select * from employees ORDER BY emp_no limit 10 offset 10000;
查询性能差别:
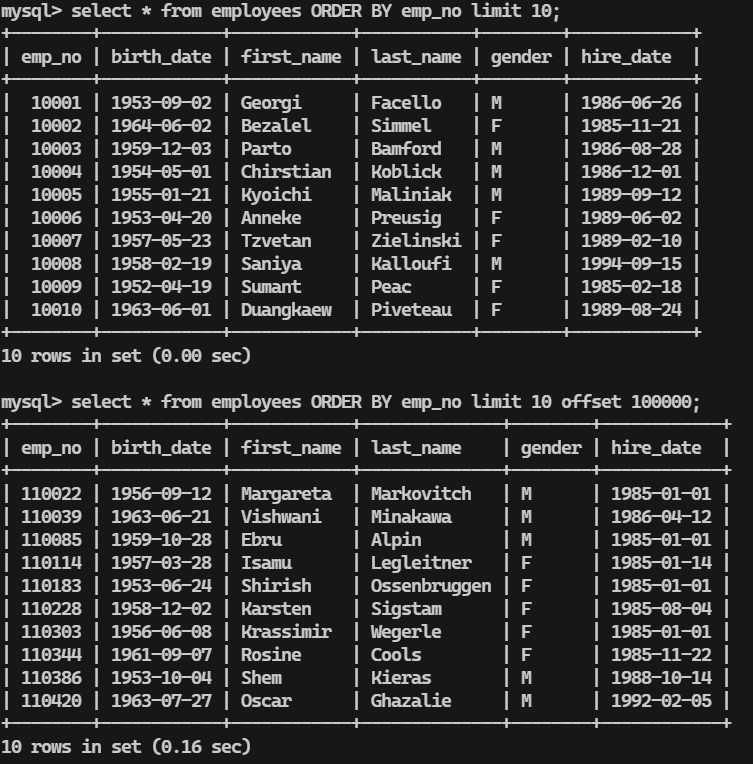
性能问题根源:MySQL 需要扫描 offset + row_count 行数据。丢弃前 offset 行,只返回剩余 row_count 行。深分页(offset 值大)会导致大量无效扫描,性能急剧下降。
如果此时还需要回表,则性能情况会更糟糕
-- 索引 hire_date
select emp_no, hire_date, gender from employees where hire_date > 1986-06-26 order by hire_date limit 10;
select emp_no, hire_date, gender from employees where hire_date > 1986-06-26 order by hire_date limit 10 offset 100000;
查询性能差别:
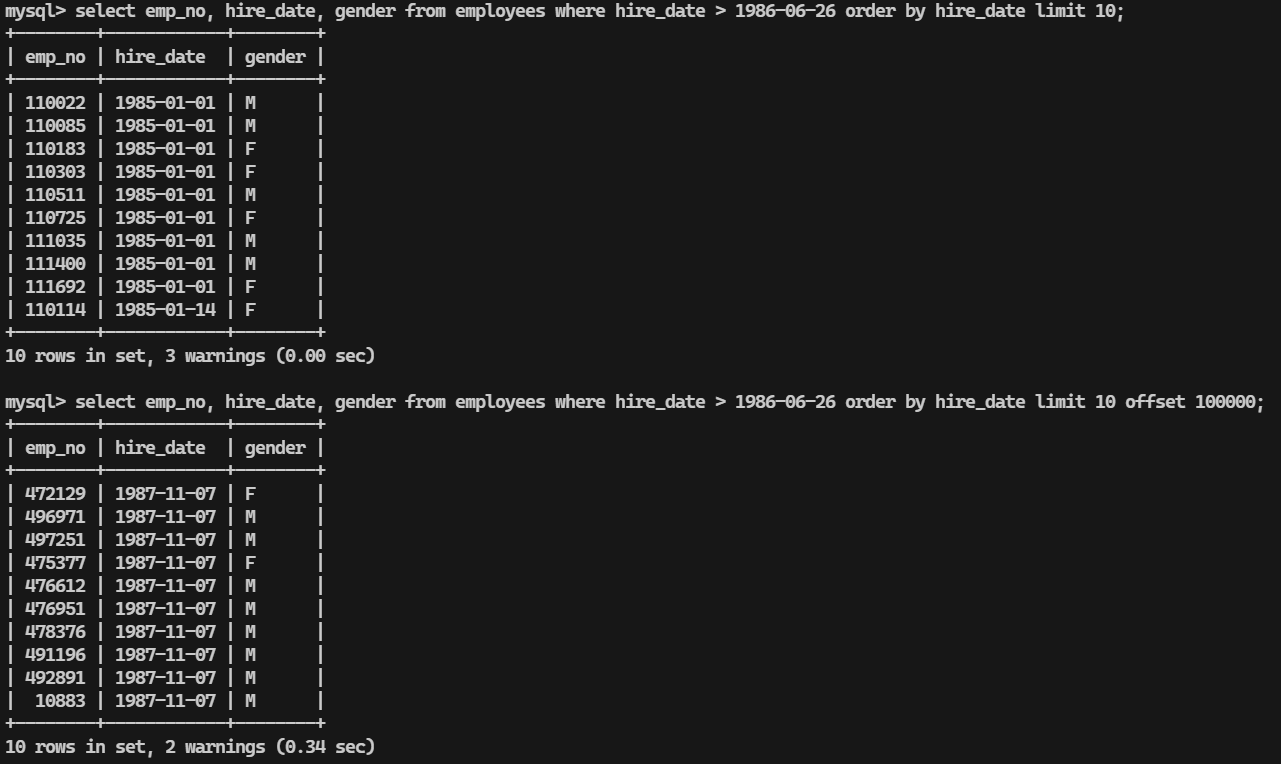
因此建议未处理深分页问题之前,确保查询字段和排序字段被索引覆盖,避免回表。
查询字段和排序字段被索引覆盖,避免回表,减少无效 I/O
sql-- 主键 emp_no 索引列 hire_date select emp_no, hire_date from employees where hire_date > 1986-06-26 order by hire_date limit 10 offset 100000;游标记录法,利用上一页最后一条记录作为起点(需有序且唯一字段,如自增 ID、时间戳+ID 组合),彻底规避深分页
sql-- 主键 emp_no 索引列 hire_date -- 第一页 select * from employees ORDER BY emp_no limit 10; -- 第 n 页,用上一页最后一条记录的 id 作为游标 SELECT * FROM employees WHERE emp_no > 上一页最后一条id-- 避免扫描之前的数据 ORDER BY emp_no LIMIT 10;子查询延迟关联,减少回表次数,减少无效 I/O
sql-- 主键 emp_no 索引列 hire_date -- 原始语句 select emp_no, hire_date, gender from employees where hire_date > 1986-06-26 order by hire_date, emp_no limit 10 offset 100000; -- 子查询延迟关联 select e.emp_no, e.hire_date, e.gender from employees INNER join ( select emp_no, hire_date from employees where hire_date > 1986-06-26 order by hire_date, emp_no limit 10 offset 100000 ) temp using(emp_no);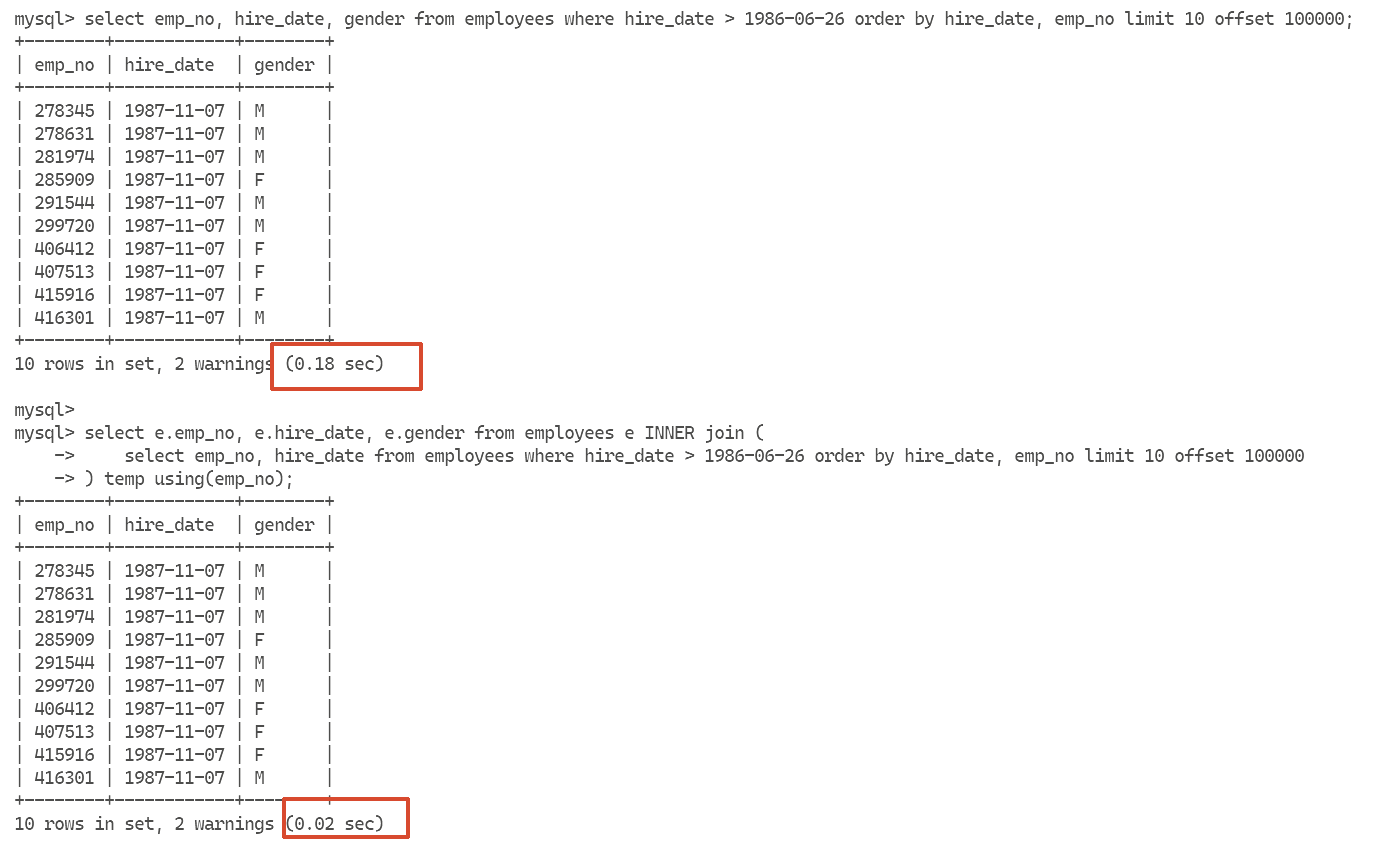
MySQL 为什么弃用缓存
MySQL 查询缓存已在 MySQL 8.0 中被正式移除
原因:
- 性能瓶颈
- 查询缓存的全局锁机制导致高并发场景下多个线程争夺缓存访问权,尤其在多核服务器中成为性能瓶颈,反而降低吞吐量。
- 对于频繁更新的表,缓存反复失效,维护成本远高于收益。、
- 缓存以固定块(query_cache_min_res_unit)分配内存,小查询易产生碎片需定期执行 FLUSH QUERY CACHE 整理,进一步增加负载。
- 缓存命中率低 且不可预测。统计显示,缓存命中率常低于 10%,难以覆盖其管理开销。
- SQL 语句必须逐字节相同(包括空格、大小写)才能命中缓存,细微差异即失效。
- 含
NOW()、RAND()等动态函数的查询无法缓存;事务未提交时,相关表的所有查询均被禁用缓存(InnoDB 特性)。 - 多数应用写操作频繁,导致缓存频繁清空。
- 架构演进与硬件进步
- InnoDB 缓冲池优化:通过优化缓冲池(Buffer Pool)管理热点数据,减少磁盘 I/O,性能已远超查询缓存。
- 硬件性能提升:大内存 SSD 普及使得直接访问数据的效率提高,降低了对结果集缓存的需求。
替代方案:
- 应用层缓存
- Redis/Memcached:将热点数据(如配置表、聚合结果)缓存至独立的内存数据库,避免数据库直接压力,支持分布式部署与精细过期控制。
- 本地缓存组件:如 Guava Cache(Java),减少网络开销。
- 中间件级缓存
- ProxySQL:作为 SQL 代理,提供智能查询缓存(支持按规则缓存、细粒度失效),且无全局锁问题,性能显著优于原生缓存。
- 数据库自身优化
- 优化查询与索引:覆盖索引、避免 SELECT、减少子查询,提升执行效率。
未来趋势:其设计初衷在早期低并发、静态数据场景有效,但现代高并发、动态数据环境中反而成为性能枷锁,同时推动开发者采用解耦的缓存架构(如 Redis/ProxySQL),以实现更高扩展性与稳定性。
slow_query_log
如何备份 MySQL 数据库
物理备份:直接复制数据库的物理文件(数据文件、日志文件、配置文件等)。
- 优点:简单、迅速
- 缺点:只能备份整个数据库实例或独立表空间,文件较大
- 实现工具:系统文件操作命令、MySQL Enterprise Backup、文件系统快照。
逻辑备份:通过查询数据库获取数据结构和内容,生成包含 SQL 语句(如 CREATE TABLE,INSERT)或特定格式(如 CSV)的文本文件。
- 优点:可以选择备份/恢复单个数据库、表,甚至特定的行。文件较小
- 缺点:速度慢,影响线上业务,可能需要手动维护存储依赖关系
- 实现工具:
mysqldump、SELECT .…. INTO OUTFILE
冷备份:在数据库完全关闭的状态下进行备份(物理文件拷贝)。
热备份:在数据库正常运行(提供读写服务)的状态下进行备份。通过 MySQL Enterprise Backup 进行物理热备。通过 mysqldump 进行逻辑热备
温备份:在数据库运行状态下进行,但备份期间会锁定数据库(只读),不允许数据修改。通常通过 FLUSH TABLES WITH READ LOCK 实现全局读锁。
总结:定期 全量备份,逻辑热备 mysqldump,物理热备 XtraBackup;频繁 增量备份,binlog;异地存储,额外存储至非本地服务器。
MySQL Bin Log 的作用
如何进行慢 SQL 优化
设计模式专题
消息推送功能可以用到那些设计模式
以下组合方案也是企业各种功能开发的常见标准手段
策略模式——实现算法与业务的解耦
- 问题:系统需要消息推送,例如需要支持短信、邮箱、微信、飞书等渠道,不同渠道的校验规则和推送逻辑不一样,写死单个渠道或者使用
if-else不利于后续新增新的推送渠道逻辑。 - 解决:定义一个统一的
notifyService接口,不同渠道定义具体的实现类xxxNotifyService,接口上层只依赖接口调用,不绑定具体的推送渠道实现,可随时切换推送方式。
- 问题:系统需要消息推送,例如需要支持短信、邮箱、微信、飞书等渠道,不同渠道的校验规则和推送逻辑不一样,写死单个渠道或者使用
模板方法模式——固定通用流程,开放差异化步骤
- 痛点:各渠道的核心逻辑不同,但整体的执行流程基本一致,例如依次为参数校验、执行推送、记录日志等,如果每个实现类都重复写一遍完整流程,存在代码冗余,不利于后期维护。
- 解决:在接口和实现类之间,新增一层抽象父类
notifyAbstractService, 实现具体的send模板方法用于定义统一业务流程的骨架 ,抽取具有差异性的参数校验、执行推送等为抽象方法交给不同渠道的子类重写实现,记录日志这种统一逻辑直接封装复用。
简单工厂模式——根据标识,精准获取对应实现
痛点:业务层每次都要通过传入的渠道标识参数(如
channel=email)去匹配具体的实现类,需要大量if-else判断解决:自定义渠道注解,每个渠道具有唯一的标识,项目启动时自动扫描所有实现类预加载,并将所有实现类实例及其标识一一映射,存入 Map 容器中,业务调用时根据传入的渠道标识,工厂类即可从 Map 中直接获取对应服务实例,消除了大量的 if-else 判断。
java// 自定义注解如下 @Target(ElementType.TYPE) @Retention(RetentionPolicy.RUNTIME) public @interface ChannelType { String value(); // 唯一标识,如 "email", "sms", "wechat" }扫描实现类存入 Map 容器的过程 可以通过 ApplicationContextAware 来实现
JVM 专题
简述一下 JVM 内存区域(运行时数据区域)
也有说是内存模型的,但 内存模型 更多是指在多线程环境下,线程如何与主内存和工作内存交互,如何保证内存可见性、有序性和原子性。
这里讲的应该是 JVM 的运行时数据区域
说说堆和栈的区别
| 对比维度 | 栈 | 堆 |
|---|---|---|
| 线程模型 | 线程私有的内存区域,天然线程安全 | 线程共享的内存区域,需要使用同步机制来保证 并发访问的正确性,避免线程安全问题。 |
| 生命周期 | 每个线程创建都会分配一个独立的栈,栈的生命周期与线程相同 | 在 JVM 启动时创建,整个 JVM 只有一个堆 |
| 存储内容 | 主要用于存储方法执行时的栈帧,每个栈帧存储了局部变量表、操作数栈、动态链接、方法出口。 | 主要用于存储对象实例。 |
| 内存管理 | 栈帧与方法的作用域绑定,方法调用时,对应的栈帧被压入栈顶;方法执行结束(正常返回或抛出异常)时,栈帧被弹出销毁。不涉及垃圾回收 (GC)。 | 由垃圾回收器(Garbage Collector, GC)管理。对象创建时分配,对象不可达时,在某个不确定时刻进行回收。 |
| 错误与异常 | StackOverflowError 当线程请求的栈深度超过虚拟机允许的最大深度 OutOfMemoryError 如果栈可以动态扩展,但在扩展时无法申请到足够的内存。 | OutOfMemoryError 没有足够堆内存分配新对象或者 GC 回收问题 |
简述 Java 对象的结构
如何判断对象可以被回收
有哪些垃圾收集算法及其应用
JVM 为什么使用元空间替换了永久代
JVM 中的即时编译器(JIT)如何工作
内存屏障如何保证指令的执行顺序
内存屏障(Memory Barrier)是一种 CPU 指令或 JVM 层面的同步机制,用于控制特定指令的执行顺序,以及保证内存可见性,防止编译器、CPU 的指令重排序优化对多线程程序正确性产生影响。
处理器内存访问策略/硬件内存模型:
- 强内存模型:规则严格,处理器基本按照程序代码顺序执行内存读写,仅允许极少的重排序(如 x86 仅允许 Store→Load 重排)
- 弱内存模型:规则宽松,处理器和编译器可对 Load/Store 进行大范围重排,性能优化空间大,但需显式同步。(典型架构有 ARM、RISC-V。)
内存屏障的 CPU 指令存在 CPU 架构差异:
- x86:提供
lfence(读屏障)、sfence(写屏障)、mfence(全屏障)。 - ARM:提供
dmb、dsb、isb等指令。 - RISC-V:提供
fence指令。
在 JVM 规范中,逻辑上将内存屏障分为 4 种(基于操作类型组合)
- LoadLoad 屏障:确保屏障前的加载指令 (Load)先于屏障后的加载指令(Load)执行。
- StoreStore 屏障:确保屏障前的存储指令(Store)先于屏障后的存储指令(Store)执行。
- LoadStore 屏障:确保屏障前的加载指令(Load)先于屏障后的存储指令(Store)执行。
- StoreLoad 屏障:确保屏障前的存储指令(Store)先于屏障后的加载指令(Load)执行,同时会刷新 CPU 缓存,保证存储操作的结果对其他线程可见。这是最强大的一种屏障,开销也较大。
JVM 会根据 Java 内存模型(JMM)的规范,在生成字节码时插入内存屏障,以保证多线程环境下的指令执行顺序和内存可见性。具体体现在以下场景:
- JVM 会在 volatile 变量读写操作前后插入内存屏障
- 写操作(Store)后插入 StoreStore 屏障和 StoreLoad 屏障,确保该写操作的结果对其他线程可见(通过刷新缓存)。
- 读操作(Load)前插入 LoadLoad 屏障和 LoadStore 屏障,防止读操作被重排序到前面的指令。
- 进入 synchronized 块时,JVM 会插入类似 LoadLoad、LoadStore 的屏障,确保读取到共享变量的最新值; 退出 synchronized 块时,会插入类似 StoreStore、StoreLoad 的屏障,确保当前线程的修改被其他线程可见。
- 锁和并发工具类其内部实现也依赖内存屏障来保证线程安全,JUC 中的锁(如 ReentrantLock)、原子类(如 AtomicInteger)都是通过 Unsafe 类的 putOrderedXXX、getAndAddXXX 等方法间接使用内存屏障。
如何排查和解决 JVM 内存泄漏问题
jps查看进程的 pid- 确认内存泄漏
- 通过工具(JConsole、VisualVM、JMC)观察堆内存各区域(Eden、Survivor、Old Gen)的使用趋势,判断是否存在内存无法释放的情况。
- 分析 GC 日志: 开启 GC 日志
-XX:+PrintGCDetails-XX:+PrintGCTimeStamps查看 Full GC 频率、耗时及内存释放情况。若 Full GC 后老年代内存占用仍很高,可能存在泄漏。
- 捕获内存快照
jmap -dump:format=b,file=heapdump.hprof <进程ID>- 内存溢出异常自动转储
-xx:+HeapDumpOnOutOfMemoryError-XX:HeapDumpPath= jhsdb jmap --binaryheap --dumpfile heap.hprof --pid <进程ID>jcmd 20688 GC.heap_dump ./heap_dump.hprof
- 分析内存快照
- 通过工具(IDEA、VisualVM)分析快照,定位泄漏对象:识别异常对象:查看哪些对象数量异常多,且生命周期不应过长(如频繁创建但未释放的对象)。
- 查看引用链:分析对象被哪些 GC Root 引用(如静态集合、线程局部变量等),导致无法被回收。
- 根据泄漏对象的类型和引用链,找到对应的代码逻辑,常见问题包括:
- 静态集合未清理(如 static List 不断添加元素)
- 未关闭的资源(如数据库连接、IO 流)
- 线程池核心线程持有大对象引用
- 缓存未设置过期策略或清理机制(如使用弱引用)
CMS 垃圾回收器的工作流程和优缺点
类初始化和类加载的时机和区别
栈内存会出现的问题与预防方案
直接内存和堆内存有何区别-如何管理
如何调优 JVM 参数以提高应用性能
堆内存配置
- 设置初始和最大堆内存(建议设为相同值避免动态调整)
-Xms4g -Xmx4g - 指定新生代大小(建议占堆 1/3~1/4)
-Xmn1g - 新生代/老年代比例(默认 1:2)
-XX:NewRatio=2 - Eden/Survivor 区比例(默认 8:1:1)
-XX:SurvivorRatio=8
- 设置初始和最大堆内存(建议设为相同值避免动态调整)
垃圾回收器选择
- G1 回收器:平衡吞吐与延迟
-XX:+UseG1GC -XX:MaxGCPauseMillis=200 - CMS 回收器:低延迟场景
-XX:+UseConcMarkSweepGC - 并行回收器:高吞吐场景
-XX:+UseParallelGC -XX:GCTimeRatio=95
- G1 回收器:平衡吞吐与延迟
元空间配置
- 设置初始和最大元空间内存
-XX:MetaspaceSize=256m -XX:MaxMetaspaceSize=256m
- 设置初始和最大元空间内存
栈空间配置
- 线程栈深度:
-Xss256k(减少线程内存占用)
- 线程栈深度:
日志监控与转储配置
- GC 日志记录:
-Xloggc:/path/gc.log -XX:+PrintGCDetails - OOM 自动转储:-
XX:+HeapDumpOnOutOfMemoryError -XX: HeapDumpPath=/var/...
- GC 日志记录:
调优案例实践
- 电商系统优化:通过
-Xmx12g -XX:+UseG1GC将 Full GC 频率从每小时 5 次降至每天 1 次 - Tomcat 调优: 调整
-Xms120m -Xmx120m使 Full GC 次数降低 80% - 内存泄漏处理:用
WeakReference优化缓存设计避免 OOM - 调优需结合 监控工具(基础工具/可视化工具)
方法区的定义以及演变
try-catch-finally 结构在字节码层面是如何实现的
JVM 使用一种称为异常表(Exception Table)的机制来处理异常,这是一种高效、结构化的方式,与源代码中的 try-catch 块—对应。
抛出异常
当程序中使用 throw 关键字抛出一个异常时,或者在执行过程中 JVM 检测到异常情况(如 NullPointerException, ArithmeticException),JVM 会创建一个异常对象(java.lang.Throwable 或其子类的实例)。然后,JVM 立即停止当前方法的正常执行流程,开始查找能够处理这个异常的异常处理器(Exception Handler)。
异常分发
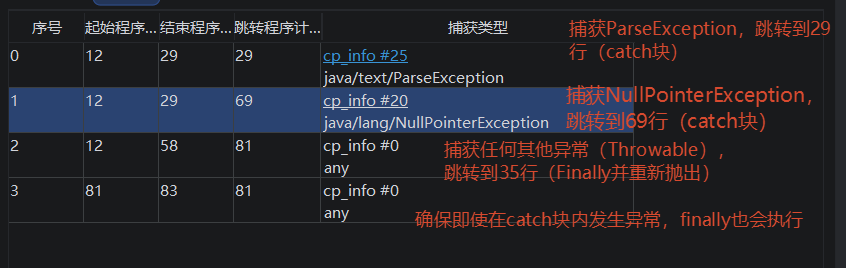
JVM 首先查看当前方法(当前栈帧)的异常表。异常表是 class 字节码文件中的一部分,它为方法中的一段字节码(try 块)定义了对 应的异常处理器(catch 块)。它的每个条目包含四个信息:
- 起始位罩(start_pc)try 块开始的字节码偏移量。
- 结束位置(end_pc):try 块结束的字节码偏移量。
- 处理器位置(handler_pc):catch 块开始的字节码偏移量。
- 捕获的异常类型(catch_type):该条目负责捕获的异常类的常量池索引。
如果是 0(即 finally 块),则表示捕获所有异常,用于实现 finally 逻辑。JVM 会遍历异常表,检查当前抛出异常的指令位置是否在某个条目的
[start_pc,end_pc)范围内。如果是,并且抛出的异常类型是 catch_type 或其子类,则 JVM 就将控制流转移到该条目指定的 handler_pc 处开始执行(即执行对应的 catch 块)。重要:异常表的匹配是顺序敏感的。字节码编译器会按照源代码中 catch 块的书写顺序来生成异常表条目。因此,如果先捕获 Exception,再捕获 IOException,后者将永远不会生效。
未找到处理器的处理
如果在当前方法的异常表中没有找到匹配的异常处理器,JVM 会完成当前方法的执行(弹出当前栈帧),并回到调用该方法的地方(上一个栈帧),然后在上一个桟帧的异常表中重复上述查找过程。这个过程会一直沿着调用栈向上进行(即“栈展开”或“栈回退”),直到找到合适的异常处理器。
如果一直回溯到 main 方法也没有找到,则该线程会终止,异常信息会打印到控制台(即我们常见的异常堆栈跟踪信息)。
try-catch-finally 在字节码层面的实现
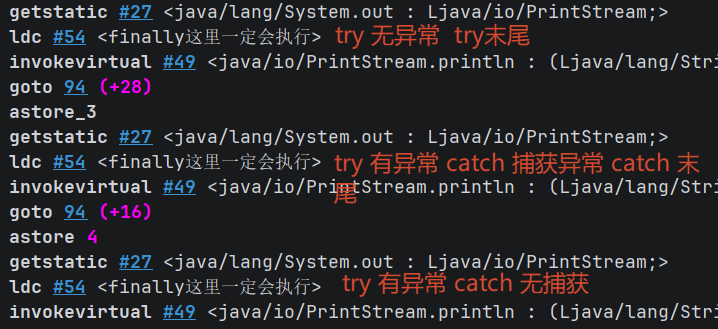
现代 JVM(JDK1.6 及之后)的实现方式:将 finally 块的代码复制多份,插入到所有可能的退出路径后面。
package com.tintin.exception;

import java.text.ParseException;
import java.text.SimpleDateFormat;
import java.util.Date;

public class TryCatchFinallyDemo {

    public static void main(String[] args) {
        SimpleDateFormat simpleDateFormat = new SimpleDateFormat("yyyy-MM-dd");
        Date date = null;
        try {
            date  = simpleDateFormat.parse("2026-8-21"); // 成功的例子
//            date  = simpleDateFormat.parse("2020年10月06日"); // 失败的例子
            throw new NullPointerException("抛出一个空指针异常"); // 手动抛出的例子
        } catch (ParseException e) {
            System.out.println("出现异常,打印异常信息:" + e.getMessage());
        } catch (NullPointerException e) {

        } finally {
            System.out.println("finally这里一定会执行");
        }
        System.out.println("因为捕获了异常,所以这里一定会执行");
    }

}
JVM 是什么为什么需要 JVM
JVM 首先是 一个规范,由 Oracle 公司发布的官方标准文档 JVM Specification,任何公司或组织,按照这个规范实现的虚拟机都可以称为 JVM(例如 Oracle 的 HotSpot VM,IBM 的 J9 VM, Azul 的 Zing VM,BEA 的 JRockit),常见的 JDK(Java Development Kit)中的 HotSpot VM 就是 JVM 的 一个具体实现。当你用 java 命令运行一个编译后的 Java 程序(.class 文件),操作系统就会启动一个 JVM 进程。这个进程就是程序的 一个运行时环境。每个 Java 程序都运行在自己独立的 JVM 实例中。
核心工作流程:Java 源代(.java 文件)被编译器 javac 编译成一种与特定平台无关的字节码(.class 文件),JVM 负责读取、验证并执行这些字节码。同时会将字节码即时编译(JIT Compilation)成所在宿主机器(不同平台)的本地机器码(Native Code)来执行。
重要性:
- 平台无关性,“Write Once,Run Anywhere”
- 自动内存管理,垃圾回收(Garbage Collection)
- 在 C/C++中,程序员需要手动使用 malloc/free 或 new/delete 来申请和释放内存极易出现内存泄漏或野指针等问题。
- JVM 内置了垃圾回收器(GC),会自动监控 Java 程序创建的对象,并在对象不再被使用时自动回收其占用的内存。这极大地简化了编程,降低了内存管理的复杂性,提高了程序的健壮性和安全性。
- 提供稳定的安全的运行时环境
- 字节码验证
- 库支持
- 本地方法支持
- 解释与编译(JIT 编译与代码优化)并存
- 不仅仅是解释执行字节码,还会监控程序的运行,找出热点代码(被频繁执行的方法或循环),然后将这些热点代码动态编译成本地机器码,并进行了各种深度优化(如方法内联、逃逸分析等)。
- 后续直接执行高效的本地字节码。
JVM 如何进行类卸载
为什么需要类卸载:
主要目的是为了节省内存,尤其是在需要动态加载和卸载大量类的场景下,如:应用服务器:如 Tomcat,每个 Web 应用都有自己的 WebApp ClassLoader。当应用被热部署、重新加载或卸载时,需要卸载掉该应用对应的所有类,以防止内存泄漏。动态生成代理:大量使用 CGLb、ASM 等字节码技术动态生成类。如果不进行类卸载,这些“废弃”的类会一直占据方法区(元空间),最终导致 OutOfMemoryError: Metaspace.
类卸载的判定条件:JVM 使用可达性分析算法来判断一个对象是否存活,这也包括 Class 对象。
Class 对象的引用情况:
- 它的类加载器(ClassLoader) 直接持有其加载的所有类的 Class 对象的引用。
- 该类如果被启动类加载器(Bootstrap ClassLoader)加载,它几乎永远不会被卸载,因为 Bootstrap ClassLoader 本身是 JVM 的一部分,不会被回收。
- 该类如果被应用类加载器(App ClassLoader)加载,只要 JVM 还在运行,AppClassLoader 就一直是可达的(被 System ClassLoader 引用),因此这些类也几乎不会被卸载。
- 使用自定义类加载器,才有可能断开引用,例如在 Tomcat 中,一个 Web 应用由 WebAppClassLoader 加载,当应用被卸载时,Tomcat 会销毁这个 WebAppClassLoader 实例, 销毁后, WebAppClassLoader 实例本身不再被任何 GC Root 引用,变得不可达,因此它本身成为了可回收的垃圾。随着 WebAppClassLoader 被回收,它加载的所有类的 Class 对象也失去了一个重要的强引用,此时这些 Class 对象才有可能被回收(堆中无对应实例,且不被其他地方引用)。
如何监控类卸载
- JVM 参数:使用
-X:+TraceClassLoading和-XX:+TraceClassUnloading在控制台输出类加载和卸载的日志。 - 工具监控:使用 jconsole, jvisualvm 或更强大的 Java Mission Control 等工具,可以监控 Metaspace 的使用情况,观察其大小在 Full GC 后是否下降,从而间接判断是否有类被卸载。
clinit 和 init 的区别
<clinit>() 和 <init>() 方法是 Java 编译器在编译期自动生成的两个特殊方法,它们分别对应了类的初始化和对象的实例化这两个完全不同的过程。
<clinit>()方法-类构造器方法- 作用:用于执行类的初始化。JVM 在首次主动使用一个类时(具体看类初始化的时机),会先加载该类,然后执行该方法的代码来完成类的初始化。
- 执行时机
- 方法内容:由编译器自动收集类中的所有静态变量的赋值语句和静态代码块合并而成。合并的顺序取决于在源文件中出现的先后顺序。
- 线程安全:一个类或接口的
<clinit>()方法最多只执行一次,JVM 会保证一个类的<clinit>()方法在多线程环境中被正确地加锁、同步。这意味着如果多个线程同时去初始化一个类,只有一个线程会去执行该方法,其他线程会阻塞等待。 - 继承关系:不需要显式调用父类的
<clinit>()。JVM 会保证在执行一个类的<clinit>()方法之前,其父类的<clinit>()方法已经执行完毕。但接口的<clinit>()执行的唯一条件是默认方法的执行,不会因为初始化实现类或子接口而初始化父接口。
<init>()方法-实例构造器方法- 作用:用于执行对象实例的初始化。它对应的是 Java 中的构造函数(Constructor)。在每次使用 new 关键字创建对象实例时,JVM 都会在堆上分配完内存后调用该方法。
- 执行时机:在每次创建新的对象实例时调用。一个类的
<init>()方法可以被多次执行(每创建一个新对象就执行次)。 - 方法内容:实例变量的显式赋值操作;实例代码块(instance blocks)中的代码;构造函数体中的代码
- 线程安全:不具备内在的线程安全性。如果在构造函数中操作共享数据,需要开发者自己进行同步。
- 继承关系:子类的
<init>()方法必须首先调用父类的<init>()方法(如果构造函数中没有显式写出super(),编译器会自动加上super(),进而调用父类的<init>()方法)
逃逸分析和栈上分配、标量替换的关系
逃逸分析 是 JVM 在编译阶段(Just-In-Time Compiler,JIT)进行的一种高级优化技术。如果经过逃逸分析,发现一个对象没有发生任何逃逸那么 JVM 就可以对这个对象实施一些极其高效的优化,例如 栈上分配 和 标量替换。
程序计数器会发生 OOM 吗
程序计数器是唯——个在《Java 虚拟机规范》中没有规定任何 OutOfMemoryError(内存溢出错误)情况的区域。
字符串常量池和运行时常量池
TLAB 是什么
如何自定义类加载器
注意遵守 双亲委派模型
G1 垃圾收集器的触发时机和工作流程
[Garbage First 收集器](../Java/JVM/index.md#Garbage First 收集器)
Java 的四种引用类型的特点和应用场景
分配失败、担保失败
首先,对象分配优先在 Eden 区分配,若 Eden 区无法容纳新的对象,则属于 分配失败,触发 Minor GC。
Minor GC 执行前需要进行预检,即确保此次 Minor GC 为安全操作(老年代最大可用的连续空间大于新生代所有对象总空间),否则要么进行风险尝试操作,要么直接 Full GC。
- 若为安全操作,则 Minor GC 绝对能执行成功,大对象直接进入老年代避免空间碎片导致 Full GC,长期存活的对象将 晋升 进入老年代,复制时 survivor 空间不足也会担保转移至年老代。
- 若为风险操作,则 Minor GC 过程中将会由于老年代连续空间不足,发生 担保失败(Handle Promotion Failure) 的情况,进行 Full GC。
了解 JVM 的向量化 API(Vector API)
向量 API 是用于高效向量计算和数据向量化的接口,可应用于 Java 并行计算和 AI Embedding 服务。
Java 专题
JVM、JRE 和 JDK 之间的关系是什么?
Java8 的新特性
集合与流有何不同
集合(Collection):是一个 内存中的数据结构,它负责存储和持有所有数据。集合中的每一个元素都必须先被计算出来并存储在内存中后才能加入到集合里。它的核心是数据本身。
流(Stream):是一种来自数据源(如集合、数组)的元素序列,它支持聚合操作,用于计算和处理这些数据。流本身不存储数据,更像一个高级的迭代器(Iterator),其核心是 计算。
抽象类和接口的异同
都无法实例化。
| 对比维度 | 抽象类 | 接口 |
|---|---|---|
| 方法 | 抽象方法、具体方法(静态方法和实例方法) | 抽象方法,JDK1.8 以后有静态方法和默认方法 |
| 属性 | 静态变量、实例变量、常量 | 静态常量 public static final |
| 构造器 | 有构造方法,类实例化时调用。 | 没有构造方法。 |
| 继承 | 单继承(一个类只能继承一个抽象类) | 多实现(一个类可以实现多个接口),且接口与接口之间可以多继承 |
| 访问修饰符 | 任意访问修饰符 | 方法默认 public |
| 语义 | 表示 "事物是什么”的抽象 | 表示”事物具什么有能力" 的抽象 |
重载与重写的区别
HashMap 的变化
HashMap LinkedHashMap Hashtable ConcurrentHashMap 的区别
都是 Map 的接口实现类
HashMap:
- 继承自 AbstractMap
- 数组+链表+红黑树(JDK 1.8),线程不安全,允许 key 或 value 为 null,无序、高效,基于哈希思想的哈希表结构。链表长度大于 8 且数组长度大于 64 时,链表树化成红黑树,将查询效率从
O(n)提升至O(log2 n)。 - 为什么不是二叉查找树,因为二叉查找树极端情况下也会退化成链表。
- 为什么不是 AVL 树(自平衡二叉查找树),因为 AVL 树过于追求平衡导致每次插入删除操作都要旋转多次树,时间复杂度为
O(n)。而红黑树不追求树绝对的平衡,通过O(1)次 颜色变换和旋转即可,大大提升了插入和删除操作的效率。
LinkedHashMap:
- 继承自 HashMap
- 在 HashMap 的基础上额外独立地维护了一条双向链表,串联起所有 Map.Entry
- 主要用于按照预期的顺序遍历所有元素。
accessOrder默认为false链表元素的访问顺序等同于插入的顺序,使 ``accessOrder= true则每次插入或访问元素的操作都会使元素移动到链表的末尾,当需要移除最久未使用的元素时,只需直接操作头部节点,时间复杂度为 O(1)。
Hashtable
- 继承自 Dictionary
- 古老的 Map 实现类,数组+链表,通过
synchronized实现线程安全,不允许 key 或 value 为 null。 - 获取元素位置时没有混合扰动处理,直接使用键的
hashCode()值 - 锁的粒度太大,性能低下,已被 ConcurrentHashMap 取代。
ConcurrentHashMap
- 继承自 AbstractMap
- 数组+链表+红黑树(JDK 1.8),线程安全,不允许 null 键和 null 值(避免并发歧义)
- JDK 1.7 时,采取细粒度的加锁机制 分段锁 (Lock Striping),整个哈希表被分为多个段 Segment,每个段都独立锁定。读取操作不需要锁,写入操作仅锁定相关的段。
- JDK 1.8 时,进一步缩小锁粒度,取消了 Segment 分段锁,采用 CAS + synchronized(只锁住当前链表或红黑树的头节点) 来保证并发安全性。
sleep() 和 wait() 的区别
sleep():Thread 类的方法,不释放当前线程持有的锁,超时后自动唤醒,或者 interrupt(),用于暂停当前线程的执行,与线程同步无关。
wait():Object 类的方法,释放当前线程持有的锁,必须由其他持有同一对象锁的线程调用 notify() 或 notifyAll() 或者超时后唤醒,用于线程间的通信和协调,必须在同步代码块中使用。
List Vector LinkedList 的区别
String StringBuilder StringBuffer 的区别
[String、StringBuffer 和 StringBuilder 的异同](../Java/Java编程基础/index.md#String、StringBuffer 和 StringBuilder 的异同)
equals() 和 == 对比
[Java 中 == 和 equals()有哪些区别 ](../Java/Java 编程基础/index.md#Map )
如何重写 equals() 和 hashcode()
消息队列专题
Kafka 为什么快
- 缓存机制 Cache Filesystem Cache PageCache 等缓存机制
- 顺序写,由于现代的操作系统提供了预读和写技术,磁盘的顺序写大多数情况下比随机写内存还要快
- 零拷技术,Zero-copy 零拷技术减少拷贝次数
- 批量处理,Batching of Messages 合并小的请求,然后以流的方式进行交互,直顶网络上限。
- Pull 模式长轮询,使用拉取消息模式进行消息的获取消费,最大化利用消费段消费能力。通过长轮询实现了近实时的效果,又大幅减少了无效的空轮询。
Kafka 有哪些消费者分区策略
Kafka 有哪些消息分区策略
Kafka 中的 Zookeeper 的作用和替代方案
Kafka 如何防止消息重复消费
首先要明白由于网络问题,重复消费不可避免 可能原因: 1.消费线程中断导致消费后的数据 offset 没有提交 2.消费消息后 offset 提交时 partition 中断 3.消费超时或者调整 partition 重新 rebalance 重平衡时
- 配置数量和时间:减少每次拉取的消息记录数
spring.kafka.consumer.max-poll-records=100和增大 poll 之间的时间间隔spring.kafka.listener.poll-timeout=50避免 Kafka 服务端处理不来。 - 异步处理手动提交:拉取到消息之后在空闲时间段异步处理(保证成功消费)
spring. kafka. consumer. enable-auto-commit=false - 处理记录:可以通过在应用程序中维护一个已处理消息的记录,或者使用外部存储(如数据库)来实现消息的去重。在消费消息前,可以先检查消息是否已被处理过 。
- 使用 low-level-api:消费者自己维护 offset 等值,可以实现对 Katka 的完全控制,难度较大。
技术场景问题
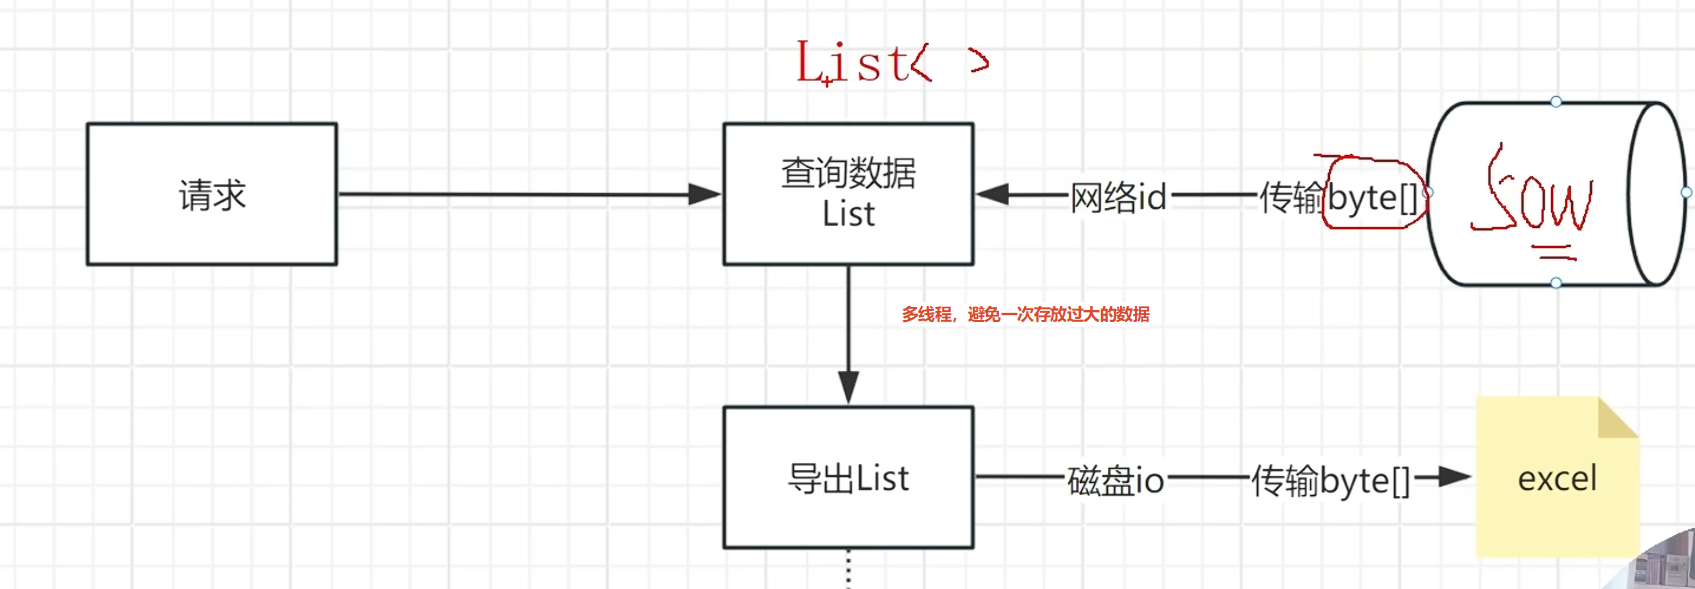
百万数据如何导出 excel 避免 OOM
多线程,每个线程只查询 25 万条,每个线程操作完即释放字节数组。
如何定位线上 OOM
- 一次性申请太多对象——内存溢出
- 例如一次性从数据库中读取大量数据
- 内存资源耗尽,对象未释放——内存泄漏
- 例如不断创建线程——通过线程池解决
- 例如不断创建 xxxConnection
- 堆内存本身就不够大——内存不足
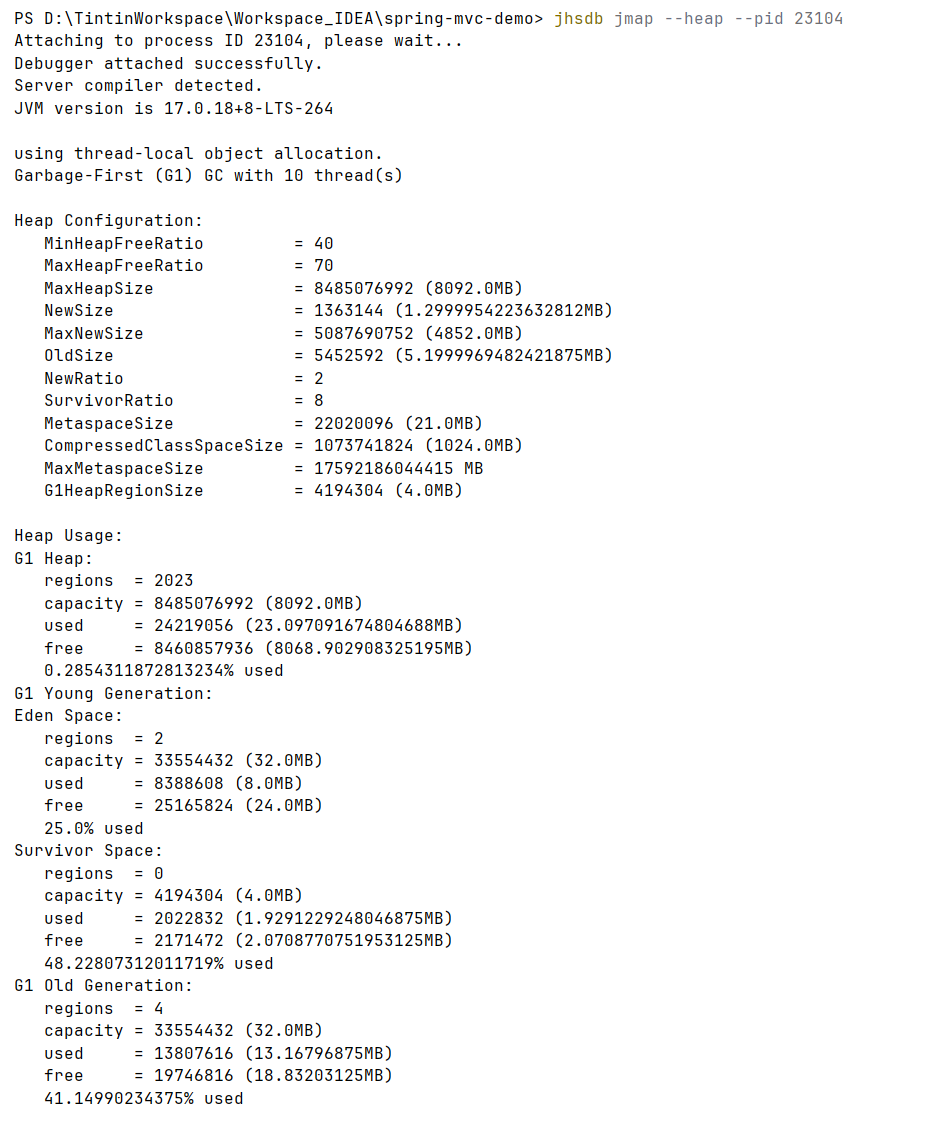
jmap -heap <pid>jdk8jhsdb jmap --heap --pid <pid>jdk9+
如何定位出现内存溢出和内存泄漏问题的代码位置
情况一:系统已经 OOM 挂了
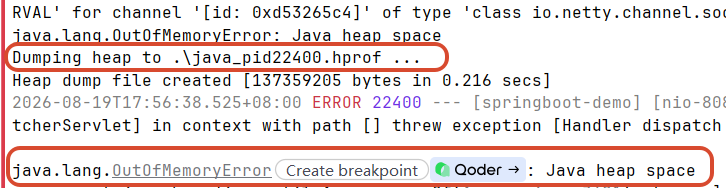
解决方案:提前设置 -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=


测试
java -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=.\ -Xms100m -Xmx100m -jar .\target\springboot-demo-0.0.1-SNAPSHOT.jar@Controller
public class OOMController {
static class OOMObject {
}
@GetMapping("/oom")
public String oom() {
List<OOMObject> list = new ArrayList<OOMObject>();
while (true) {
list.add(new OOMObject());
}
}
}
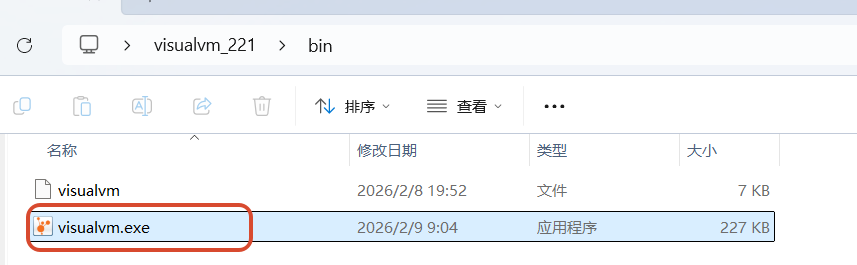
下载 VisualVM,解压通过管理员打开
载入 Dump 文件定位 OOM
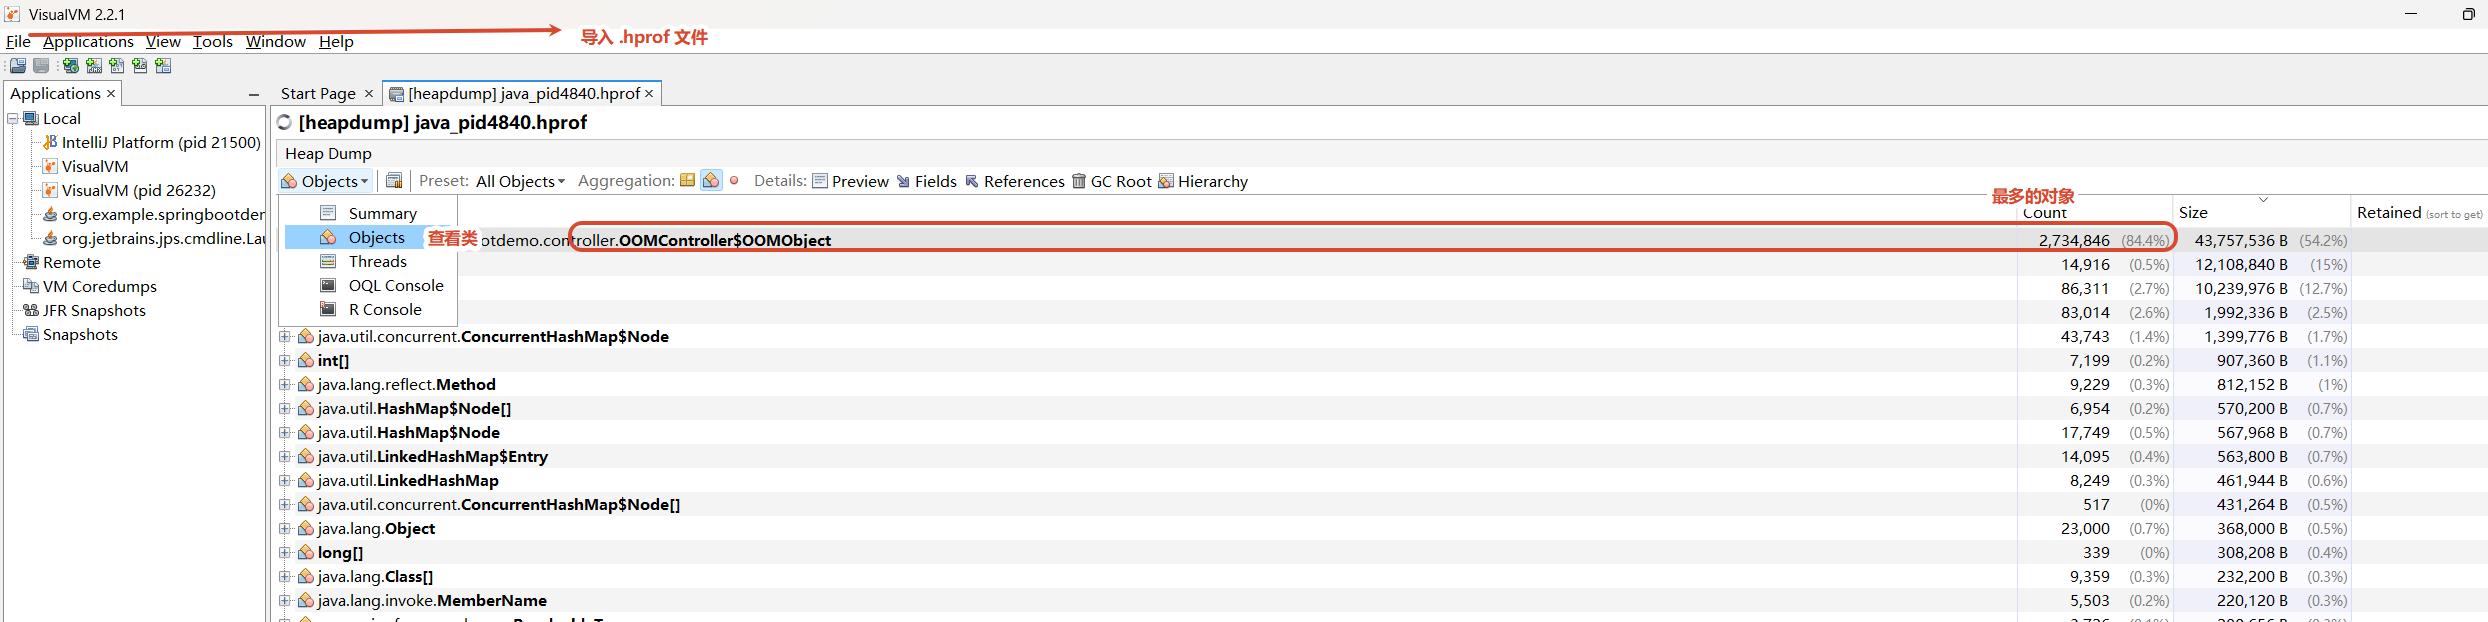
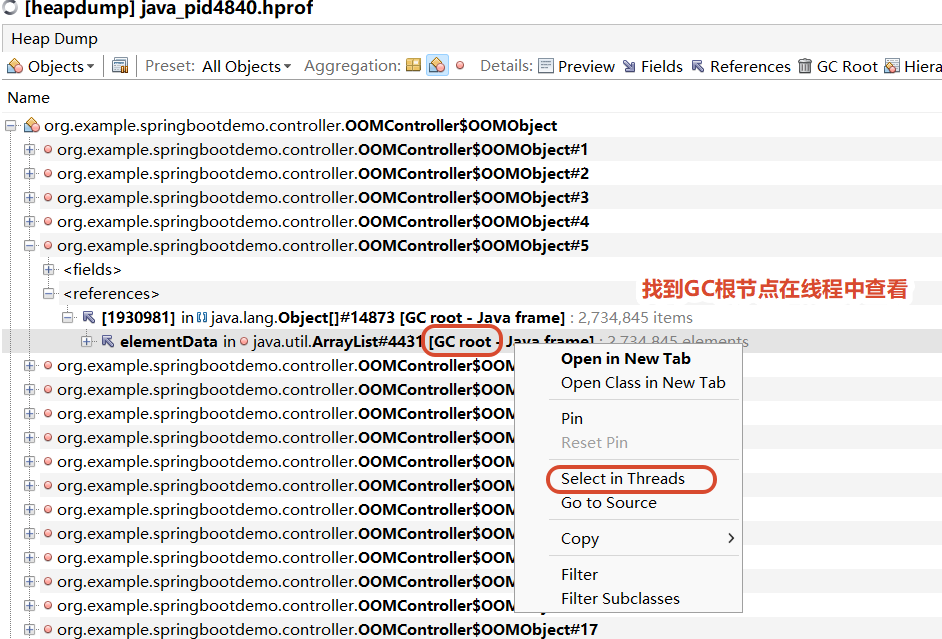
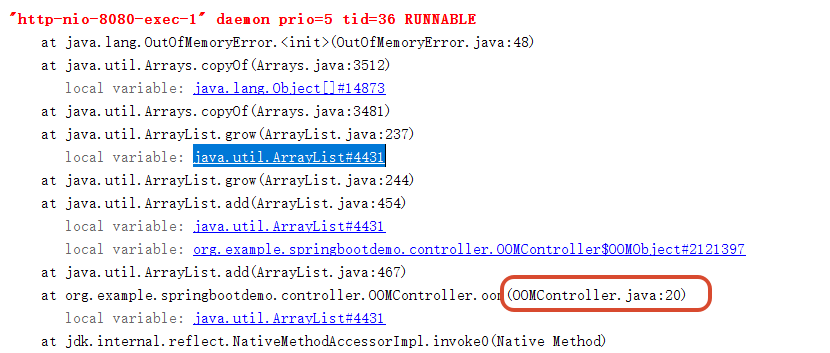
情况二:系统运行中还未 OOM
jmap -histo:live 4840查看存活对象数量排序jmap -dump:format=b,file=xushu.hprof 8124导出 dump 文件- Arthas
线上突发 CPU 飙高怎么定位和解决
top 命令找到占用最高的进程
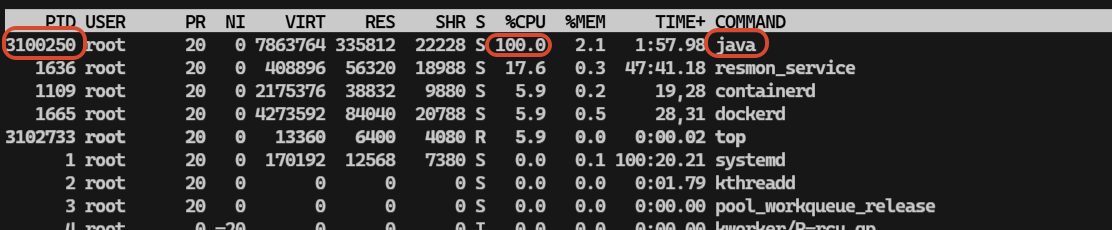
top -H -p <进程pid> 找到占用最高的线程
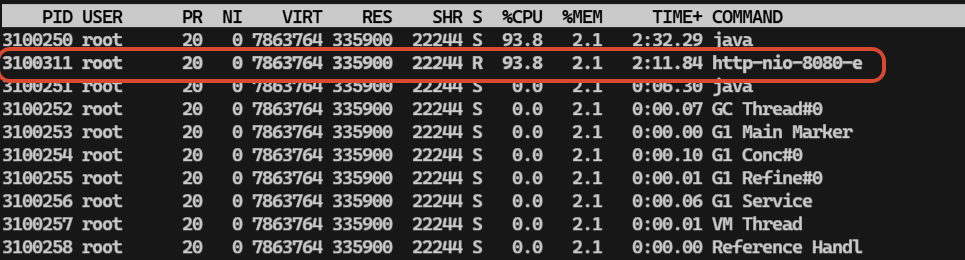
printf '0x%x\n' 3100311 将线程 ID 转换为 16 进制
jstack <进程pid> | grep <16进制线程pid> -A 20 通过 jstack 工具显示 20 行
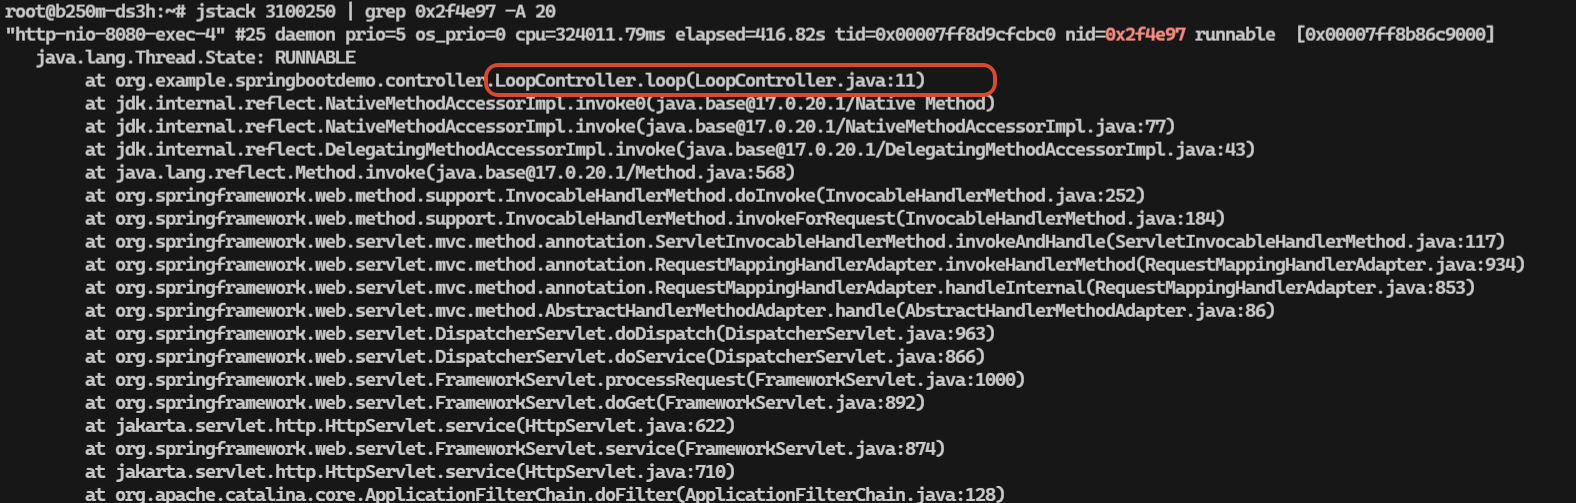
定位到一段死循环的问题代码
@RestController
public class LoopController {

    @GetMapping("/loop")
    public String loop() {
        while (true) {
        }
    }

}
如何定位&避免死锁
@Data
@AllArgsConstructor
@NoArgsConstructor
public class Account {

    private String name;
    private double balance;

    public void transfer(Account target, double money) {
        synchronized (this) {
            System.out.println("Transfer begin.");
            try {
                TimeUnit.SECONDS.sleep(2);
            } catch (InterruptedException e) {
                throw new RuntimeException(e);
            }
            synchronized (target) {
                this.balance -= money;
                target.balance += money;
                System.out.println("Transfer complete.");
            }
        }
    }
}public class DeadLockDemo {
public static void main(String[] args) {
Account zhangsan = new Account("zhangsan", 1000.0);
Account lisi = new Account("lisi", 1000.0);
new Thread(() -> zhangsan.transfer(lisi, 100.0), "zhangsan").start();
new Thread(() -> lisi.transfer(zhangsan, 100.0), "lisi").start();
}
}定位
jps 查看进程的 pid
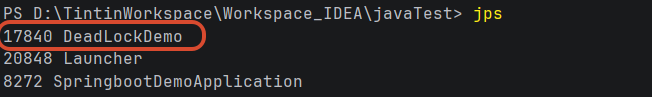
jstack <pid> 查看虚拟机当前时刻的线程快照,找到死锁
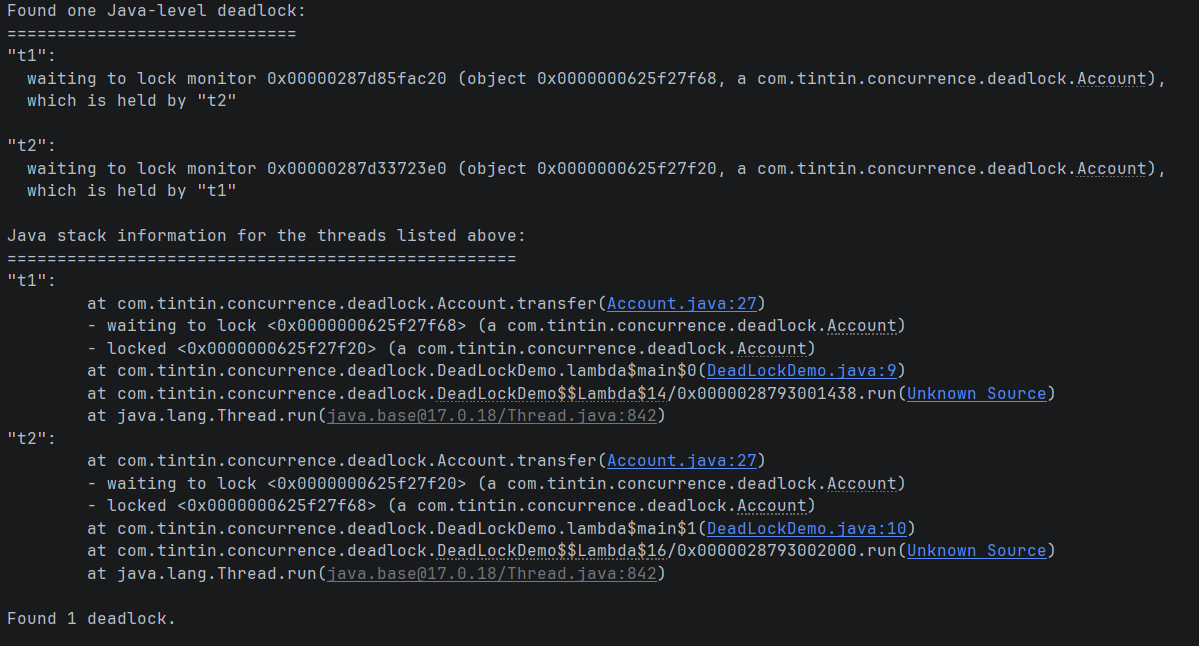
解除:一旦检测到死锁,就采取措施解除,可以中断其中一个或多个线程(强制释放资源),或者直接重启服务。
预防:通过破坏四个必要条件(互斥、请求与保持、不剥夺、循环等待)中的一个或多个来预防死锁的产生。
- 破坏互斥——不使用互斥锁(使用 ThreadLocal、CAS、原子类操作)
- 破坏请求与保持——同时请求多个资源,不要先后请求资源
- 破坏不剥夺——使用超时锁
- 破坏循环等待——拟定锁的获取顺序,任何线程只能先取 a 再取 b 再取 c
某些措施一定程度上会影响性能,降低系统吞吐量,
避免:银行家算法
秒杀系统如何设计
秒杀时的痛点
- 瞬时并发量大
- 大量用户同一时间抢购
- 网站访问流量激增
- 可能出现超卖
- 访问请求数量远远大于库存数量
- 订单数量与库存数量保持一致
整体架构
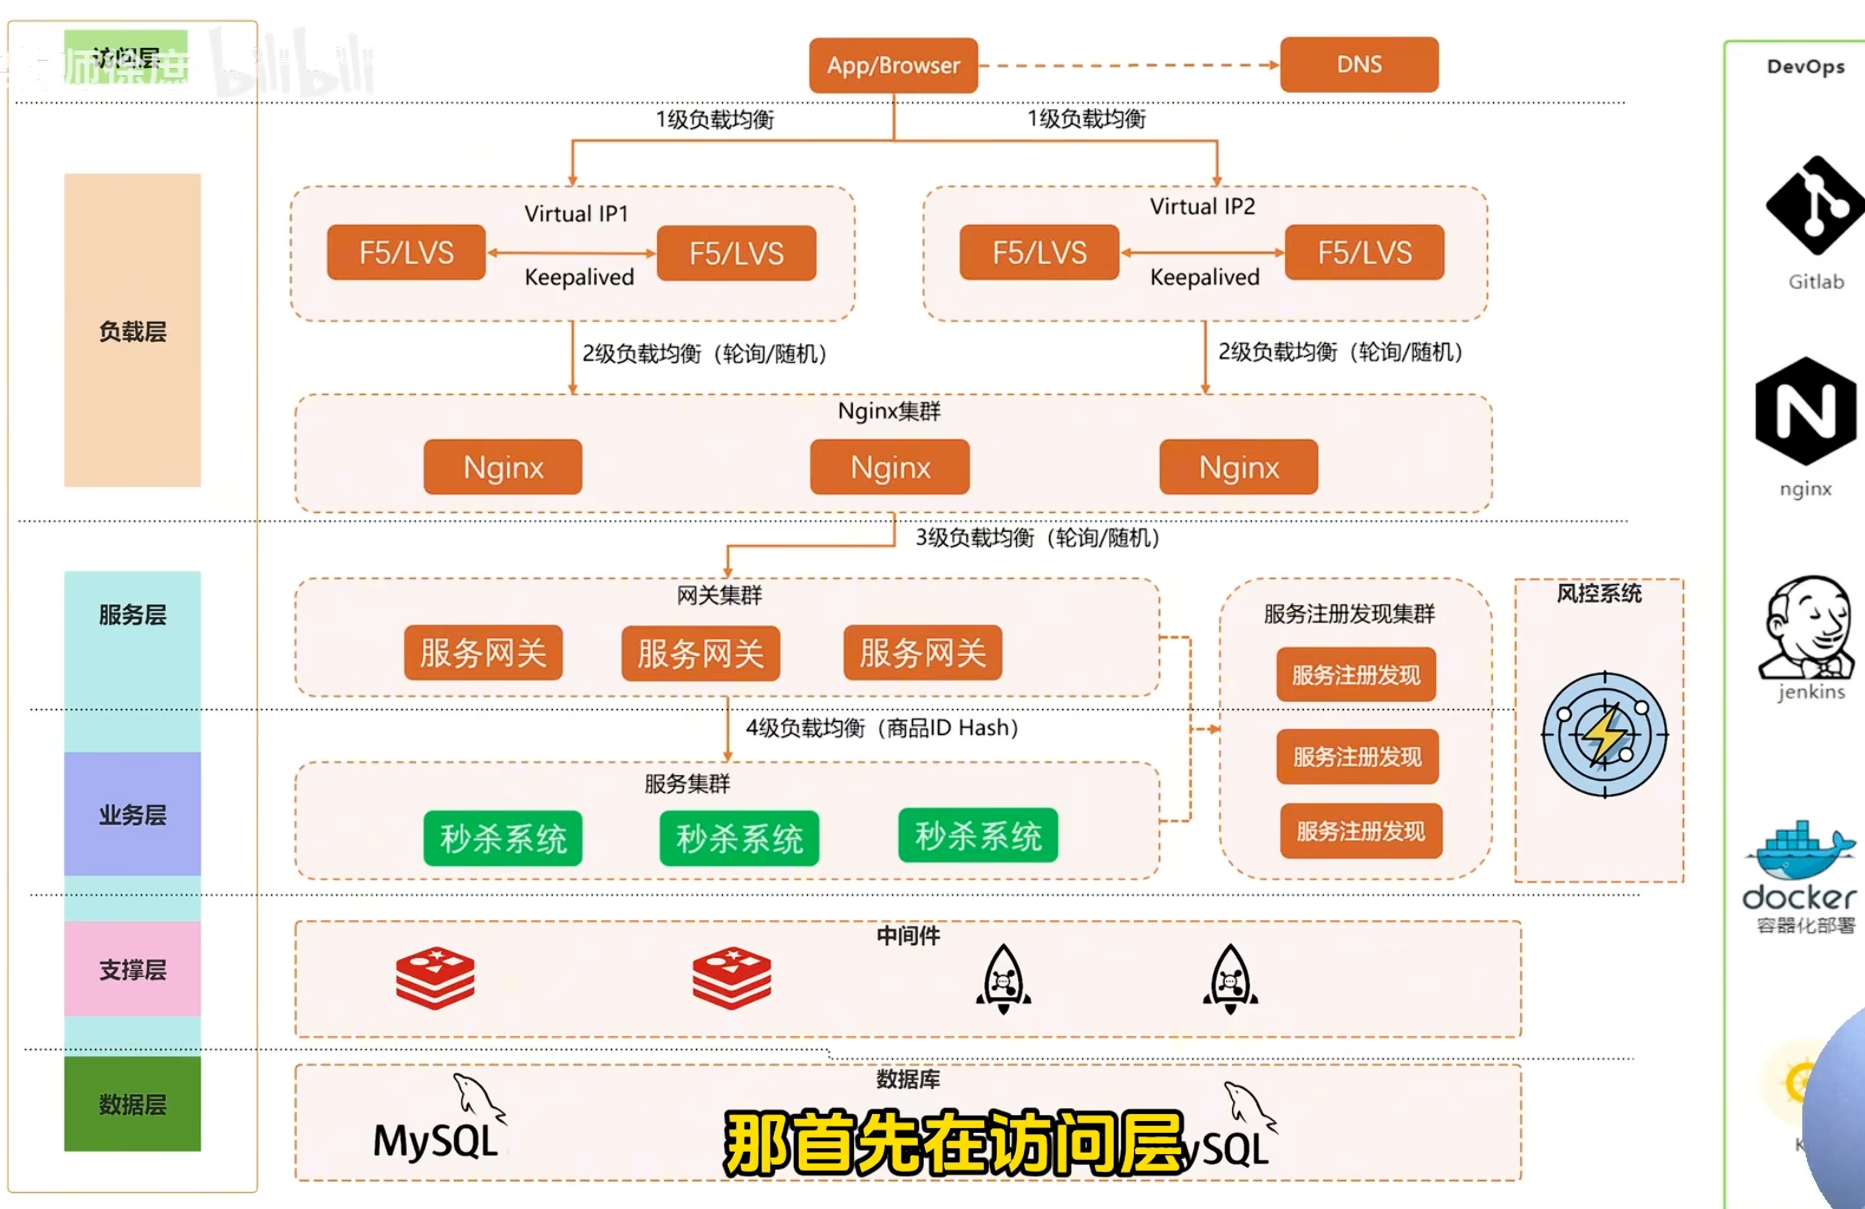
访问层
- 秒杀商品页生成静态页,缓存 CDN
- UI
- 活动前禁用按钮
- 点击后禁用按钮
- 滑动验证码
- 增加排队的交互体验
中间转发的多级负载均衡
- 一级负载均衡——DNS 轮询实现负载均衡
- 二级负载均衡——Nginx 并发量超过两三万,采用集群部署,因此 Nginx 上层就要部署硬件级别的负载均衡(四层/传输层负载均衡器、云平台负载均衡 )
- 三级负载均衡——Nginx 对网关集群进行轮询算法或随机算法负载均衡
- 四级负载均衡——网关(如 Spring Cloud Gateway)通常自带负载均衡,还有客户端的软件负载均衡算法(LoadBalancer、Ribbon)和服务调用(OpenFeign)
中间转发的限流
- Nginx 配置限流,防止恶意的攻击
- 服务网关层,通过 sentinel 对不同的服务节点进行限流和熔断
服务端
- 预热——将商品及库存数据缓存至 redis 中,避免直接访问数据库
- 库存操作——redis lua 脚本操作库存数据保证原子性(判断库存大于 0,已有库存减 1,替换已有库存)
- 防止重复提交——redis
setnx命令,设置token + url + ip基本保证同一时间同一商品只能由一个用户购买有效 - 分布式锁——redis
setnx也能保证请求的原子性 - 异步下单、削峰稳流——通过 MQ 设置 prefetch 量,削峰限流
秒杀一般很少与数据库打交道,通常设置读写分离即可,如果数据量大的话可以设置分表
订单超时如何自动取消
定时任务
通过定时任务关闭订单,是一种成本很低,实现也很容易的方案。通过简单的几行代码, 写一个定时任务,定期扫描数据库中的订单,如果时间过期,就将其状态更新为关闭即可。
@Scheduled(cron = "0 0 22 * * ?")
public void pmNotify() {
	this.pmService.todoNotify();
}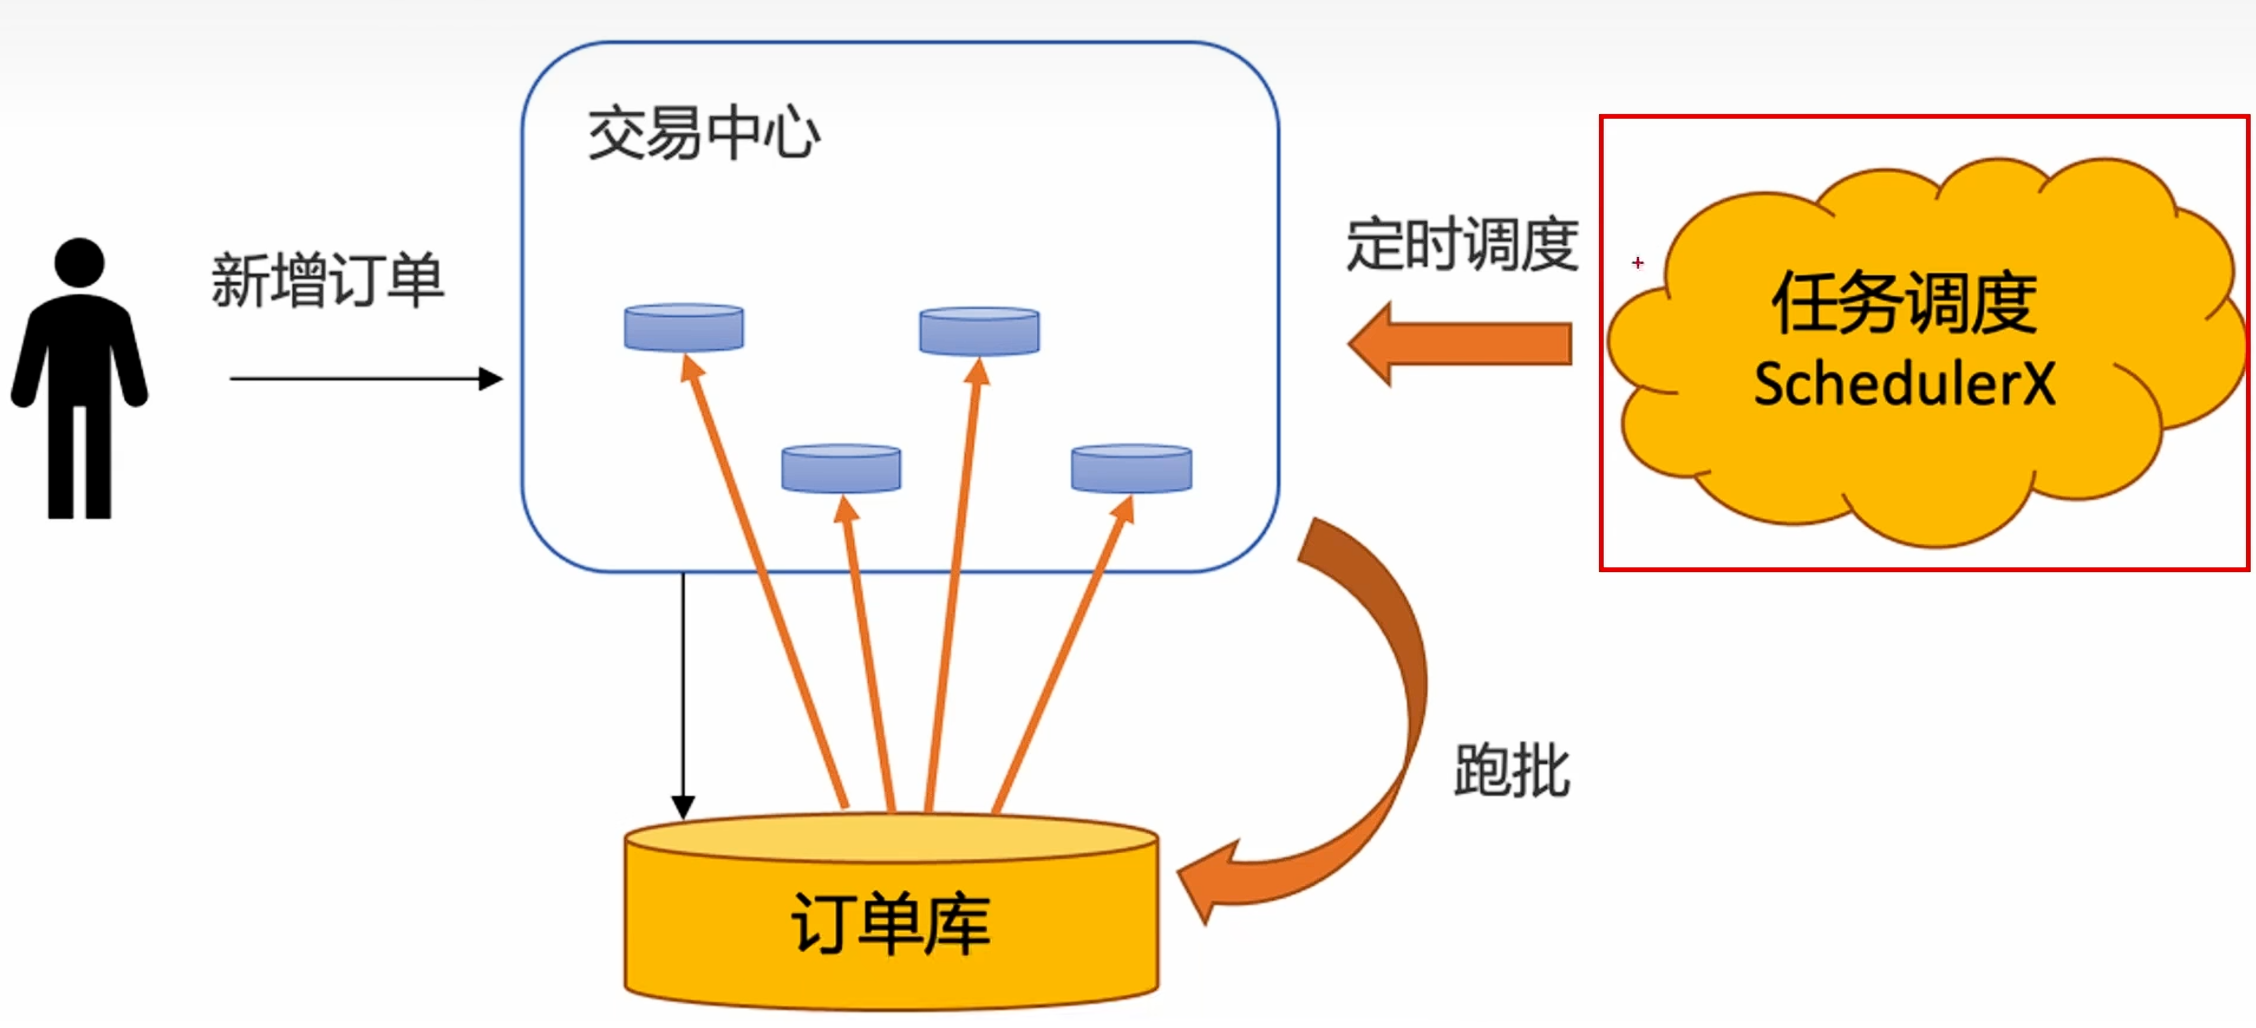
为了降低数据库的 TPS,避免影响线上的正常业务,将所有需要实现超时的任务,统一抽取到超时中心,统一扫描超时库完成超时处理。
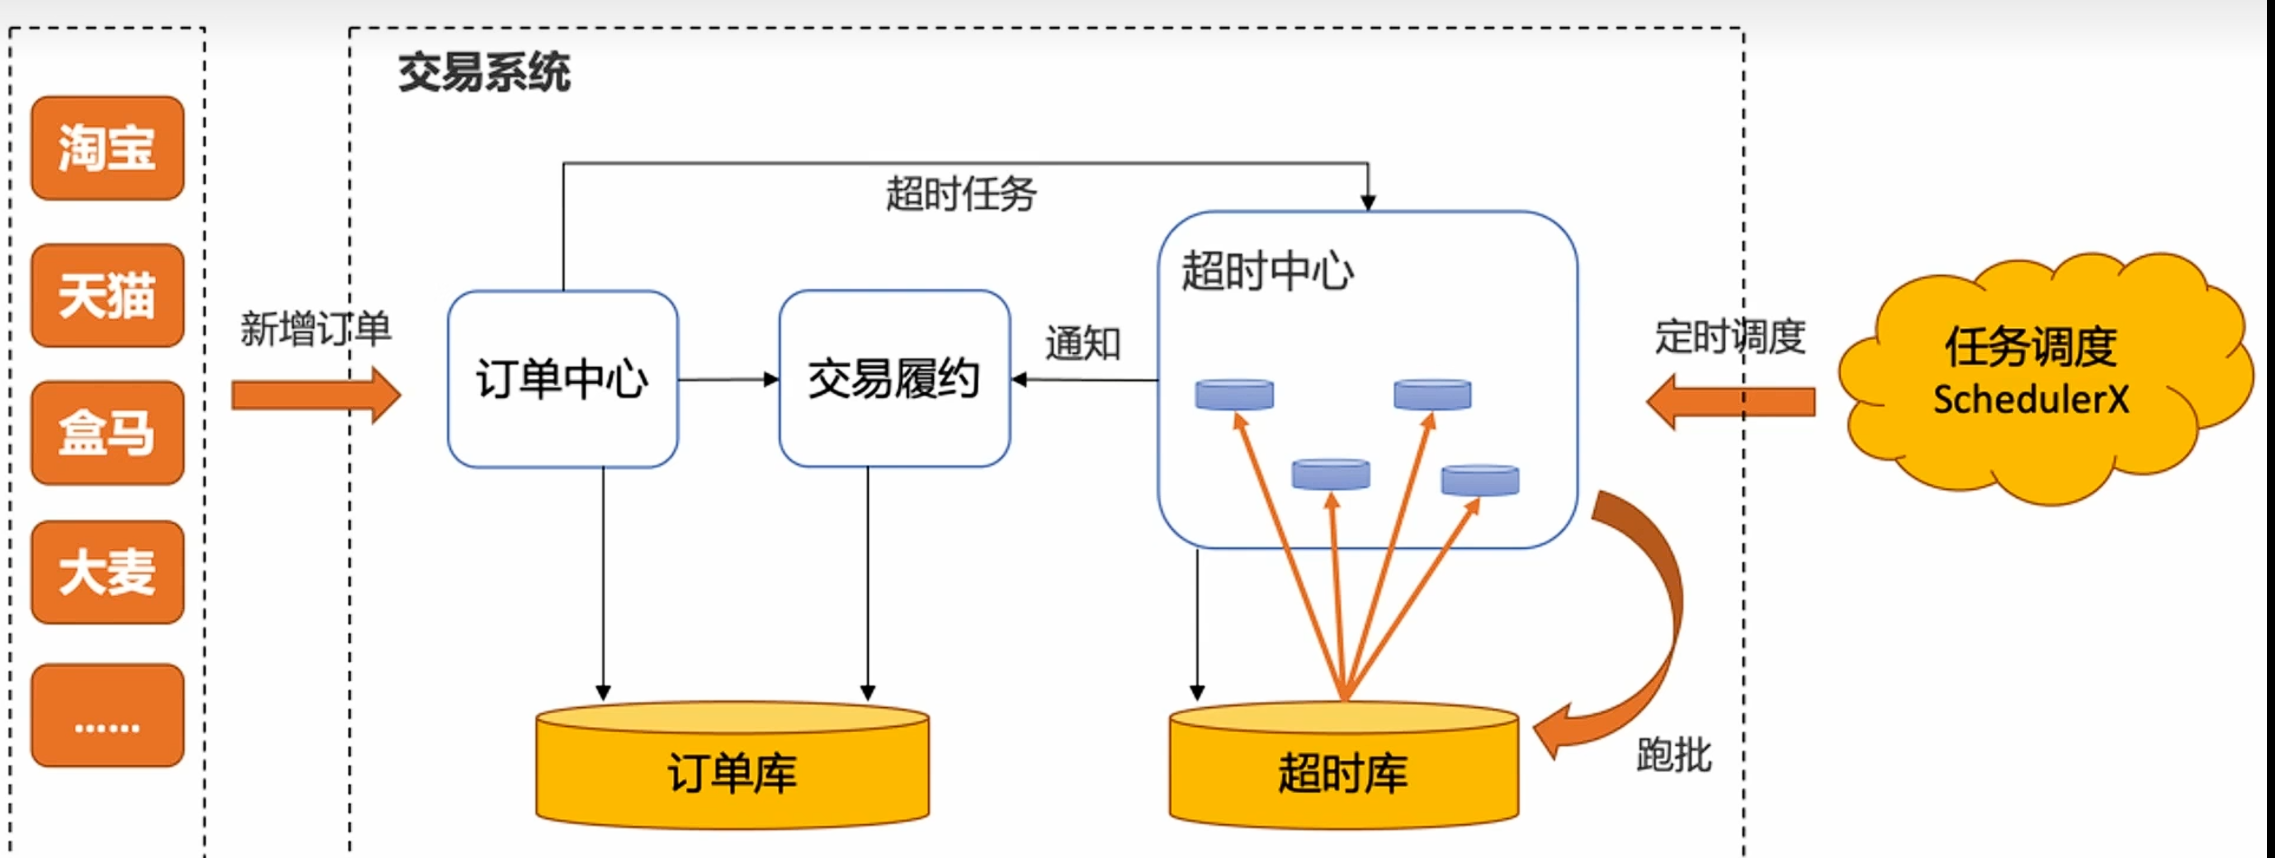
JDK 延时队列 DelayQueue
订单按照剩余支付时间排序
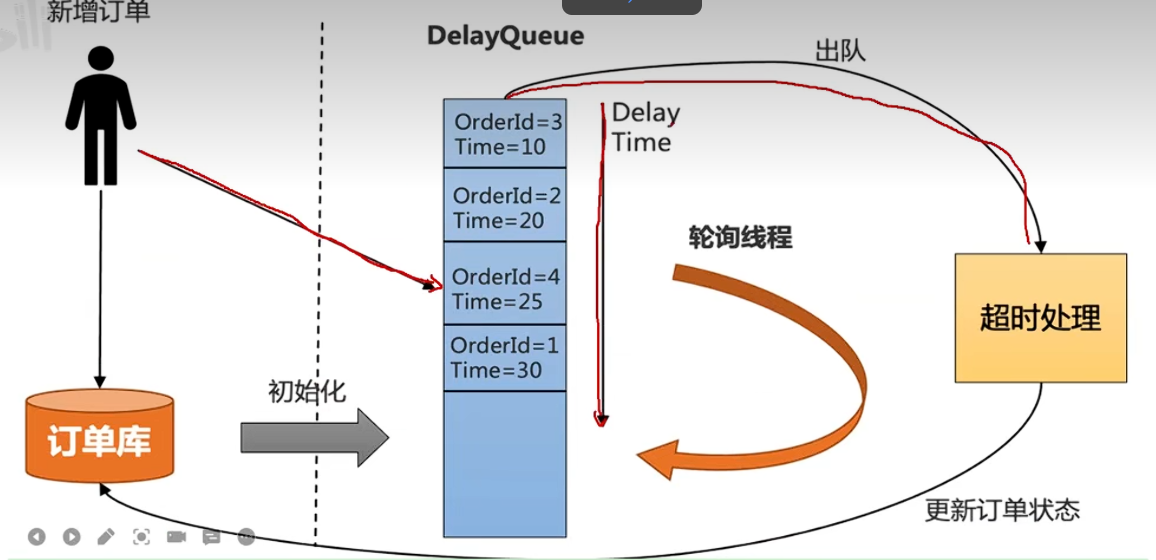
启动线程,不停轮询取队列元素,这些元素只能在其到期时才能从队列中取走。如果超时了则出队进行超时处理,关闭超时订单,更新数据库的订单状态。
优点:简单,不需要借助其他第三方组件,成本低。
缺点:所有超时处理订单都要加入到 DelayQueue 中,占用内存大。没法做到分布式处理,只能在集群中选一台 leader 专门处理,效率低。不适合订单量比较大的场景。
MQ 延时消息
方式一:RabbitMQ 设置超时消息 + 死信队列
- 支付业务负责支付后从队列中取出消息
- 订单超时处理的业务负责监听死信队列关闭超时订单
方式二:RocketMQ 延迟消息(定时消息)允许生产者发送的消息在指定时间后才被消费者接收。
RabbitMQ 延迟消息需要安装插件
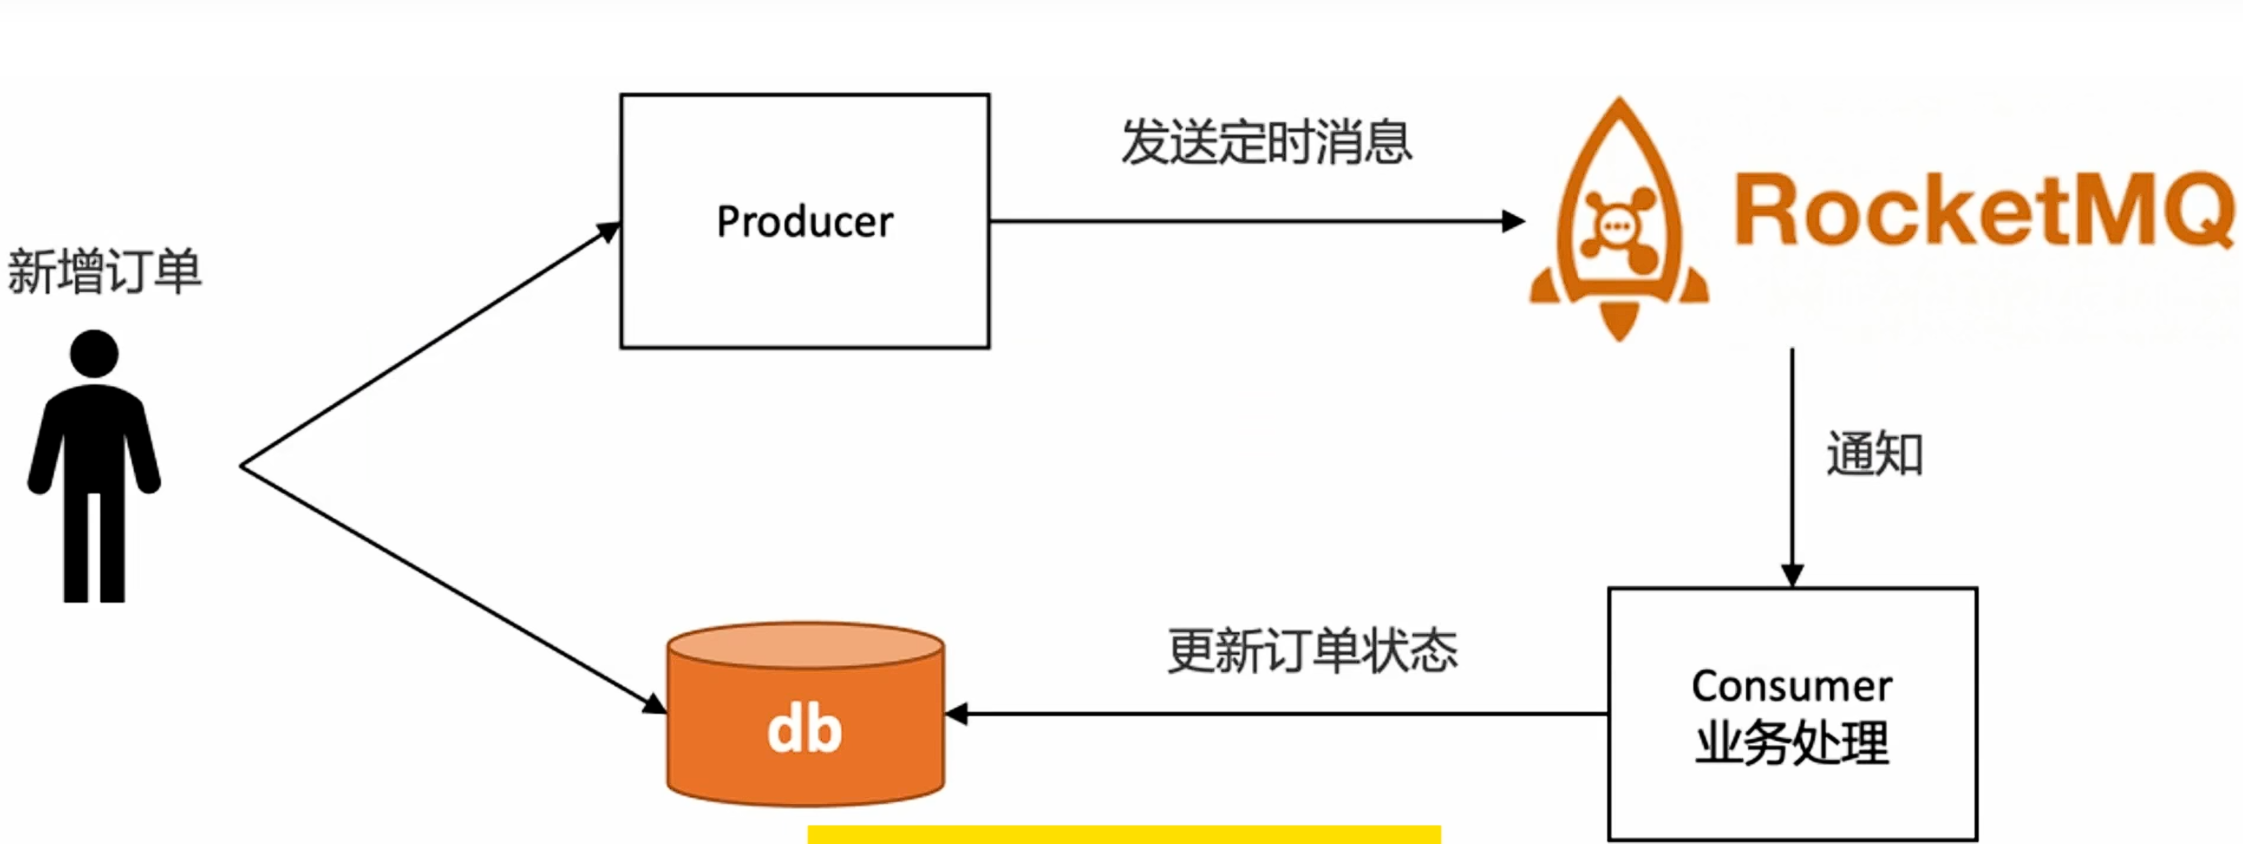
优点:使用简单,和使用普通消息一样。支持分布式。精度高,支持任意时刻。
缺点:使用限制:定时时长最大值 24 小时。每个订单需要新增一个定时消息,且不会马上消费,给 MQ 带来很天的存储成本。同一时刻的大量延迟消息到达消费端会造成系统压力过大。
Redis 过期监听
setex <key> <vaue> 设置 key 的值,并指定有效期
Redis 过期监听是一种机制,允许开发者在 Redis 中的键过期时接收通知。这在需要对过期事件做出响应的场景中非常有用,例如,自动删除过期的会话数据或触发其他清理任务。
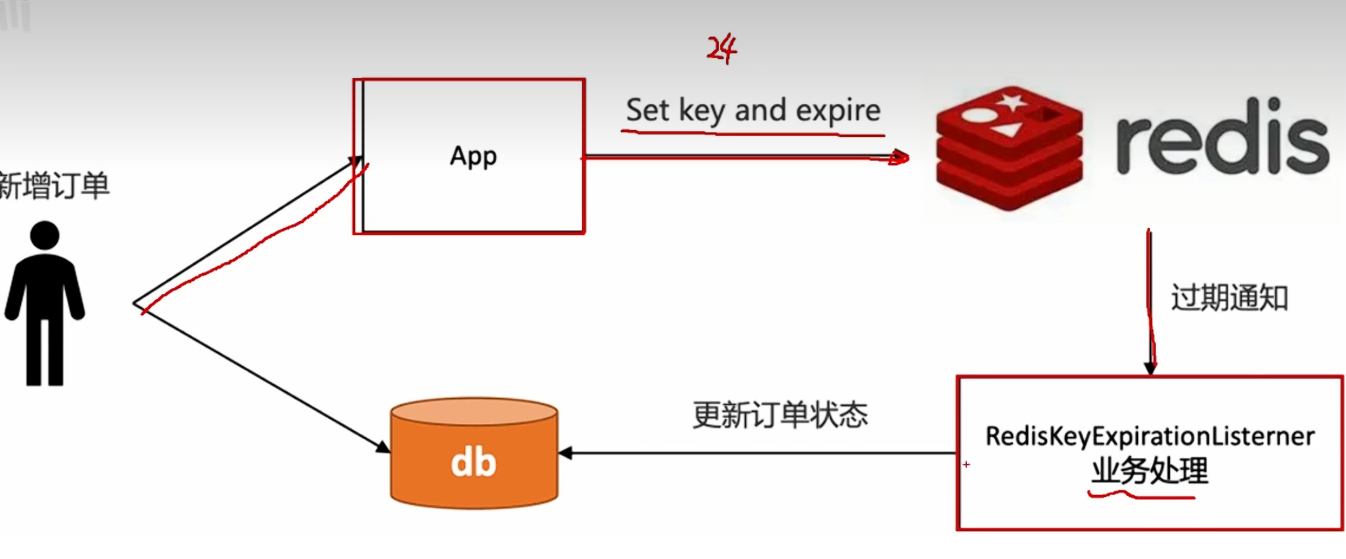
优缺点与其他消息中间件类似。
Redis 在过期通知的时候,如果应用正好重启了通知事件就会丢失导致订单无法关闭。
总结
如果是简单的单体应用,直接使用 JDK DelayQueue。
如果对于超时精度比较高,超时时间在 24 小时内,且不会有峰值压力的场景,推荐使用 RocketMQ 的定时消息解决方案。
在电商业务下,许多订单超时场景都在 24 小时以上,对于超时精度没有那么敏感,并且有海量订单需要批处理,推荐使用基于定时任务的跑批解决方案。
如何防止重复下单
普通的下单流程
点击购买-> 创建订单(未支付)-> 确认订单-> 改订单状态(待支付)-> 跳转支付界面-> 选择支付方式支付-> 由对应支付平台回调-> 支付服务调用订单服务-> 修改订单状态(已支付)
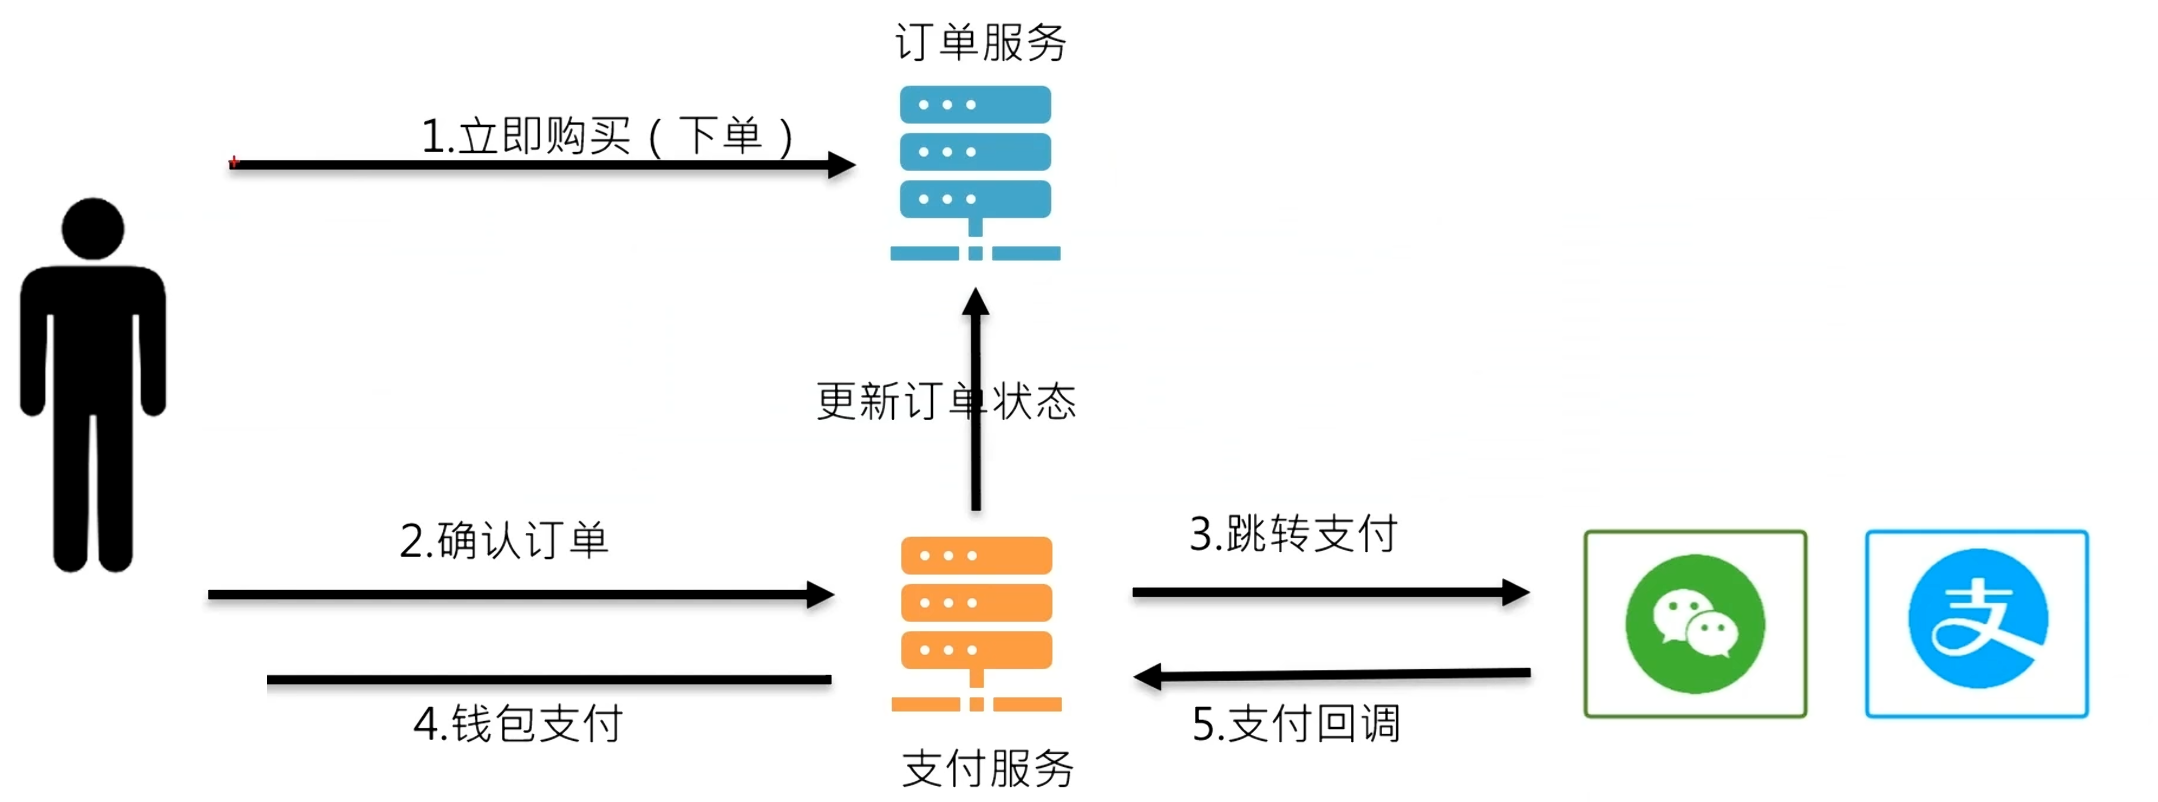
重复下单问题基本出现在点击购买多次导致创建多个订单。
前端:点击后设置为不可用
后端:Redis setnx 设置可以表示当前用户唯一性的 key(例如 用户token:URL:key:业务场景 ),多次操作只能存储一次值,设置成功后才能进行下单操作,其他请求都会设置失败,停止下单业务操作。
如何防止多台机器刷单薅羊毛
Nginx、Sentinel 网关或者 MQ 做限流,避免重复请求
setNX user_token:url区别同一个用户同一个请求只有一个生效上诉操作过后,系统依然无法区分这些请求是多台手机刷单还是正常的用户。
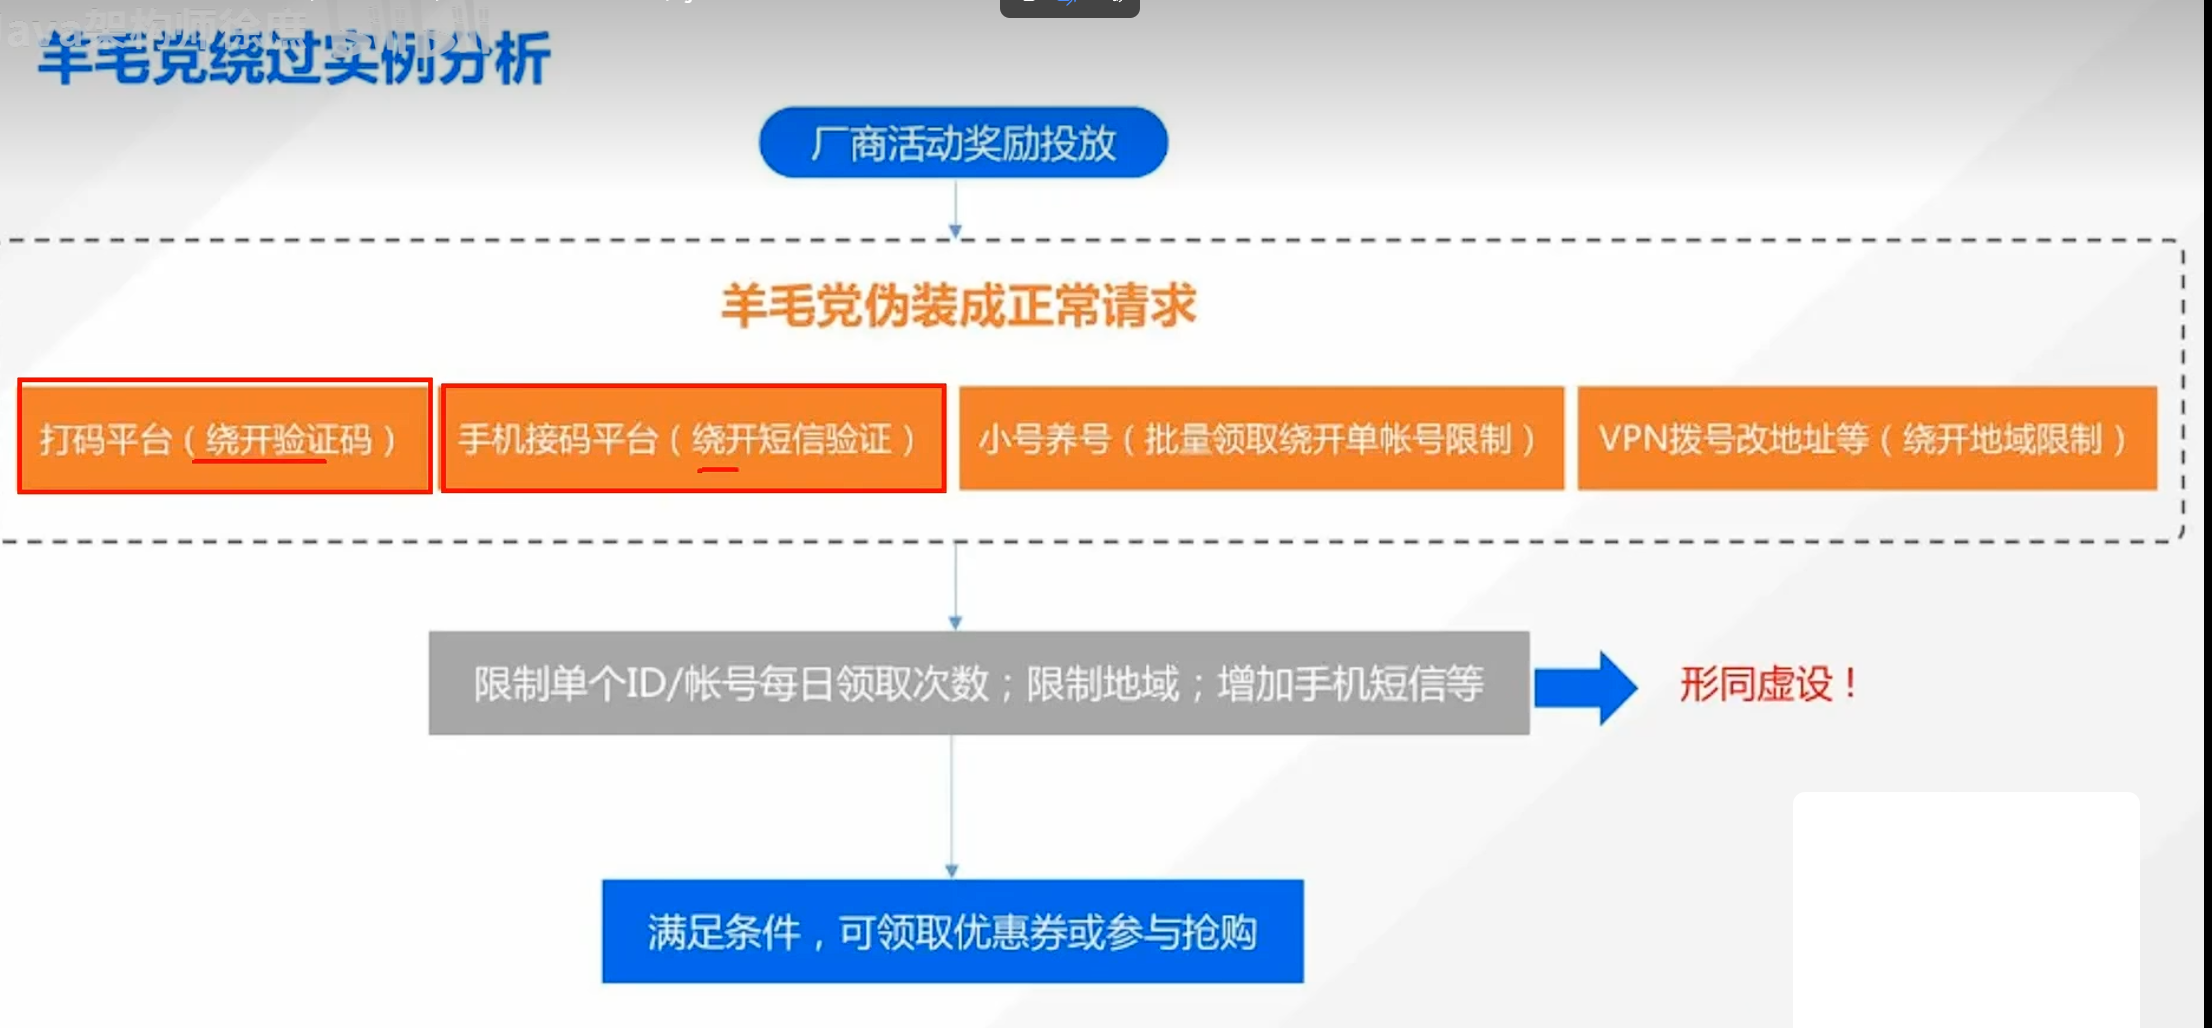
业务方面的风险控制
- 提高羊毛门槛:实名认证、消费门槛、随机优惠
- 限制用户参与、中奖、奖励次数
- 根据用户的历史行为和忠诚度,提供不同层次的优惠,优待忠实用户。
- 奖池(优惠券数量)限制上限
技术方面的风险控制
- 限流、自动扩容伸缩
- 黑名单(客服标记、系统监测)布隆过滤器
- 大数据用户画像(一般只有阿里腾讯采用这方面能力,自研用户画像需要一整套的大数据技术)
分布式集群架构下怎么保证并发安全
秒杀流程
- 解决:判断商品库存是否大于 0,是则扣减库存,否则秒杀失败
出现超卖问题
- 原因:多线程并发同时对一个共享资源进行读写会造成数据错乱
- 解决:加上同步锁 synchronized
用户量增多
- 解决:对应用服务器进行分布式集群部署,使用 Nginx 进行负载均衡
又出现超卖问题
- 原因:同步锁是 JVM 级别,每台服务器只能锁服务器内的一个线程。
- 解决:使用分布式锁 Redis
setnx
业务出现停滞
- 原因:正在处理业务的服务挂了,键值一直存在没有释放,其他线程无法获取锁,出现类似死锁的情况。
- 解决:加上超时时间,过期后分布式锁自动释放
又出现超卖问题
原因:键值超时释放,但是当前线程业务还没处理完成,另一条线程获取了锁,当前线程完成后反而把另一条线程的锁释放了,导致又有其他线程进入业务,如此往复。
解决:加长超时时间,添加子线程定期确认主线程是否在线,在线则延长/重置过期时间
解决:设置一个 Hash 类型的数据,UUID + 线程 ID 作为 Feild,使锁绑定了一个线程标识,避免释放其他线程的锁。
更好的解决:通过 Redisson 可以直接使用分布式锁
javaRLock lock = redisson.getLock(LOCK_KEY); lock.lock();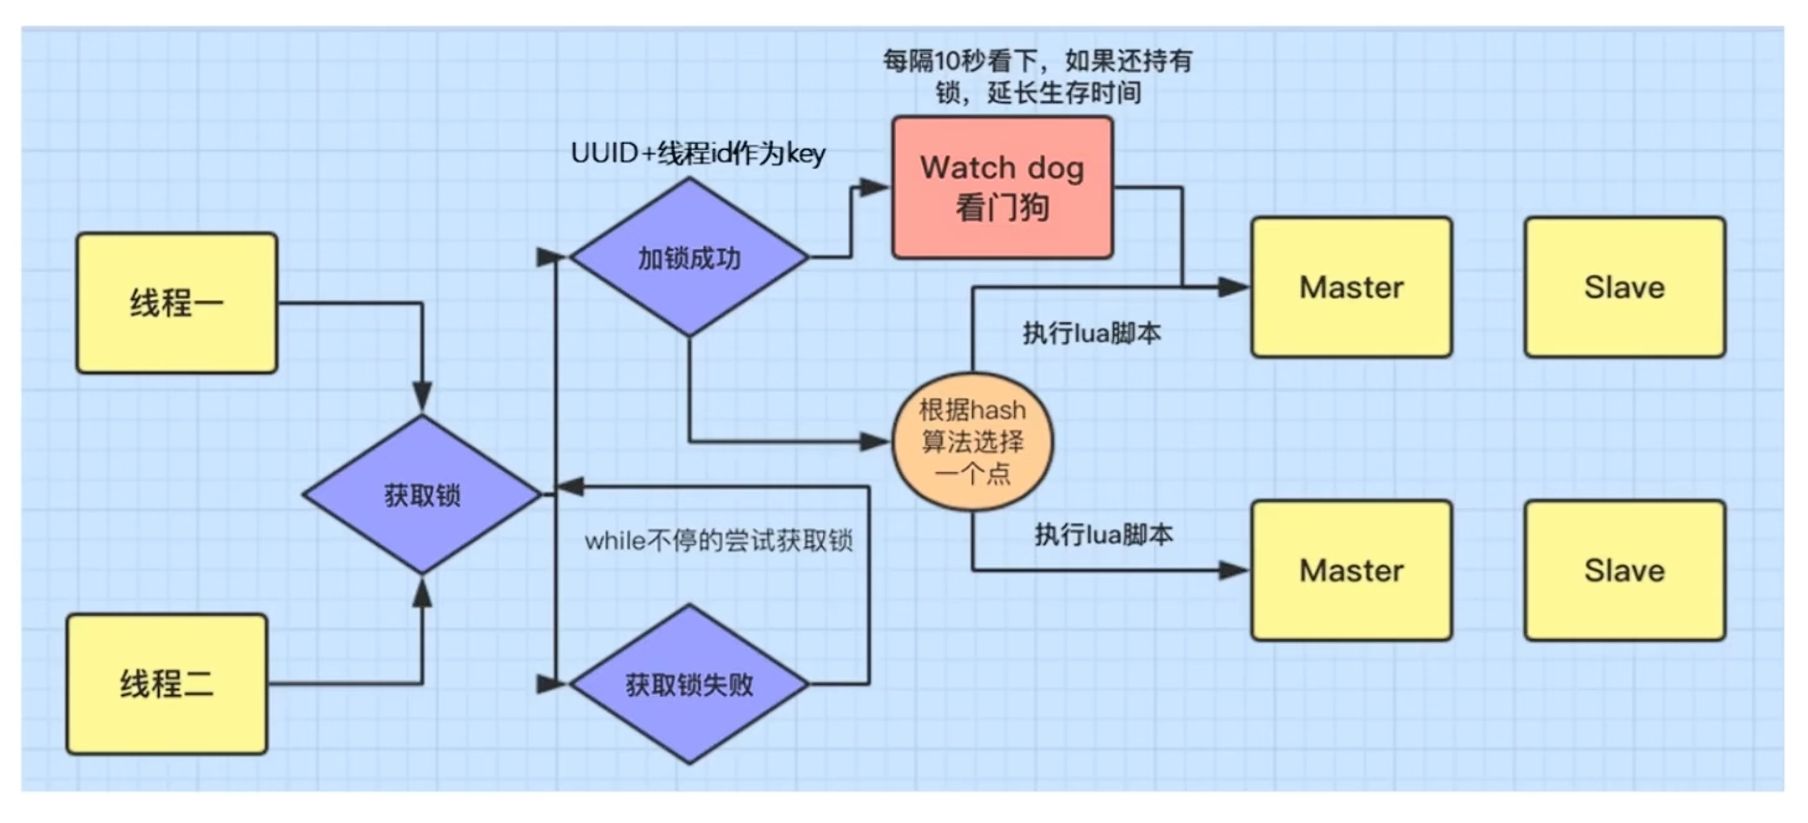
又出现超卖问题
- 原因:Redis 使 AP 模式,设置锁时,只会往一个 Redis 节点设置键值,集群内部再进行同步,当主从集群发生分区时,主节点将无法同步到从节点,产生了不一致性。
- 使用 Redisson RedLock 可以针对 Redis 集群中所有节点进行同步,从而保障了强一致性。
扫码登录怎么实现
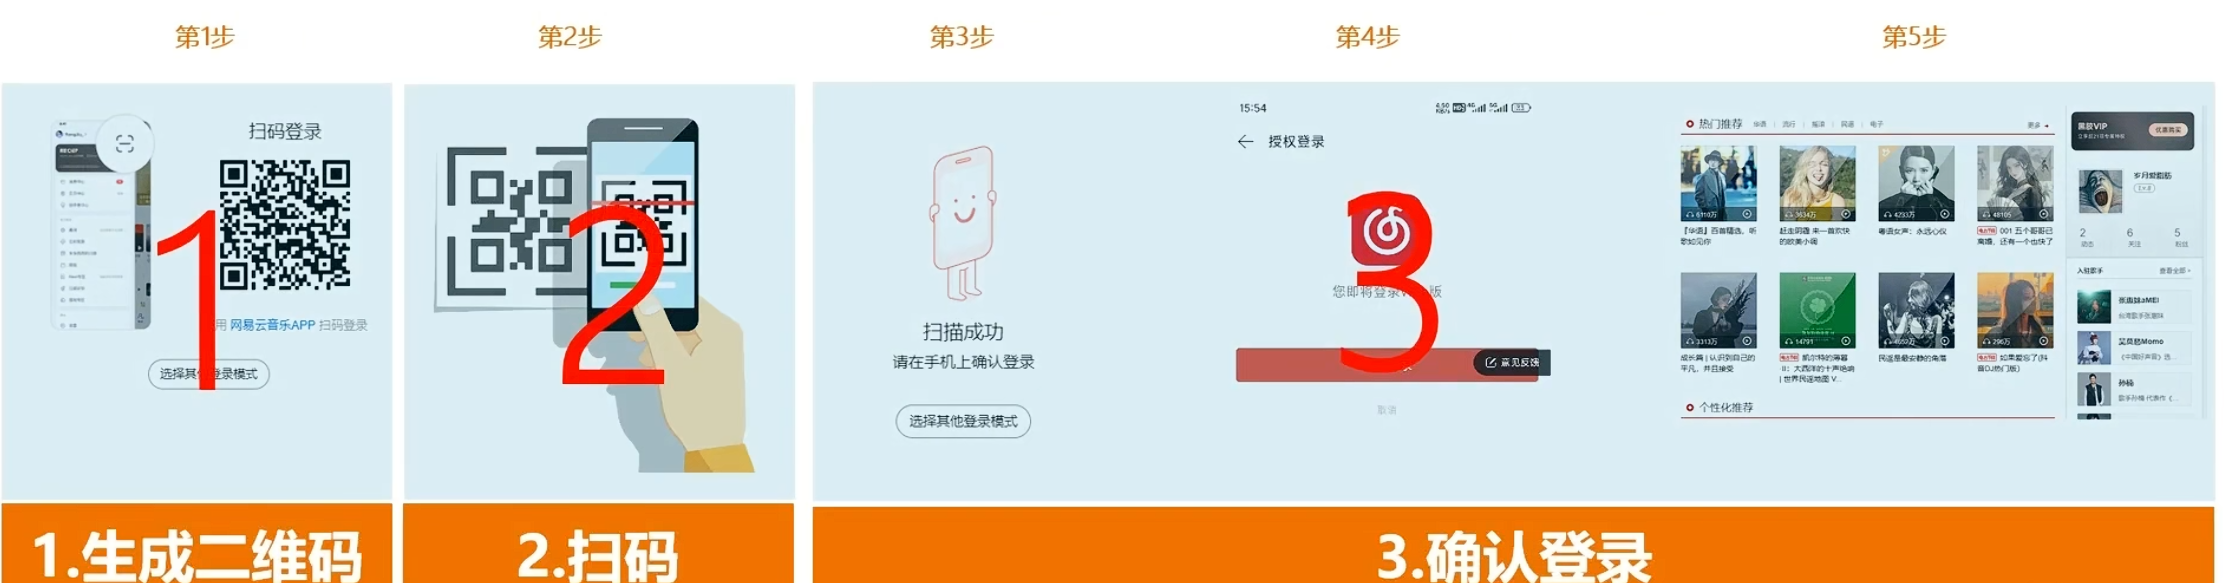
生成二维码 ID 和状态到 redis,根据二维码 ID 生成图片。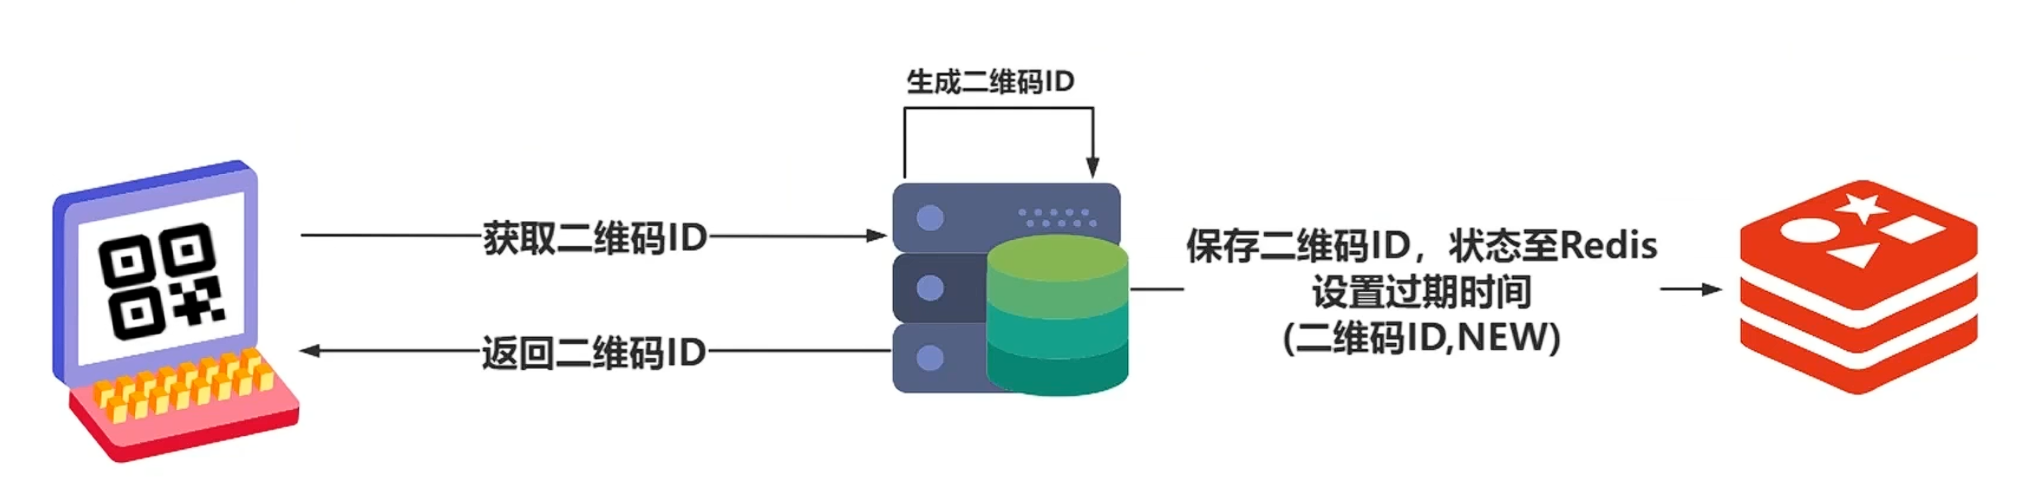
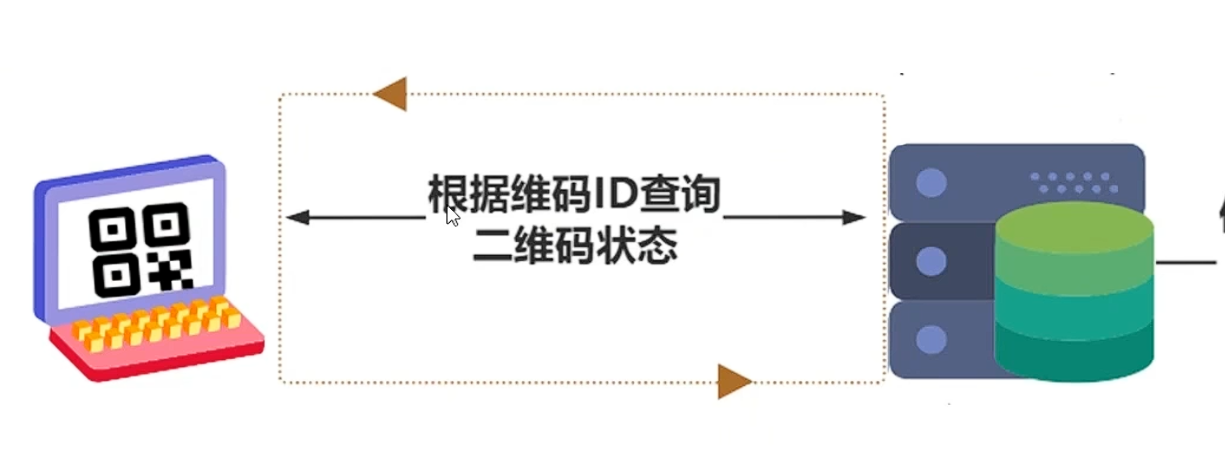
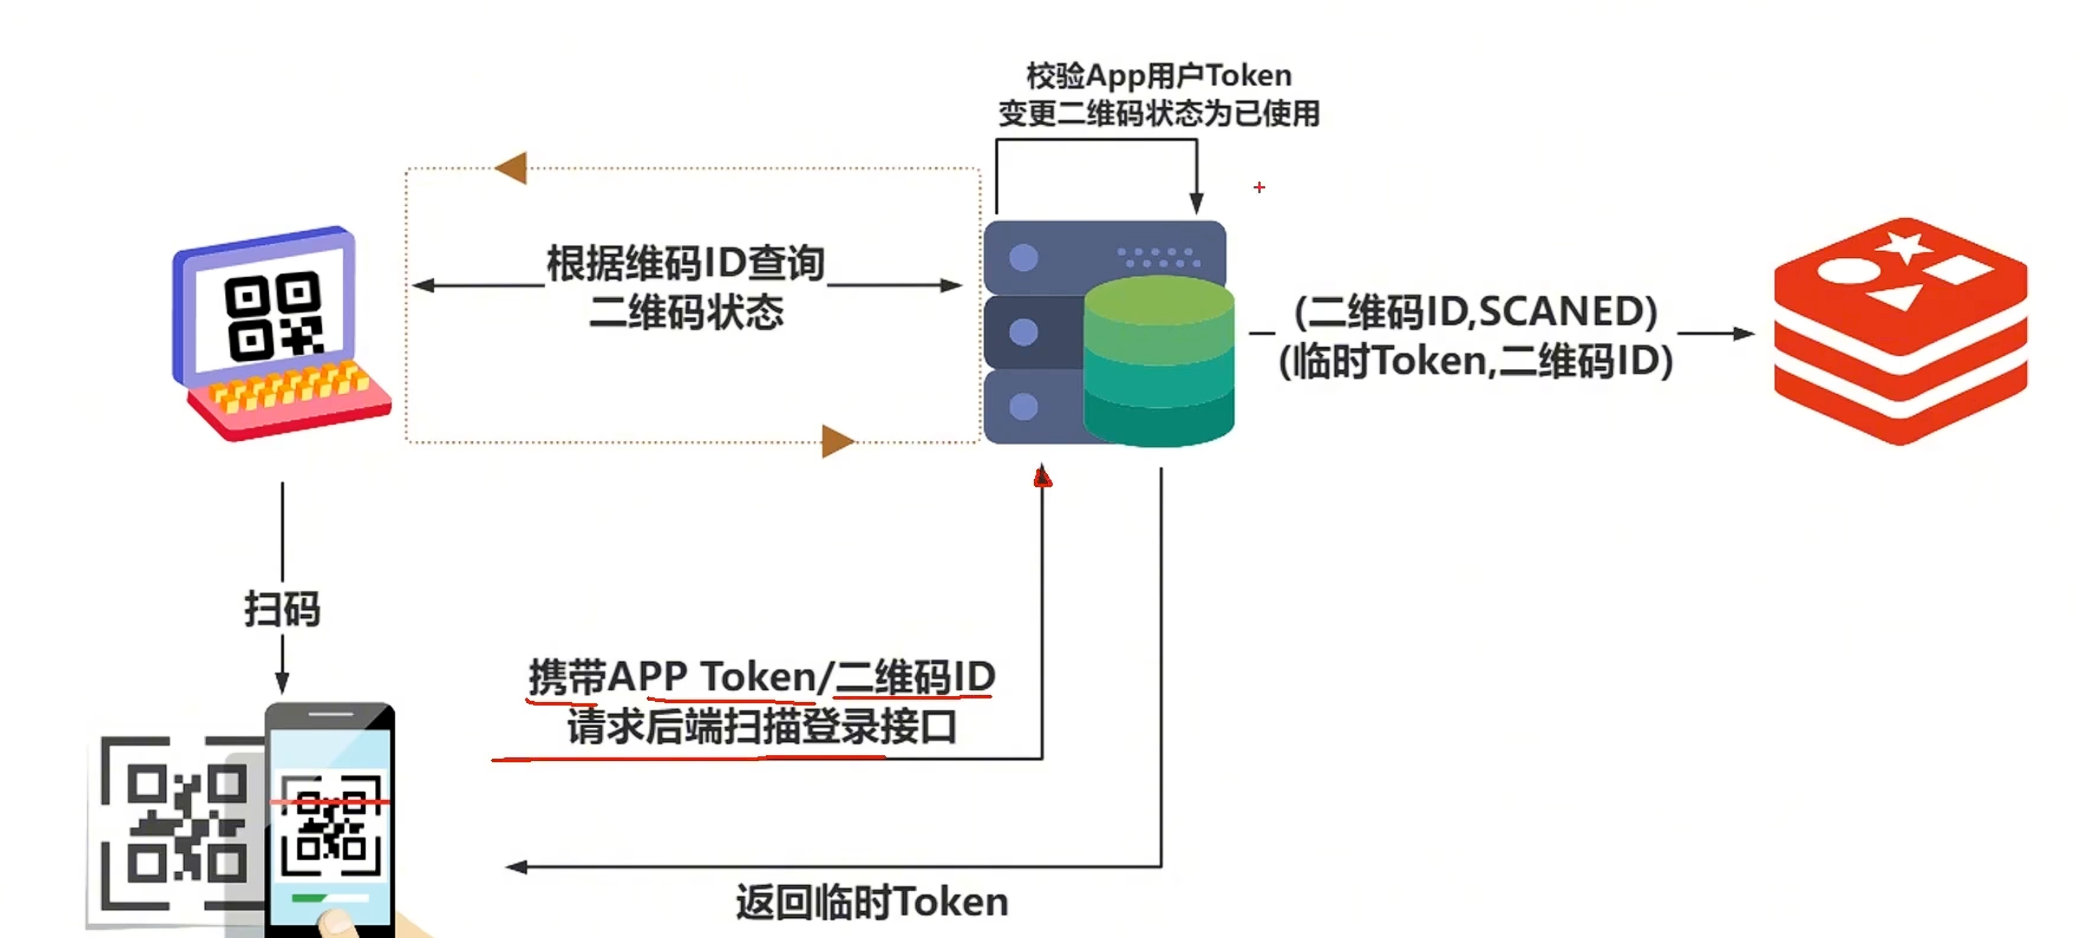
扫码,手机端通常是登录状态,携带登录信息请求后端的扫描登录接口。后端变更二维码状态为已使用,同时返回临时 Token,保存临时 Token 至 Redis。客户端(网页端/pc 端)通过轮询或者长连接(WebSocket)查询二维码状态,变更为等待手机确认的界面。
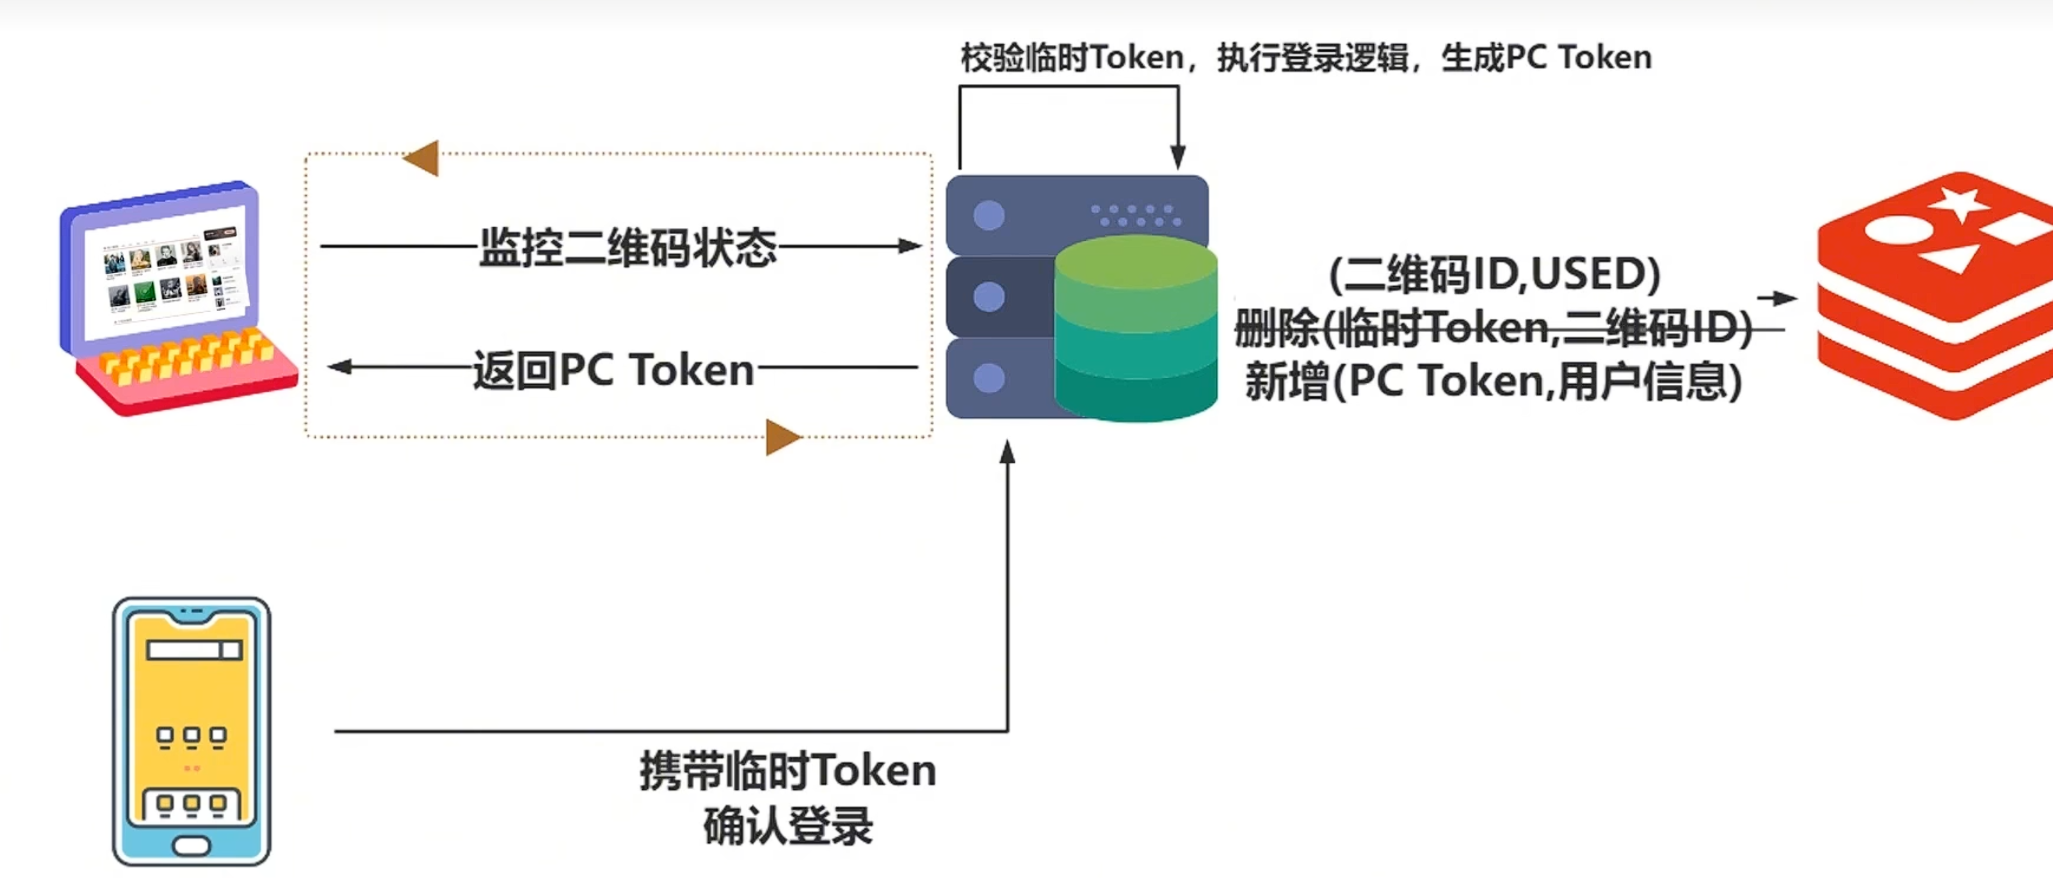
手机端出现确认登录界面,点击后携带之前的临时 Token 和二维码 ID 请求后端的确认登录接口。后端校验临时的 Token,执行登录的逻辑,修改二维码状态为已登录,生成 PC 端/网页端 的用户 Token,存入 Redis 代替原先的临时 Token。
分布式日志存储架构如何设计
单体应用:logback、log4j 记录日志到文件中
部署简单。成本低、易维护。性能高、稳定。
如果分布式系统每一台服务器的日志还是存储到文件中不便于排查问题。
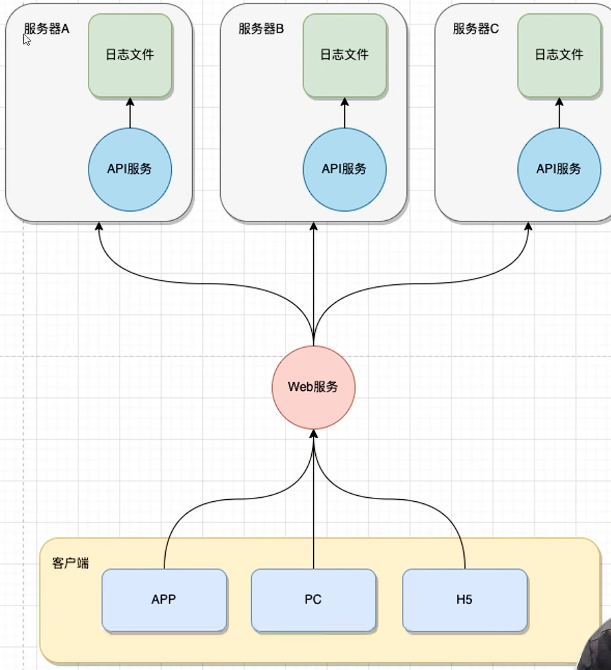
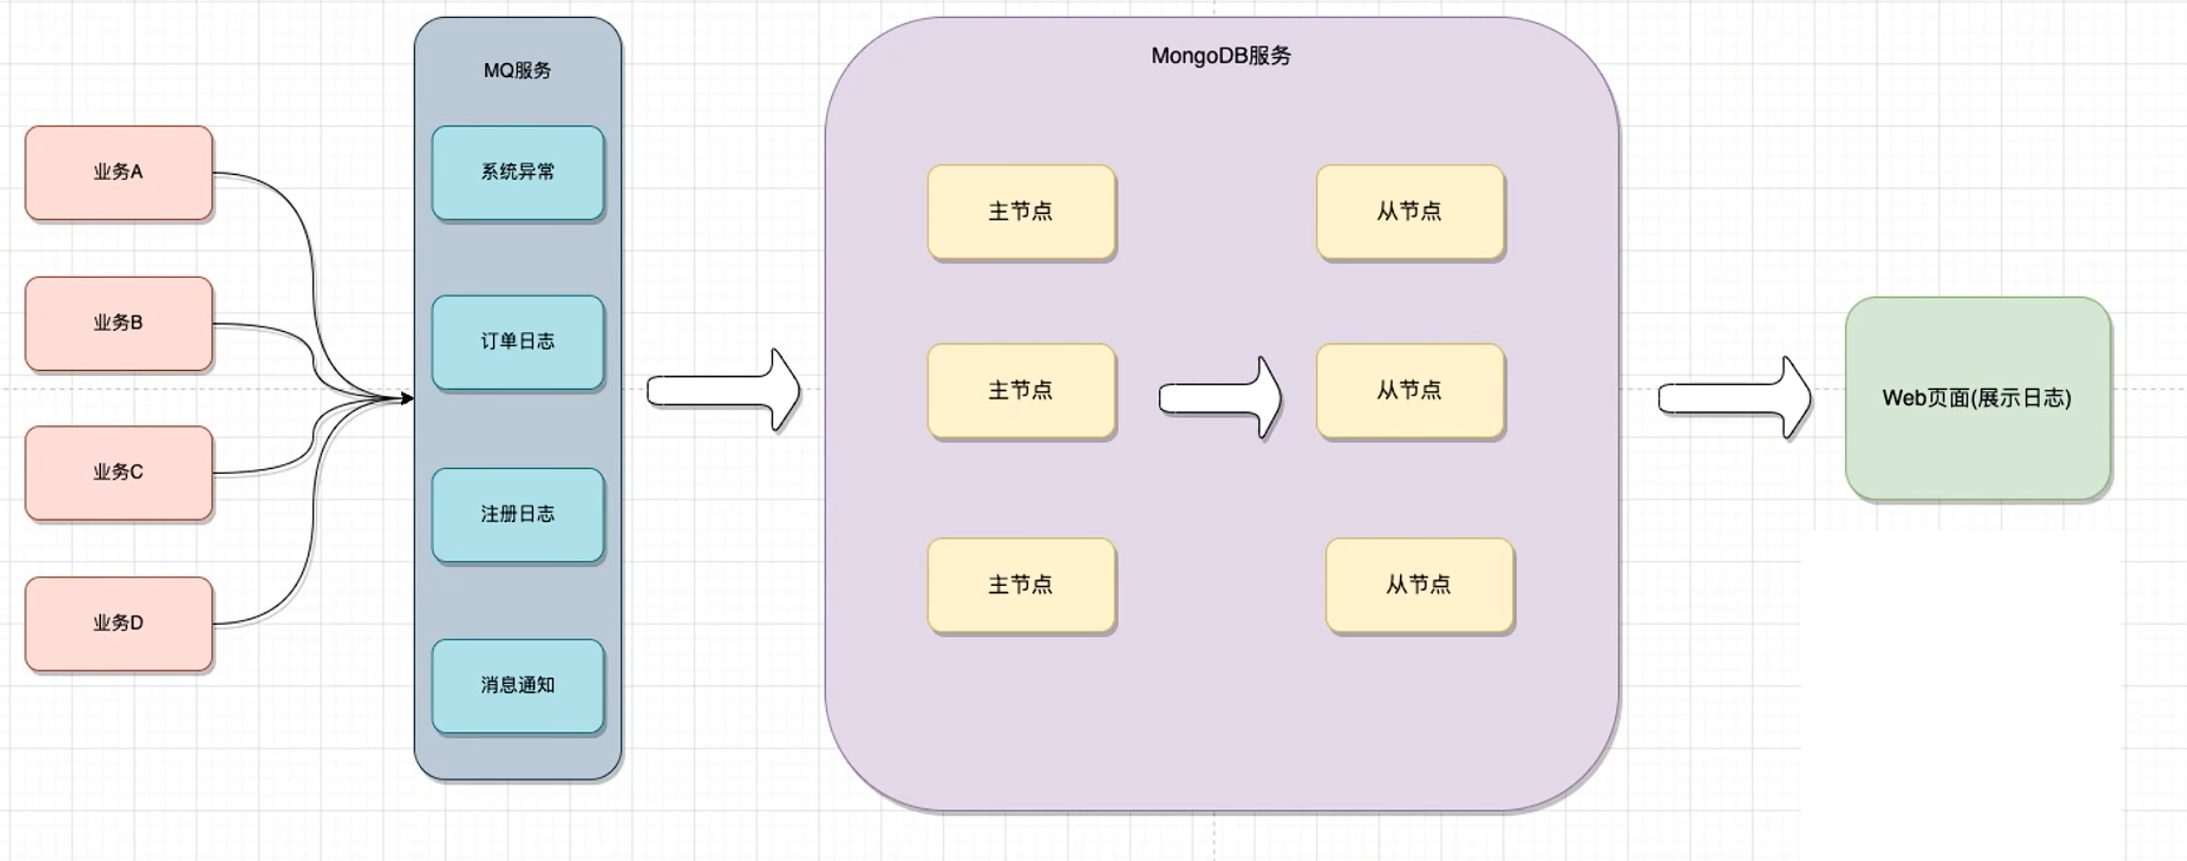
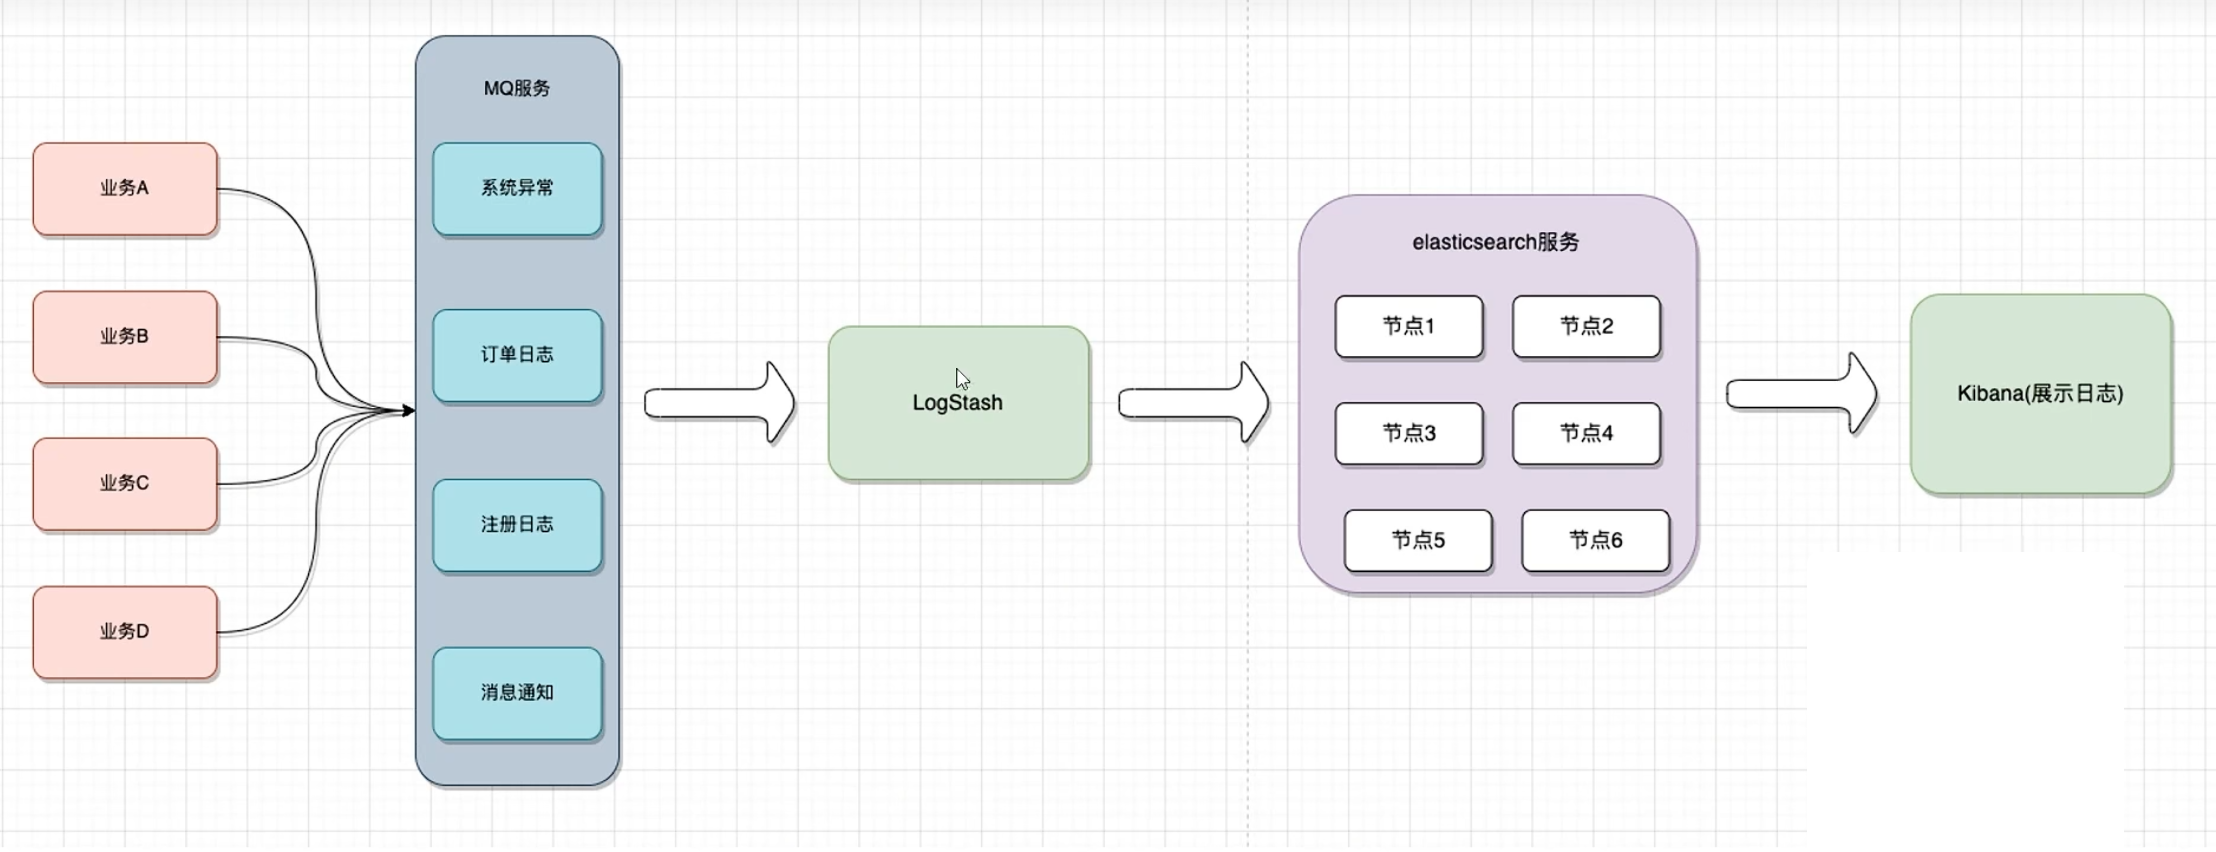
因此需要通过消息队列异步的存储日志信息,同时由一个日志管理系统统一管理。
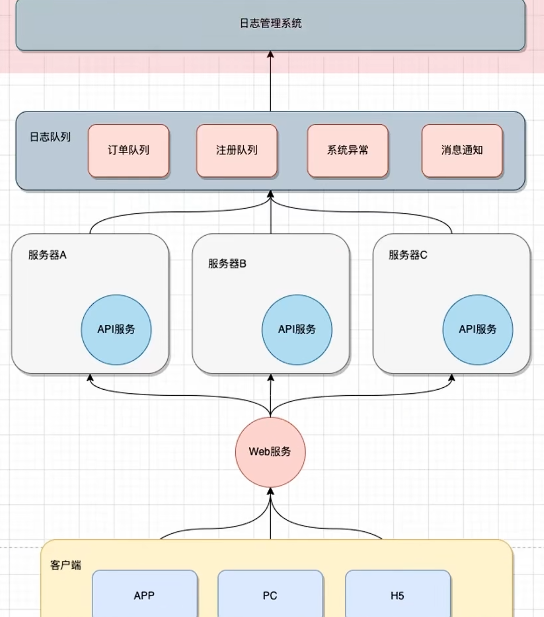
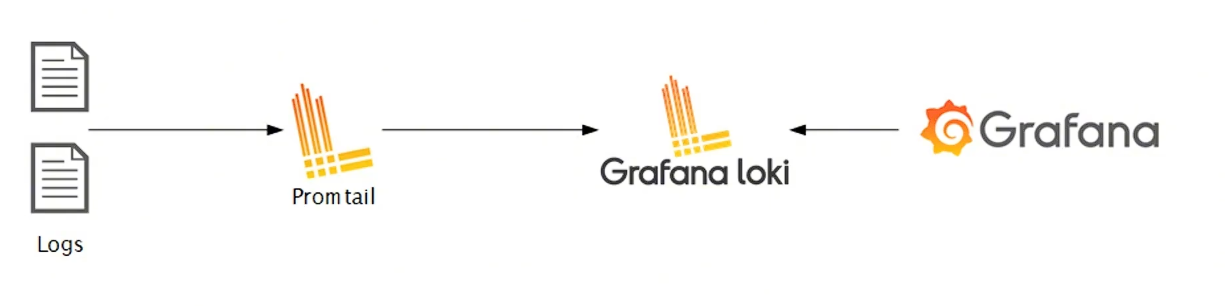
市面上三种主流的日志存储系统架构方案
MongoDB,适用于日志数据量大,数据格式灵活、查询复杂的场景
ELK(Elasticsearch、Logstash、kibana)。如果不需要过多的功能,可以用 FileBeat 轻量级日志框架 可以代替 LogStash
Loki (Prom tail 收集,Grafana loki 存储日志信息, Grafana UI 展示)
Redis 缓存的击穿、雪崩、穿透
详情参考 Redis-应用问题解决
缓存击穿:高并发 时,当一个 key 是热点数据,在不停的扛着大并发,当这个 key 在过期失效的瞬间,持续的大并发就穿破缓存,直接请求数据库并设置到缓存中,导致性能下降
解决方案:
- 出现高并发场景前,预先设置热点数据 永不过期
- 手动设置、实时调整
- 根据访问量自动设置
- 加锁排队
缓存雪崩:缓存集中过期,或者缓存服务器宕机,导致大量请求访问数据库,造成数据库瞬间压力过大,宕机。
解决方案:
- 在缓存击穿解决方案的基础上,给 key 值设置随机的失效时间
- redis 高可用部署,创建集群,开启哨兵模式
缓存穿透:数据库不存在缓存中也不存在,导致每次请求都会去查询数据库,这时的用户很可能是攻击者,如发起为 id 为“-1”的数 据或 id 为特别大(不存在的数据),导致数据库压力过大或宕机。
解决方案:
- 参数校验
- 缓存空对象
- 布隆过滤器
Redis 记录上亿用户连续登录天数
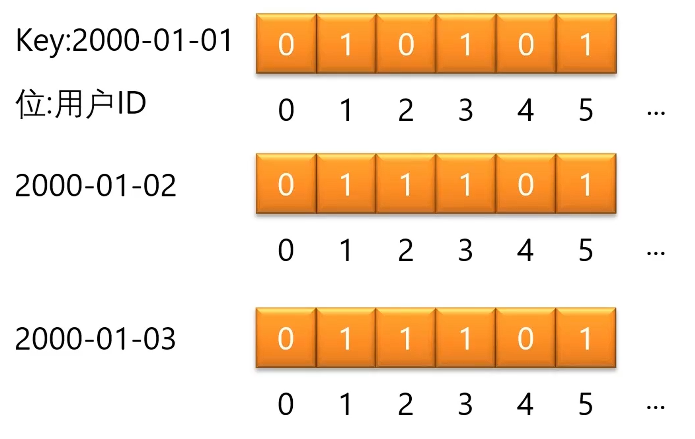
Bitmap 基于字符串,单独提供了一套命令操作字符串的位, 数组的每个单元只能存储 0 和 1, 数组的下标在 Bitmaps 中叫做偏移量。
String 类型占用 512M = 512 * 1024 * 1024 * 8 byte = 42 亿多位。
通过 Redis 的 Bitmap 数据类型记录用户的连续登录天数
以日期作为 key,适合统计短期活动的场景
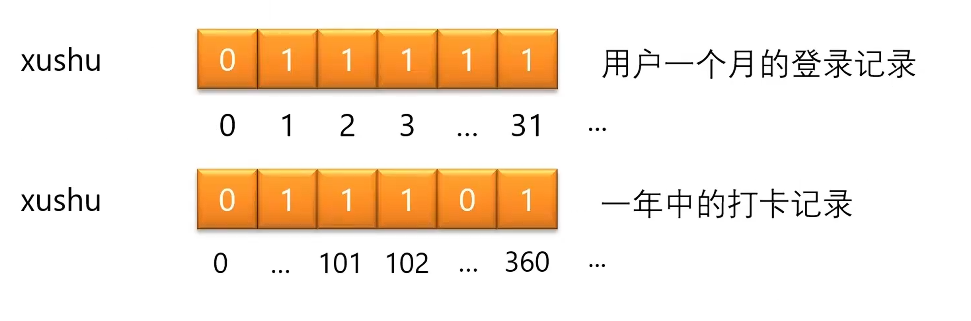
以用户 ID 作为 key,适合统计长期的情况,但用户过多耗费内存,记录不方便
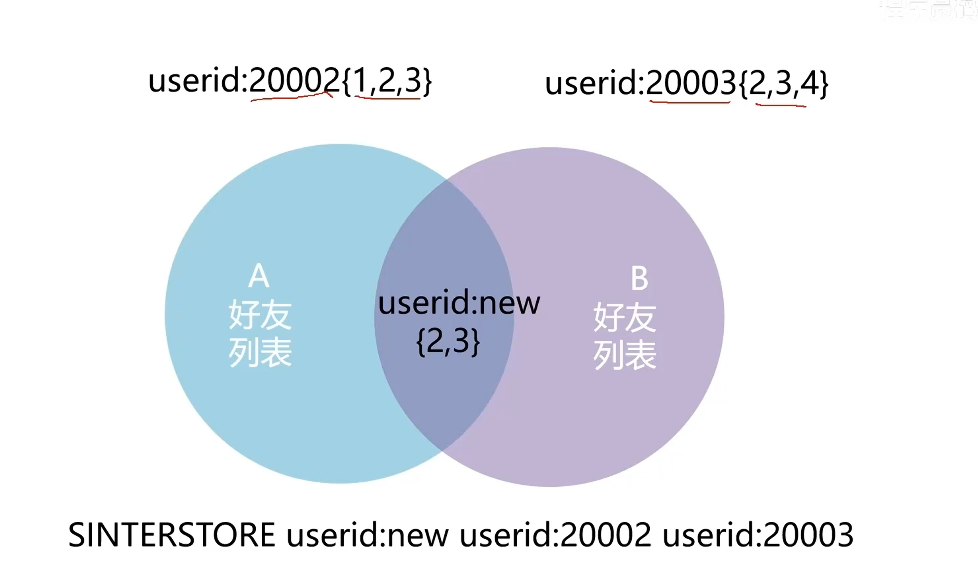
统计双方的共同好友
存在 redis set 类型数据 取交集
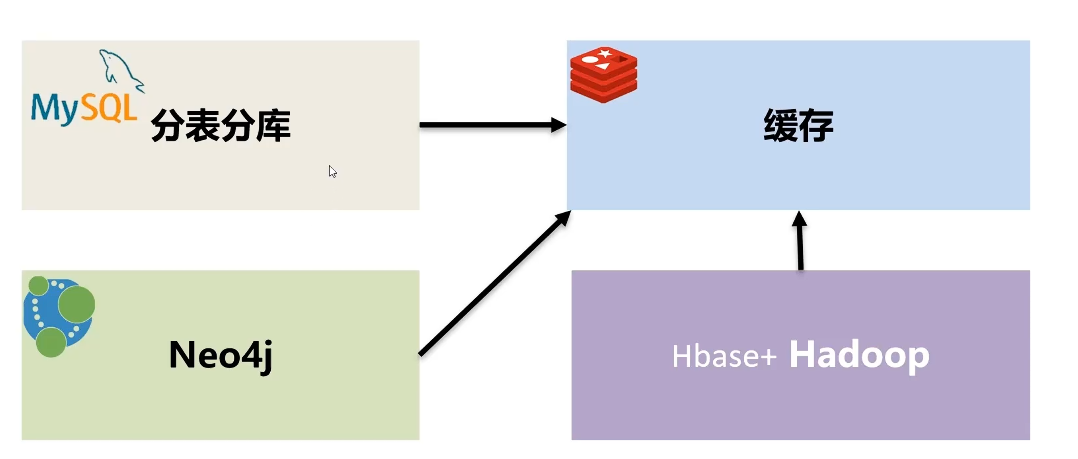
一亿个好友数据放入 关系型数据库,neo4j、 nosql 数据库等
一亿用户实时积分排行榜
通过 Redis ZSet 数据类型实现
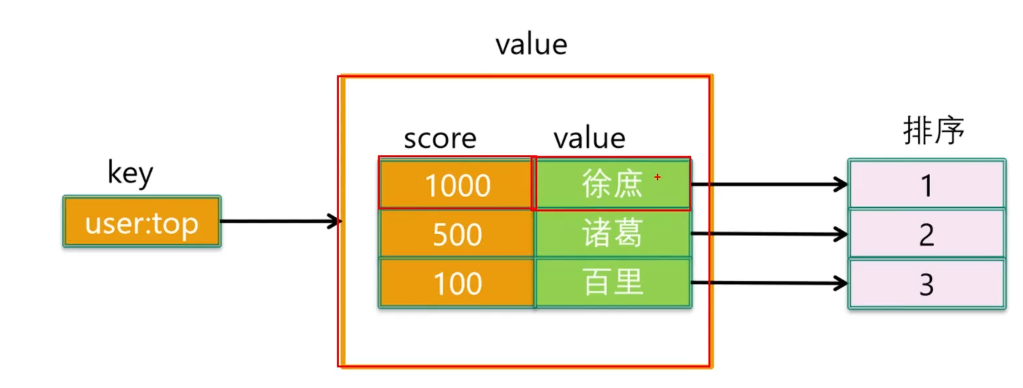
//插入或更新用户金额
public void updateUserPoints(String userId, double amount) {
    ...
	redisTemplate.opsForZSet().add(RANKING_KEY, userId,amount);
}
//获取用户的当前金额
public Double getUserPoints(String userId) {
    ...
	return redisTemplate.opsForZSet().score(RANKING_KEY, userId);
}

//获取排行榜前N名的用户
public Set<ZSet0perations.TypedTuple<String>> getTopNUsers(int n) {
	return redisTemplate.opsForZSet().reverseRangeWithScores(RANKING_KEY,  0, n - 1);
}
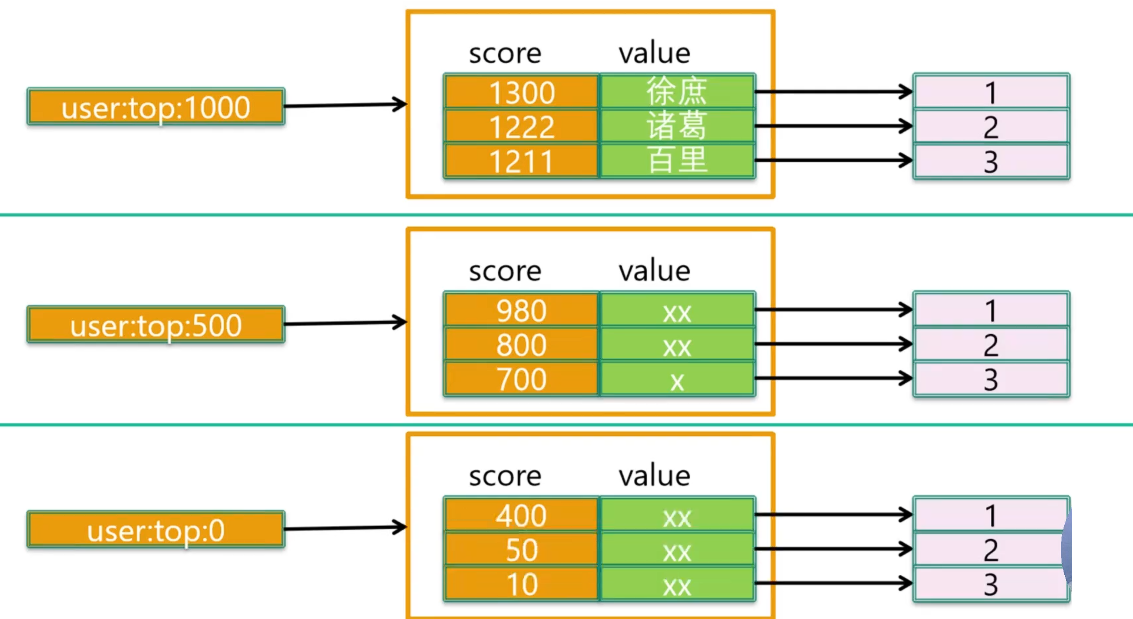
但是当用户量达到一亿级别,该 key 会变成大 key,继而出现延迟、堵塞,导致吞吐量降低
解决: 分桶,将不同值范围的 key 存储到不同的 key 中
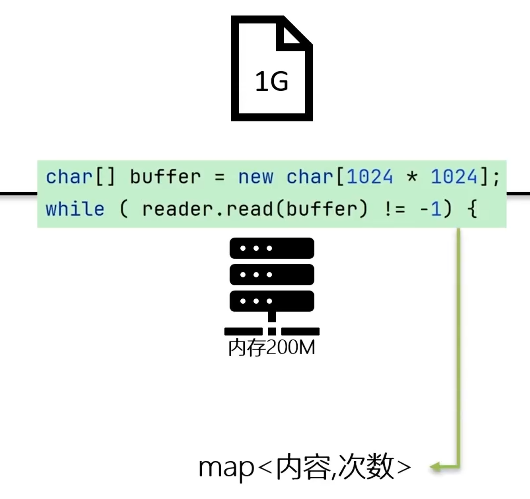
内存 200M 读取 1G 文件并统计内容出现次数
为了避免 OOM,通过缓冲区分块读取,将每个字符存储到 map 的 key 当中
极端情况下,文件每一个字符都不重复,那么就会产生大量的 key,导致内存撑爆。
解决:进行文件分片,对每一个字符进行取模 1024 运算,分别存入 1024 个分片文件。
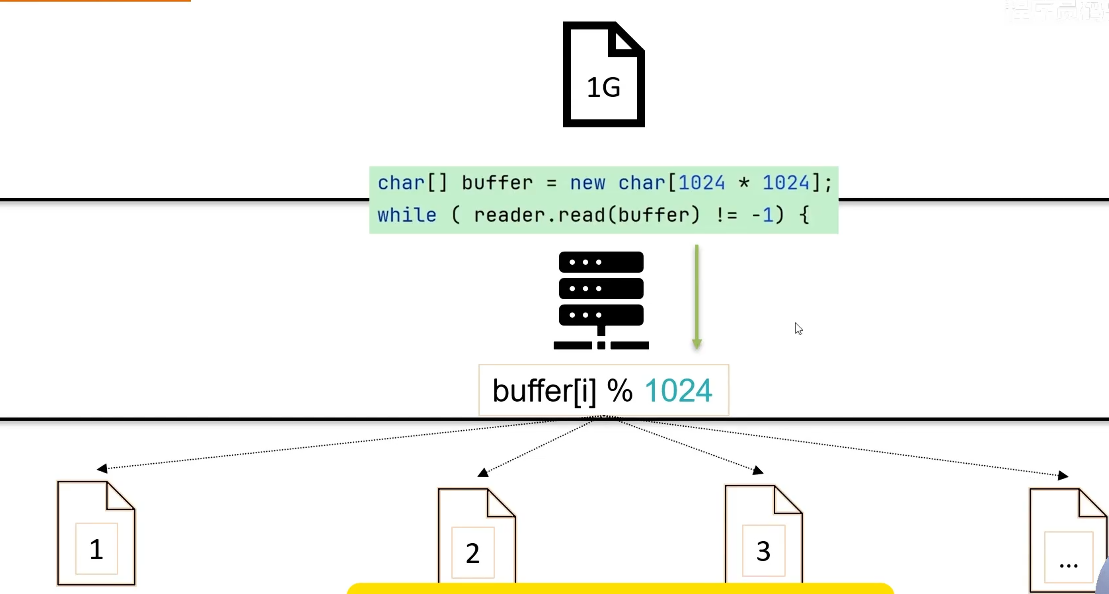
分片完成后,逐个统计每个分片文件的内容出现次数
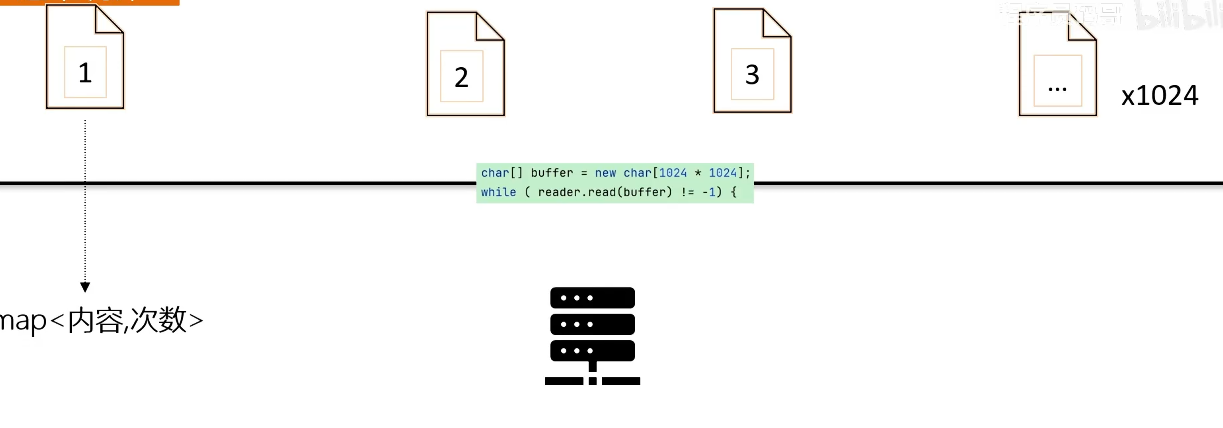
利用多线程提高查询效率
查询 200 条数据耗时 200ms 怎么在 500ms 内查询 1000 条数据?
利用多线程异步查询
// 创建线程池
ExecutorService executor = Executors.newFixedThreadPool(nThreads: 5);
List<Future<List<String>>> futures = new ArrayList<>();
List<String> finalResult = Collections.synchronizedList(new ArrayList<>());

//创建5个任务,每个任务调用一次接口
for (int i = 0; i < 5; i++) {
	futures.add(executor.submit(() -> fetchDataFromAPI()));
}

//等待所有任务完成并合并结果
for (Future<List<String>> future : futures) {
    List<String> result = future.get();
    finalResult.addAll(result);
}
有利于提高多元数据类型看板数据的查询速度
如何解决 MySQL 深分页情况
深分页测试
select  * from employees limit 0, 10;
select  * from employees limit 1000, 10;
select  * from employees limit 10000, 10;
select  * from employees limit 100000, 10;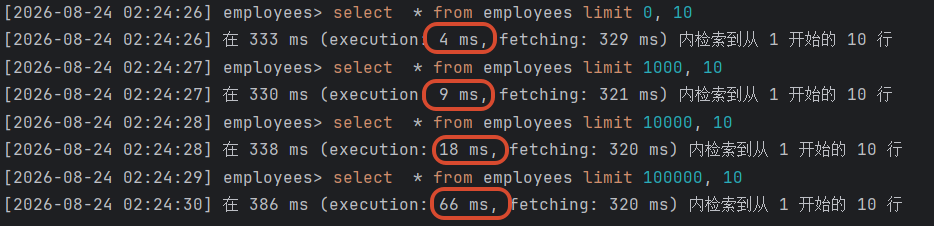
原因:server 层经过分析器(语法解析、预处理),优化器(SQL 优化),由执行器到存储引擎层中查询,返回 100000 + 100 条数据,最后由 server 层筛选 丢弃 100000 条数据,100 条数据,
深分页+二级索引测试
select count(1) from employees; # 300024 条数据
select count(1) from employees where hire_date > '1987-02-05'; # 225260 条数据

alter table employees add index idx_hire_date(hire_date); # 添加索引 以索引方式查询

select emp_no, hire_date, gender from employees where hire_date > '1987-02-05' limit 0, 10; # 非深分页 SQL 示例

select emp_no, hire_date, gender from employees where hire_date > '1987-02-05' limit 200000, 10; # 深分页执行 SQL 示例
如果涉及二级索引回表会更加慢,分析执行流程:
- 通过普通二级索引树 idx_hire_date,过滤 hire_date 条件,找到满足条件的记录 ID。
- 通过 ID,回到主键索引树,找到满足记录的行,然后取出展示的列,即 回表
- 扫描满足条件的 100100 行,然后扔掉前 100000 行,返回。
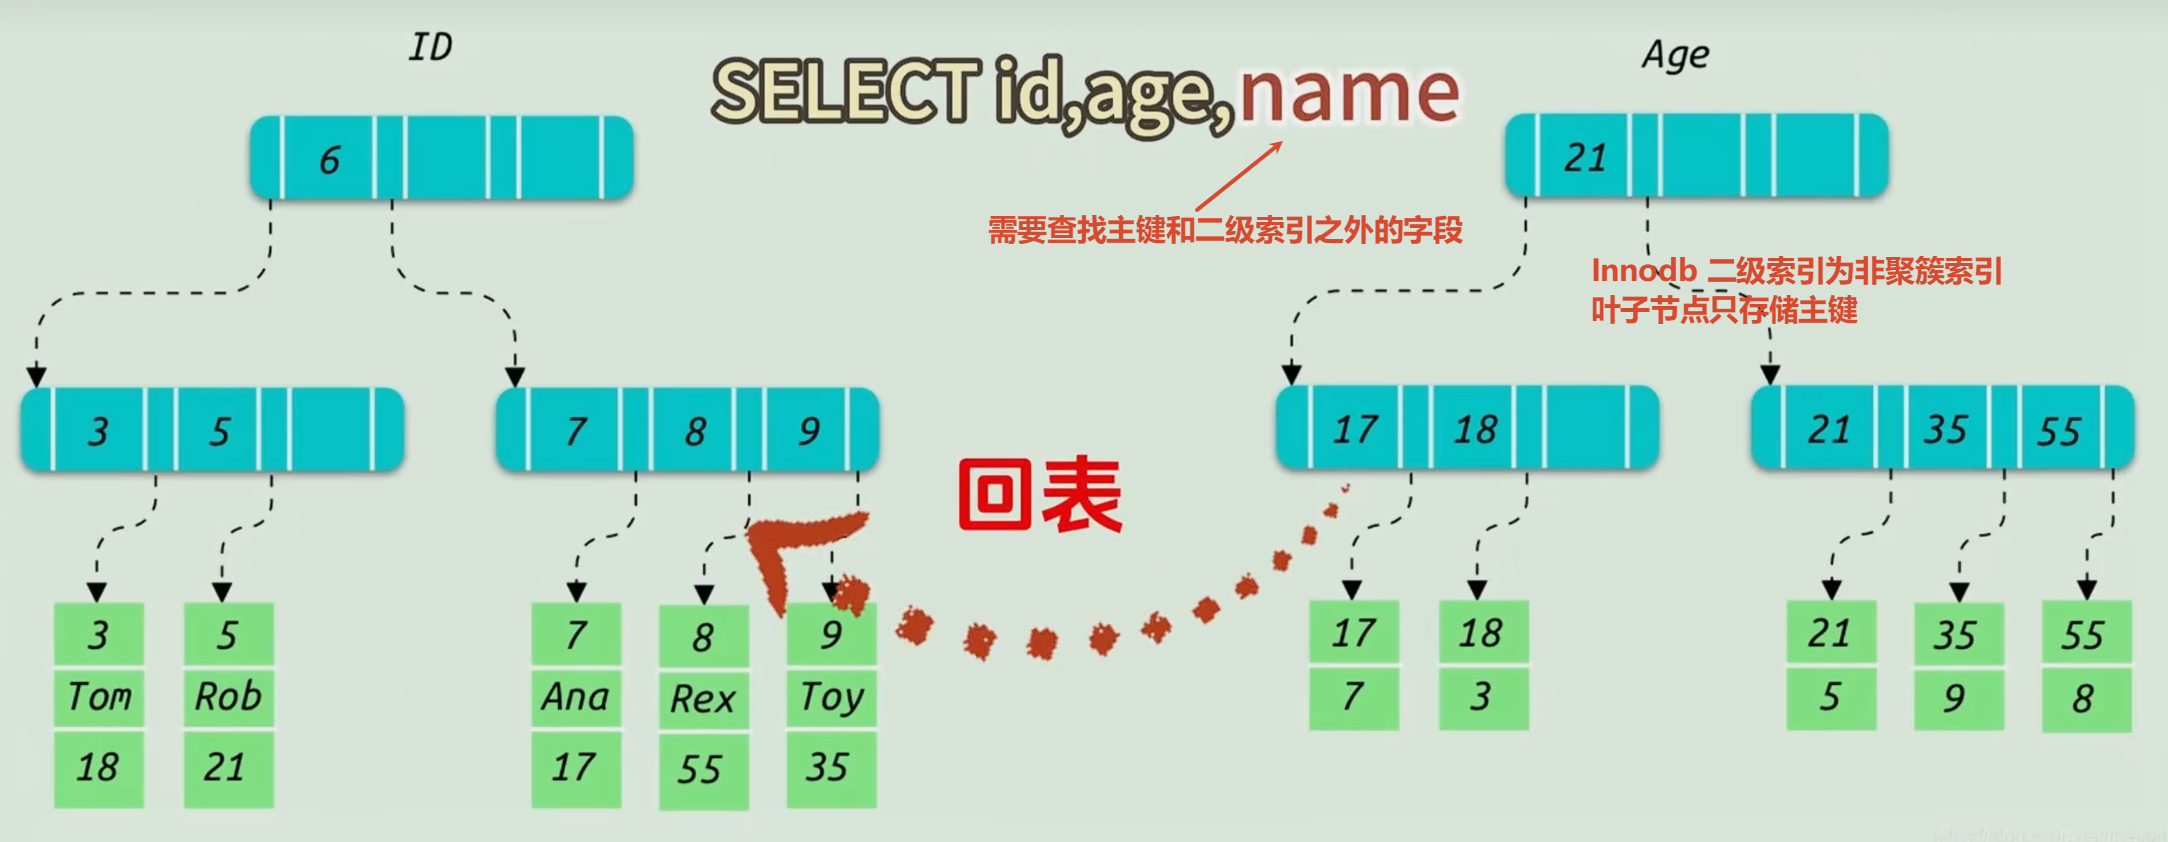
这里很明显的不足就是,明明只需要拿 100 条,却多回表了 100000 次
通过子查询减少回表次数
select * from employees where emp_no in (select emp_no from employees where hire_date > '1987-02-05' limit 200000, 10); # 提示 子查询中不支持使用limit。

select * from employees where emp_no in (select emp_no from (select emp_no from employees where hire_date > '1987-02-05' limit 200000, 10) as t); # 加一层子查询嵌套
INNER JOIN 延迟关联减少回表次数
select e.emp_no, hire_date, gender from employees e inner join (select emp_no from employees where hire_date > '1987-02-05' limit 200000, 10) temp on e.emp_no = temp.emp_no;
这样写是是减少了回表次数,但实际上子查询在二级索引上还是存在深分页的问题
标签记录法
通过记录上一页的最大 id 来限制查询的数据行数。
select emp_no, hire_date, gender from employees where hire_date > '1987-02-05' order by emp_no limit 200000, 10; # 前提 根据主键来排序

select e.emp_no, hire_date, gender  from employees e inner join (select emp_no from employees where hire_date > '1987-02-05' order by emp_no limit 199990, 10) temp on e.emp_no = temp.emp_no; # 得到上一页最大id 466253

select e.emp_no, hire_date, gender  from employees e inner join (select emp_no from employees where hire_date > '1987-02-05' and emp_no > 466253 order by emp_no limit 10) temp on e.emp_no = temp.emp_no; # 该页数据
这种方式只能禁止掉跨页翻看的功能,必须一页一页连续翻看,适合 app 滚动翻页
between and 解决
select id,name FROM table_name where id between 100000 and 100010 order by id;依赖于连续自增的字段(如果不连续,可以 order by 一下 )
分库分表方案
按照数据范围来分表,比如说第 1 条到 第 100 万一个表,第 100 网 条到 第 200 万一个表...
根据需求,查询对应的表即可
ES、大数据方案
适合 千万、亿级别场景