
分布式&微服务治理
分布式基础理论
分布式理论
分布式理论 包含 CAP 理论和 BASE 理论
分布式系统
《分布式系统原理与范型》定义:
- “分布式系统是若干独立计算机的集合,这些计算机对于用户来说就像单个相关系统”
- 分布式系统(distributed system)是建立在网络之上的软件系统。
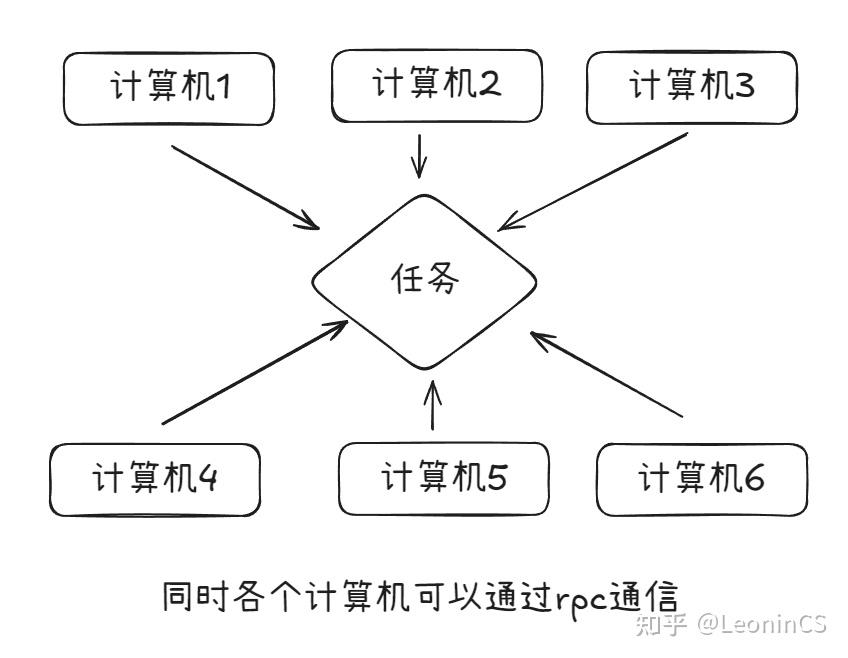
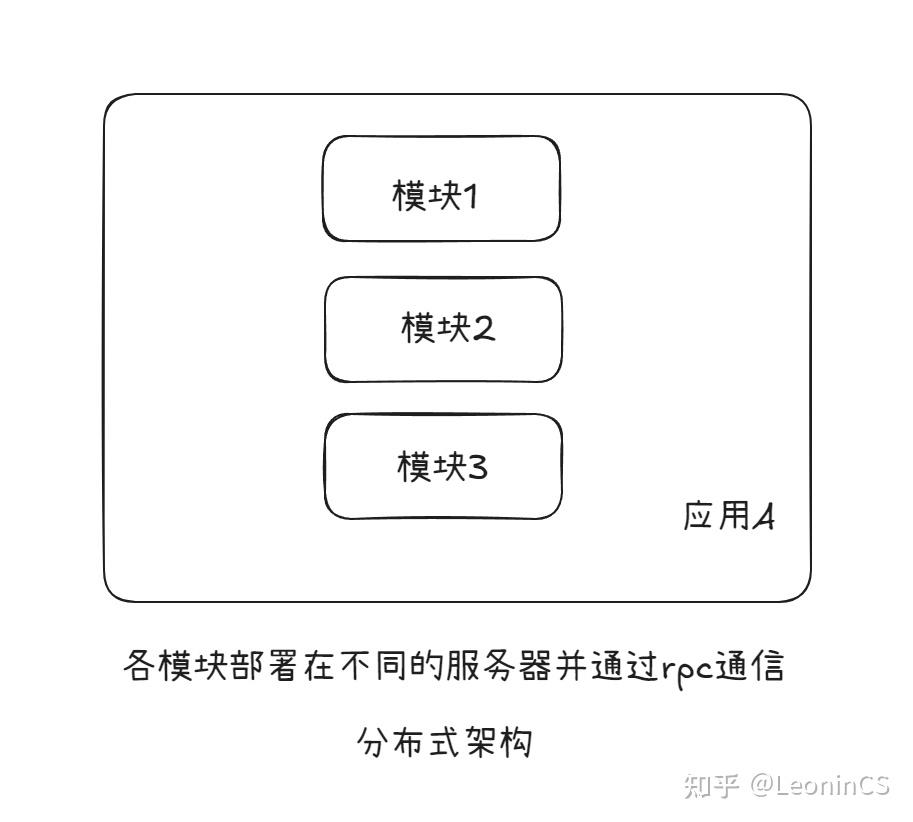
分布式系统是一组相互独立的计算机,通过网络协同工作,共同完成某个任务的系统。其核心在于资源的分布和任务的分解。
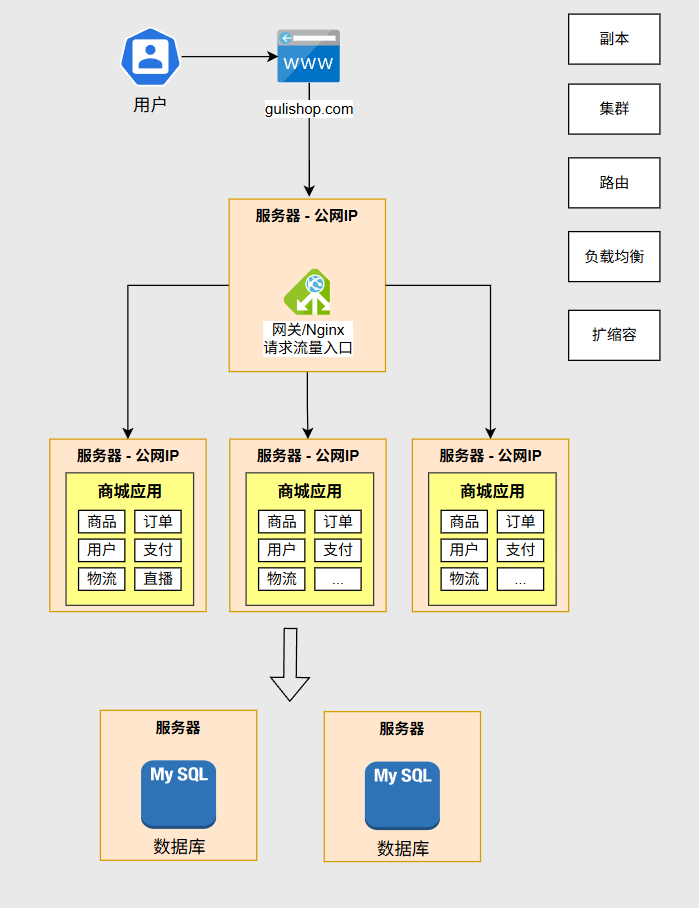
服务器集群
同一个服务的多台服务器同时运行,提供一致的外部访问入口,用于提高性能和可用性。
一般配置负载容器(如 Nginx)实现服务的负载均衡、静态资源缓存、Session 共享。
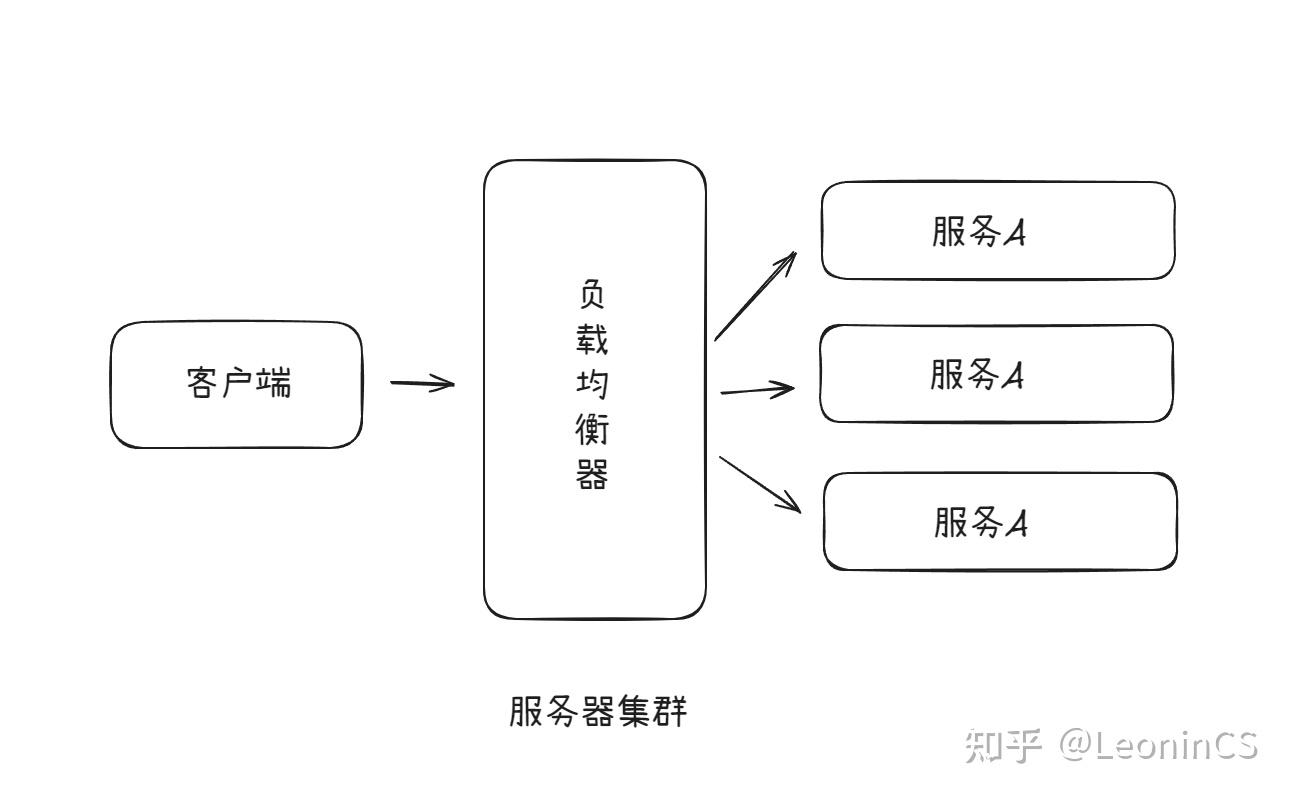
根据是否多台服务器的 业务是否相同 来区别集群还是分布式,分布式是指将不同的业务分布在不同的地方,而集群指的是将几台服务器集中在一起,实现同一业务。
分布式和集群结合,先分布式再集群,具体实现就是业务拆分成很多子业务,然后针对每个子业务进行集群部署,这样每个子业务如果出了问题,整个系统完全不会受影响。
微服务架构
微服务架构是一种软件设计风格,强调 将一个单独的应用程序拆分为多个小型、独立自治的服务,每个小服务运行在自己的进程中,并使用轻量级机制通信,通常是 HTTP。这些服务围绕特定的业务功能构建,可以独立开发、部署和扩展。每个微服务还可以使用不同的语言、不同的数据库来开发,确保服务之间的低耦合。
简而言之:拒绝大型单体应用,基于业务边界进行服务微化拆分,各个服务独立部署运行。
重要特征:
- 单一职责的。一个微服务应该都是单一职责的,这才是“微”的体现,一个微服务解决一个业务问题(注意是一个业务问题而不是一个接口)。
- 面向服务的。将自己的业务能力封装并对外提供服务,这是继承 SOA 的核心思想,一个微服务本身也可能使用到其它微服务的能力。
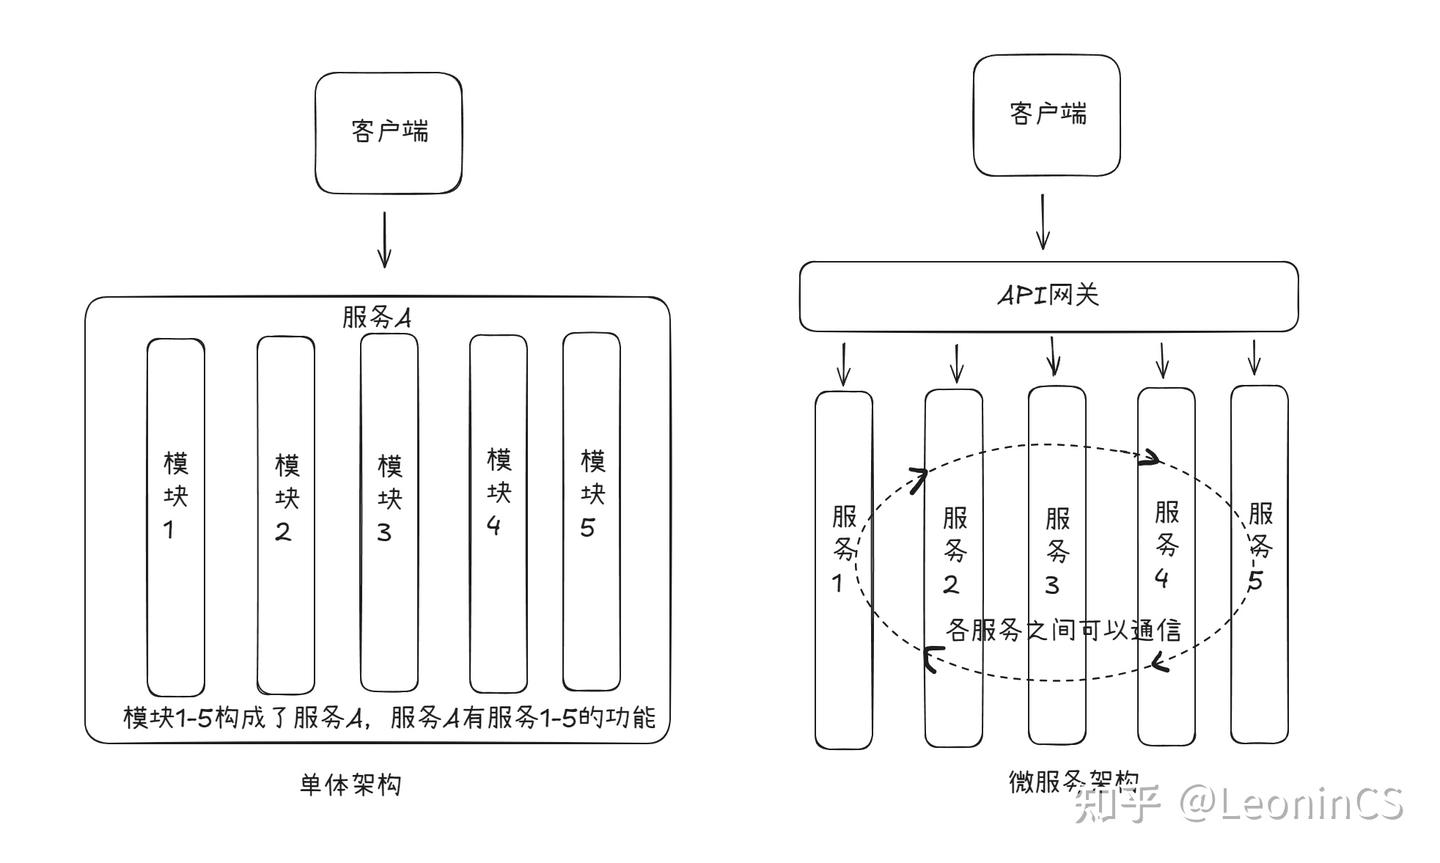
单体架构与微服务架构
微服务架构的 服务 相当于单体架构的 模块,区别在于各个模块互相依赖,而各个服务之间则是互相联系,拆分服务比拆分模块具有更低的业务耦合度,提供更高的协作开发效率。
ps. 想要微服务架构兑现高效率的协作,前提是企业能根据康威定律按照业务范围拆分开发团队。
微服务架构与分布式系统
微服务架构通常是建立在分布式系统的基础之上(也可以是同一个服务器),且两者关注点不同:
- 分布式系统注重系统整体的资源分布和任务分解。分布式系统主要关注跨网络通信、分布式一致性、负载均衡等问题。
- 微服务架构注重应用程序内部的模块划分,通过独立的服务实现业务功能。微服务架构主要关注业务逻辑,每个微服务可以独立开发和部署。
系统概念区分
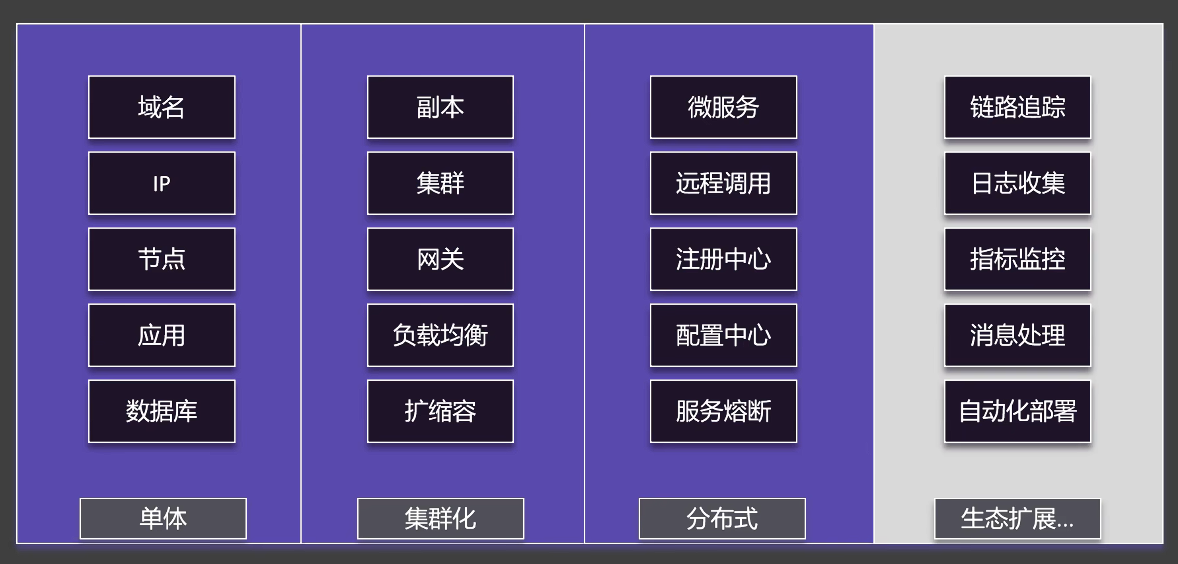
- 分布式系统是一种系统形态,强调多节点协同工作来完成同一任务;
- 微服务架构是一种设计思想,强调将业务拆分成多个独立的小服务;
- 服务器集群则是一种部署方式,强调同一服务运行在多台服务器上以提升性能和可靠性。
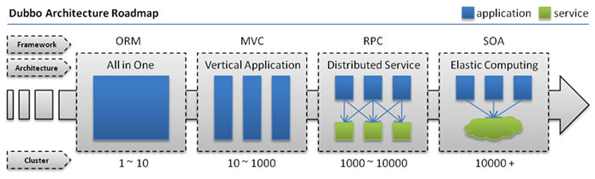
应用架构演变
随着互联网的发展,网站应用的规模不断扩大,常规的垂直应用架构已无法应对,分布式服务架构以及流动计算架构势在必行,亟需 一个治理系统 确保架构有条不紊的演进。
不同系统关注的概念不同
单一应用架构
也称单体架构(ALL IN ONE),当网站流量很小时,只需一个应用,将所有功能都部署在一起,以减少部署节点和成本。此时,用于简化增删改查工作量的 数据访问框架(ORM) 是关键。
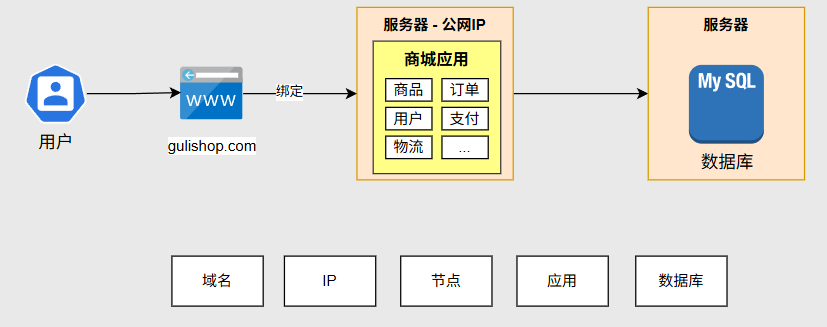
优点:小型系统,开发部署简单
缺点:无法应对高并发,不利于性能拓展,不利于升级维护,不利于协同开发
垂直应用架构
当访问量逐渐增大,单一应用增加机器带来的加速度越来越小,将应用拆成互不相干的几个应用,以提升效率。此时,用于加速前端页面开发的 Web 框架(MVC) 是关键。
优点:一定程度上解决单一应用框架的缺点
缺点:公用模块无法重复利用,开发性的浪费; 界面与业务逻辑未分离; 大量应用之间需要交互。
分布式服务架构
当垂直应用越来越多,应用之间交互不可避免,将核心业务抽取出来,作为独立的服务,逐渐形成稳定的服务中心,使前端应用能更快速的响应多变的市场需求。此时,用于提高业务复用及整合的 分布式服务框架(RPC) 是关键。
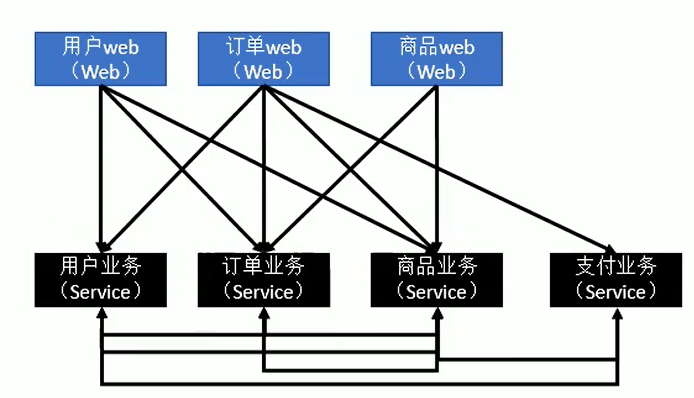
优点:多语言开发、模块化升级、多团队协作
流动计算架构
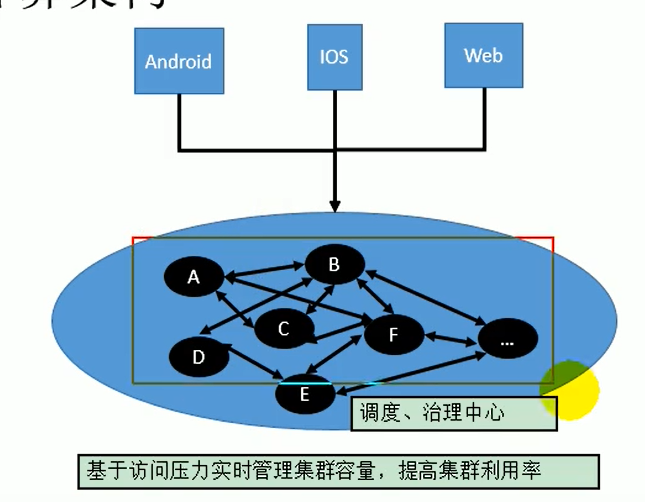
当服务越来越多,容量的评估,小服务资源的浪费等问题逐渐显现,此时需增加一个调度中心基于访问压力实时管理集群容量,提高集群利用率。此时,用于提高机器利用率的 资源调度和治理中心 是关键。
远程过程调用
RPC(Remote Procedure Call)是指远程过程调用,是一种进程间通信方式,他是一种 技术的思想,而不是规范。它允许程序调用另一个地址空间(通常是共享网络的另一台机器上)的过程或函数,而不用程序员显式编码这个远程调用的细节。即程序员无论是调用本地的还是远程的函数,本质上编写的调用代码基本相同。
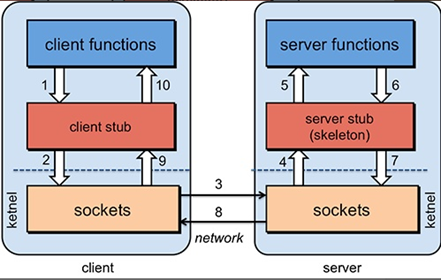
在分布式系统中,各个服务可能处于不同主机,但是服务之间不可避免的需要互相调用,也就需要远程过程调用。SpringCloud 中使用 HTTP+JSON 的方式完成远程调用。
RPC 两个核心模块:通讯,序列化。
常见的 RPC 框架由 Dubbo、gRPC、Thrift、HSF(High Speed Service Framework)。
服务治理
应用微服务化之后,会出现一些问题:
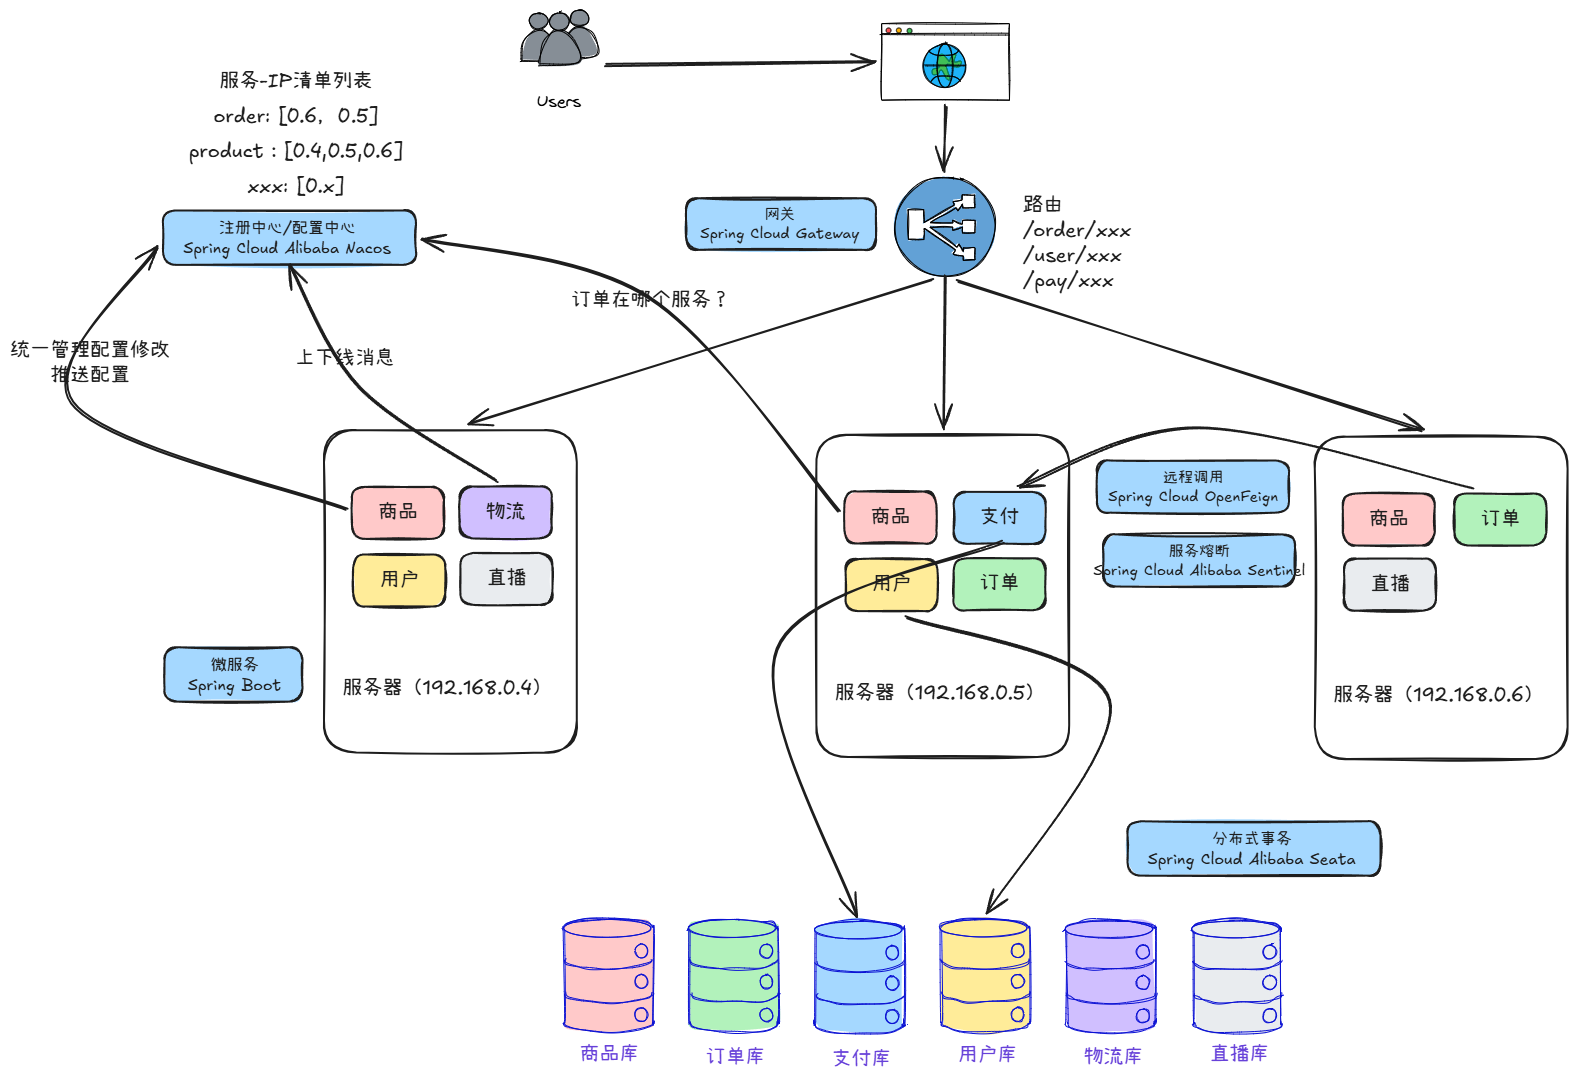
- 服务发现问题。一个微服务如何发现其他微服务呢?最简单的方式就是每个微服务里面配置其他微服务的地址,但是当微服务数量众多的时候,这样做明显不现实。所以需要使用到微服务架构中的一个最重要的组件:服务注册中心,所有服务都注册到服务注册中心,同时也可以从服务注册中心获取当前可用的服务清单。
- 服务配置管理的问题。当服务数量超过一定程度之后,如果需要在每个服务里面分别维护每一个服务的配置文件,运维人员估计要哭了。那么,就需要用到微服务架构里面第二个重要的组件:配置中心。
- 通过熔断、限流等机制保证高可用?
- 微服务之间调用的负载均衡?
- 分布式事务(2PC、3PC、TCC、LCN 等)?
- 服务调用链跟踪等等?
- ...
以上引用了服务治理常用组件方案,最终形成典型微服务架构(其中包含网关、缓存、结构性存储、数据库、消息队列、容器部署、分布式存储、大数据等中间件):
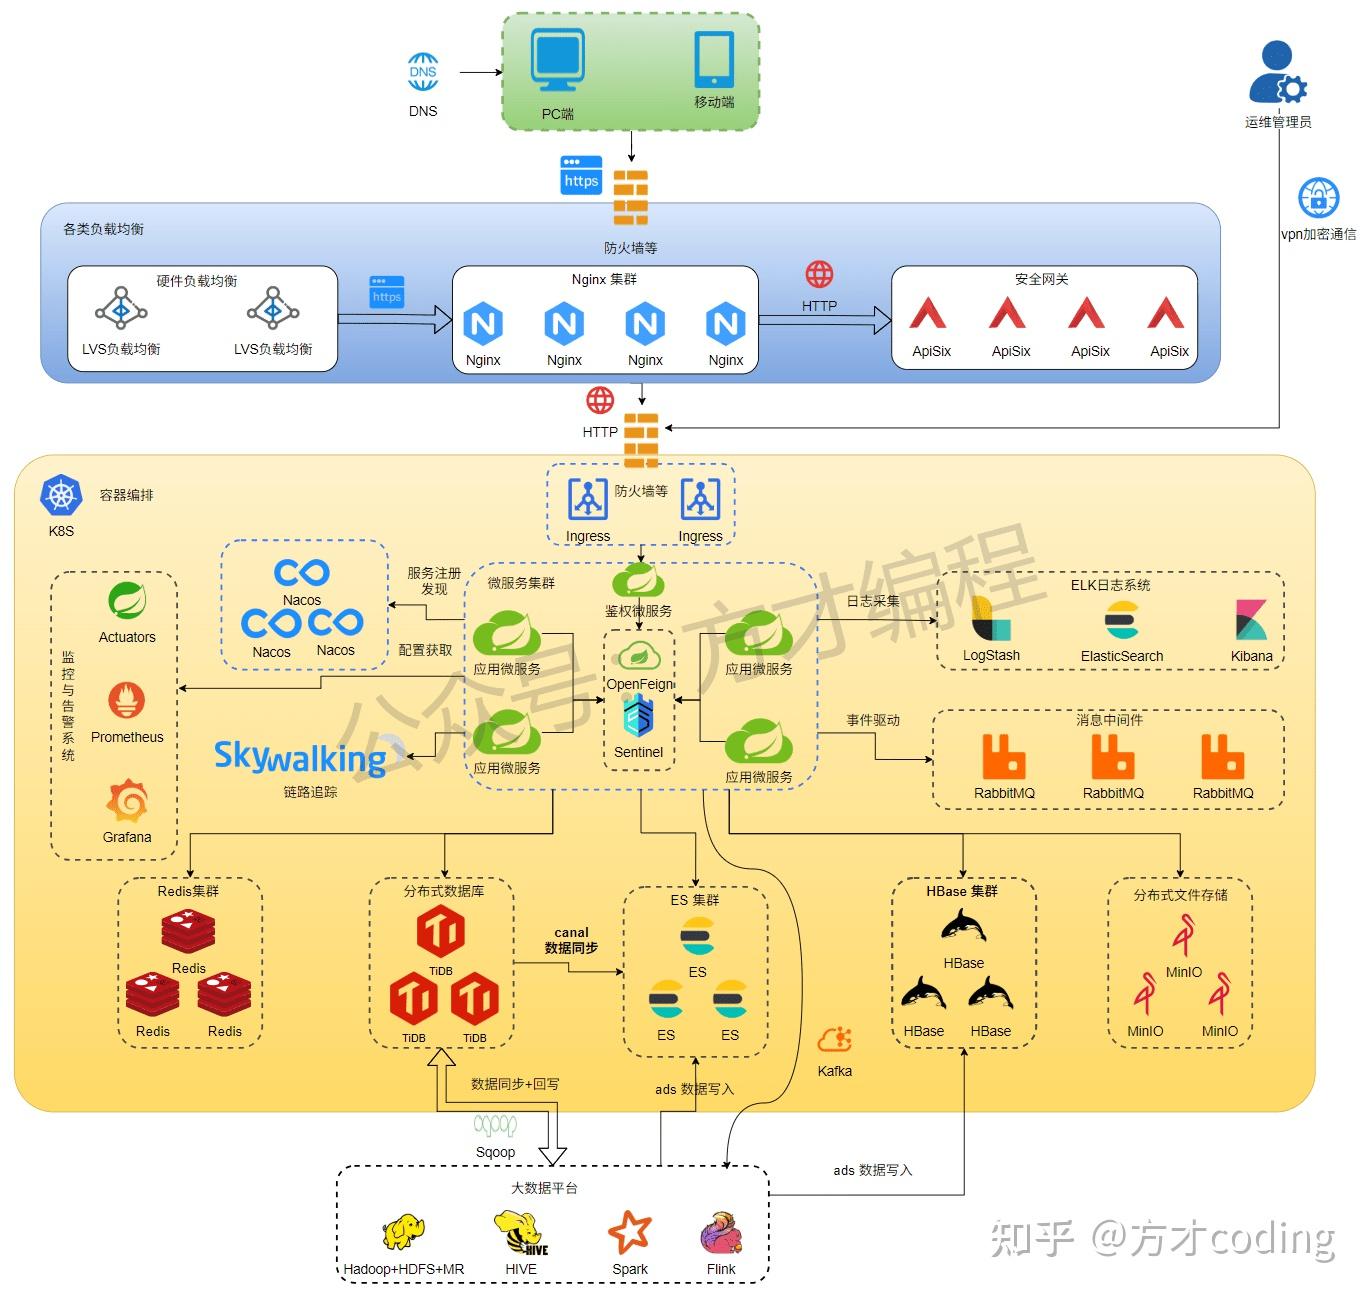
为了让开发人员专注于业务设计,我们需要微服务框架来快速构建分布式系统,治理微服务带来的混乱,目前国内企业使用的微服务框架主要是 Spring Cloud 和 Dubbo(或者 DubboX),但是 Dubbo 那两年的停更严重打击了开发人员对它的信心,Spring Cloud 已经逐渐成为主流。
负载均衡
分布式系统中,A 服务需要调 ⽤ B 服务,B 服务在多台机器中都存在,A 调 ⽤ 任意 ⼀ 个服务器均 可完成功能。 为了使每 ⼀ 个服务器都不要太忙或者太闲,我们可以负载均衡的调 ⽤ 每 ⼀ 个服务 器,提升 ⽹ 站的健壮性。
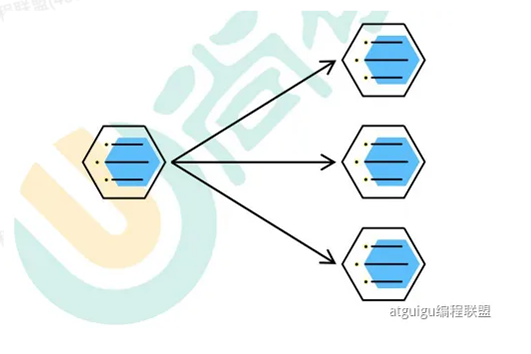
常 ⻅ 的负载均衡算法:
- 轮询:为第 ⼀ 个请求选择健康池中的第 ⼀ 个后端服务器,然后按顺序往后依次选择,直到最后 ⼀ 个,然后循环。
- 最 ⼩ 连接:优先选择连接数最少,也就是压 ⼒ 最 ⼩ 的后端服务器,在会话较 ⻓ 的情况下可以考 虑采取这种 ⽅ 式。
- 散列:根据请求源的 IP 的散列(hash)来选择要转发的服务器。这种 ⽅ 式可以 ⼀ 定程度上保 证特定 ⽤ 户能连接到相同的服务器。如果你的应 ⽤ 需要处理状态 ⽽ 要求 ⽤ 户能连接到和之前相 同的服务器,可以考虑采取这种 ⽅ 式。
服务注册与发现
A 服务调 ⽤ B 服务,A 服务并不知道 B 服务当前在哪 ⼏ 台服务器有,哪些正常的,哪些服务已经 下线。解决这个问题可以引 ⼊ 注册中 ⼼。
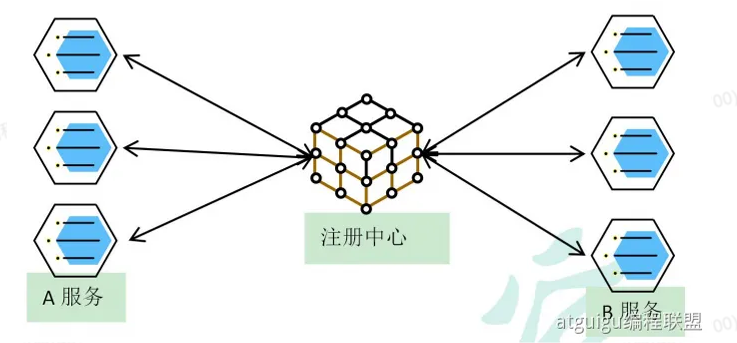
如果某些服务下线,我们其他 ⼈ 可以实时的感知到其他服务的状态,从 ⽽ 避免调 ⽤ 不可 ⽤ 的服务
配置中心
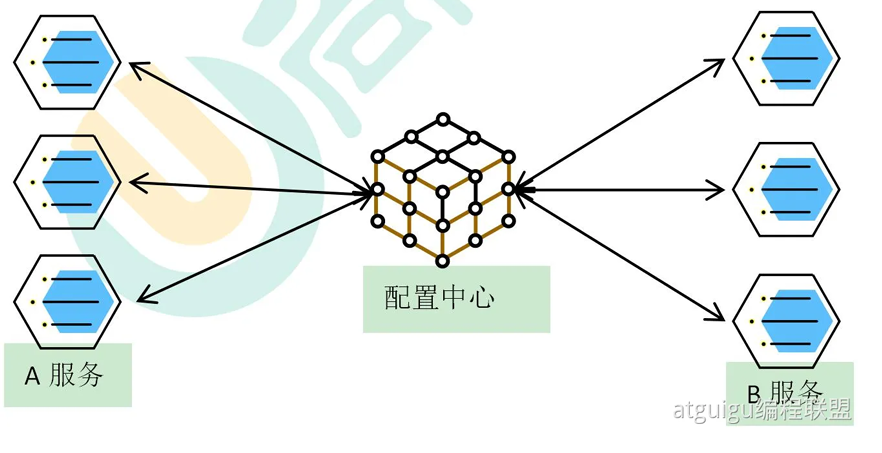
每 ⼀ 个服务最终都有 ⼤ 量的配置,并且每个服务都可能部署在多台机器上。我们经常需要变更配 置,我们可以让每个服务在配置中 ⼼ 获取 ⾃⼰ 的配置。
配置中 ⼼⽤ 来集中管理微服务的配置信
服务熔断与降级
在微服务架构中,微服务之间通过 ⽹ 络进 ⾏ 通信,存在相互依赖,当其中 ⼀ 个服务不可 ⽤ 时,有可 能会造成雪崩效应。要防 ⽌ 这样的情况,必须要有容错机制来保护服务。
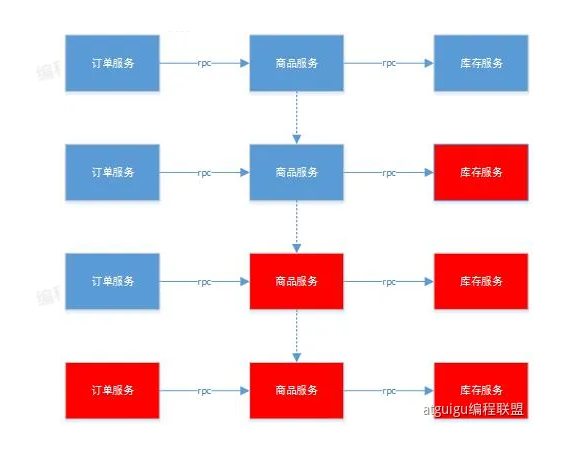
服务熔断
设置服务的超时,当被调 ⽤ 的服务经常失败到达某个阈值,我们可以开启断路保护机制,后来的请 求不再去调 ⽤ 这个服务。本地直接返回默认的数据
服务降级
在运维期间,当系统处于 ⾼ 峰期,系统资源紧张,我们可以让 ⾮ 核 ⼼ 业务降级运 ⾏。降级:某些服 务不处理,或者简单处理【抛异常、返回 NULL、调 ⽤ Mock 数据、调 ⽤ Fallback 处理逻辑】
API 网关
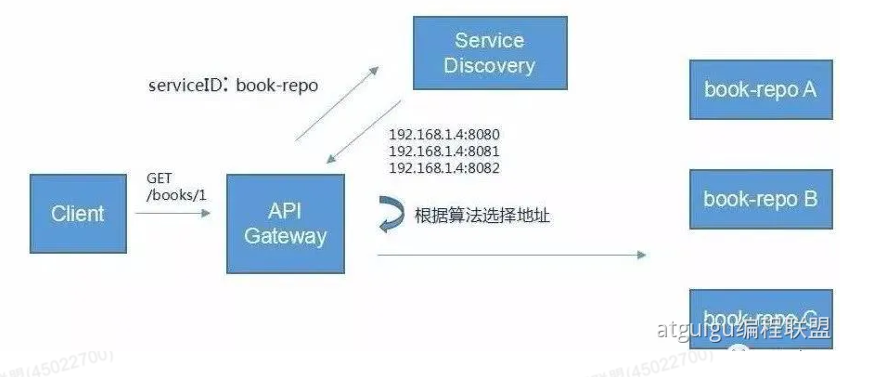
在微服务架构中,API Gateway 作为整体架构的重要组件,它抽象了微服务中都需要的公共功 能,同时提供了客户端负载均衡,服务 ⾃ 动熔断,灰度发布,统 ⼀ 认证,限流流控,⽇ 志统计等丰 富的功能,帮助我们解决很多 API 管理难题。
接口幂等性
接口幂等性概念
接口幂等性就是指,不管调用了接口多少次,对系统的最终影响都应该是相同的,系统的状态和返回的结果都应该保持一致。
查询天生幂等,因为查询不会使系统产生数据的变化; 删除也是幂等的,因为删除多次和删除一次都是一样的; 更新需要看情况; 插入需要特别注意幂等性。
接口幂等性实战
查询校验,避免重复改库 -> 分布式锁
基本逻辑:用户下单支付,通过订单号生成支付单 问题:容易出现重复下单支付现象 原因:用户多次点击(前端防重复点击的效果是有限的)、客户端超时重试机制(接口性能较差处理慢)
@Service
@DubboService(version = "1.0.0")
public class OrderServiceImpl implements OrderService {
    @override
    createPaymerftNo_初始版本(CreateOrderRequest request) {
    public CreateOrderResponse
        //1.调用支付单创建方法
        String paymentNo = createPaymentorder(request);
        //2.组装返回对象
        CreateOrderResponse response = new CreateUrderResponse():
        response.setCode("200");
        response.setMessage("支付单创建成功");
        response,setPaymentNo(paymentNo);
        return response;
    }
}
解决手段:后端避免重复改库 改进逻辑:通过订单号查询库里是否已经有支付单,如果有则返回对应支付单,没有才进行创建 问题:重复下单支付情况少很多,但是依然有概率发生 原因:多线程同时调用接口,校验结果都是支付单不存在,所以同时创建了支付单。
@Service
@DubboService(version = "1.0.0")
public class OrderServiceImpl implements OrderService {
    @override
    createPaymerftNo_初始版本(CreateOrderRequest request) {
    public CreateOrderResponse
    	//1.根据订单查询支付单
        String arderNo = request.getOrderNo();
        PaymentOrder paymentDrder = queryPaymentOrderByOrderNo(orderNo);
        CreateOrderResponseresponse= new CreateOrderResponse();
        //2.如果支付单存在,则直接返回
        if(0bjects.nonNull(paymentOrder)){
            response.setCode("500");
            response.setMessage("支付单已经存在,请勿重复创建");
            response.setPaymentNo(paymentOrder.getPaymentNo());
            return response;
        }

        //3.调用支付单创建方法
        String paymentNo = createPaymentorder(request);
        //4.组装返回对象
        CreateOrderResponse response = new CreateUrderResponse():
        response.setCode("200");
        response.setMessage("支付单创建成功");
        response,setPaymentNo(paymentNo);
        return response;
    }
}
解决手段:分布式锁 终极逻辑:通过 Redis SETNX 实现分布式锁,锁订单号,同一时间只允许一个线程创建支付单。 效果:彻底解决重复下单支付问题
@Service
@DubboService(version = "1.0.0")
public class OrderServiceImpl implements OrderService {
    @override
    createPaymerftNo_初始版本(CreateOrderRequest request) {
    public CreateOrderResponse
    	//1.根据订单查询支付单
        String arderNo = request.getOrderNo();
        PaymentOrder paymentDrder = queryPaymentOrderByOrderNo(orderNo);
        CreateOrderResponseresponse= new CreateOrderResponse();
        //2.如果支付单存在,则直接返回
        if(0bjects.nonNull(paymentOrder)){
            response.setCode("500");
            response.setMessage("支付单已经存在,请勿重复创建");
            response.setPaymentNo(paymentOrder.getPaymentNo());
            return response;
        }

        //redis分布式锁,锁住这个订单
        String redisKey = "OrderNo_" + orderNo; // 注意用前缀区分业务
        boolean sucess = lock(redisKey, expiredTime: 60L); // 必须设置 key 的超时时间,避免 JVM 发生 OOM或者宕机,导致分布式锁没有释放
        if(!success){ // 未获取到锁的线程,建议自旋重试几次 或者直接报错由客户端进行重试
            response.setCode("500");
            response.setMessage("系统繁忙");
            response.setPaymentNo(null);
            return response;
        }


        StringpaymentNo= null;
        //3.调用支付单创建方法
        try{
        	paymntNo = createPaymentOrder(reque
        } catch (Exception e) {
        	//打错误日志
        }finally {
        	unLock(redisKey); // 释放分布式锁
        }
        //4.组装返回对象
        CreateOrderResponse response = new CreateUrderResponse():
        response.setCode("200");
        response.setMessage("支付单创建成功");
        response,setPaymentNo(paymentNo);
        return response;
    }
}
接口幂等性其他手段
悲观锁(数据库行级共享锁 SELECT ... FOR UPDATE),查询校验时保证绝对的数据安全,但是高并发场景下是造成请求阻塞的性能杀手。
乐观锁(增加 version 字段,更新时验证版本号。UPDATE...SET version= version+1 WHEREid = ? AND version = ?),性能极高且不产生锁竞争,但是需要维护额外的表结构,且 无法防止插入的重复。
唯一索引(给订单号、流水号等天然唯一的字段加上 UNIQUEKEY),实现简单,但是在分库分表的架构下,数据的唯一业务标识实现比较复杂。
防重表(建立一张独立的防重表,仅包含唯一业务 ID,并设置唯一索引。),这有利于分库分表下唯一业务 ID 的实现,但增加了一次数据库 INSERT 操作,会带来额外的性能开销和数据一致性维护成本。
状态机(类似于乐观锁,利用业务状态的单向流转特性。UPDATE...SET status='PAID' WHERE id=?ANDstatus='UNPAID')相比于乐观锁,状态机与业务逻辑结合紧密,可读性好,但适用场景有限,仅适用于那些具有明确、单向状态流转的业务流程,且同样 无法防止插入的重复。
分布式锁(利用 Redis 的 SETNX 命令。SET lock:order:xxx '1' NX EX 60,原子性地尝试获取一个全局唯一的锁。),分布式环境下的标准解法,通用性强,是解决跨服务、跨节点幂等问题的核心利器。缺点是引入了外部依赖(如Redis),增加了系统复杂度和潜在的故障点。锁的可靠性需要精细设计。
Token 令牌(前端在进入页面时先获取一次性令牌,提交时携带。后端通过原子操作(如Redis DEL)校验并销毁令牌。),将防重前置到网关或代码层,能有效防止用户重复点击、网络重试等多种场景,去掉防重逻辑也减少了接口性能的消耗。缺点是需要前后端配合改造,一次业务操作需要两次网络请求(获取、使用),增加了交互复杂性。