
NoSQL 数据库简介
技术发展
技术的分类
- 解决功能性的问题: Java、Jsp、 RDBMS、 Tomcat、HTML、 Linux、JDBC、SVN
- 解决扩展性的问题: Struts、 Spring、 SpringMVc、 Hibernate、 Mybatis
- 解决性能的问题: NoSQL、Java 线程、 Hadoop、 Nginx、MQ、 ElasticSearch+
Web1.0 时代
单点服务器解决大部分问题
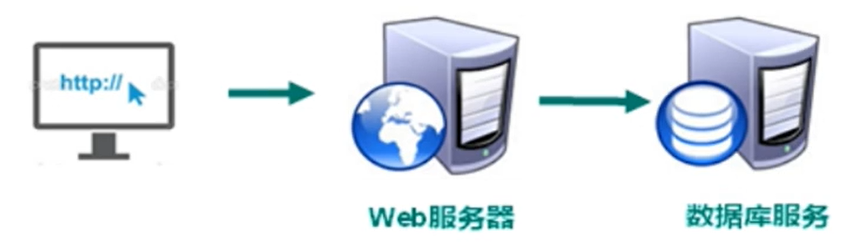
Web2.0 时代
用户访问量大幅度提升,智能移动设备普及,互联网平台面临性能挑战。
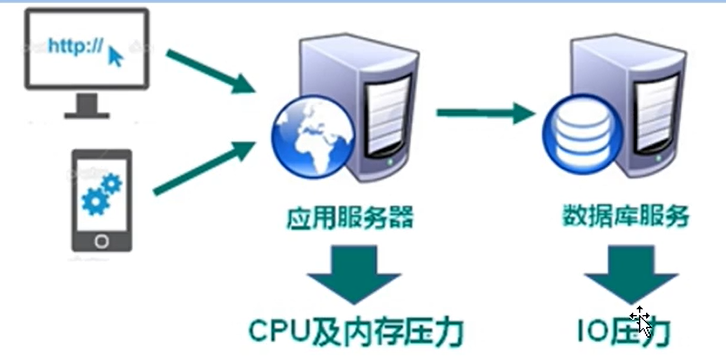
解决 CPU 和内存压力
为了解决该问题,通常使用分布式架构(集群)服务器。
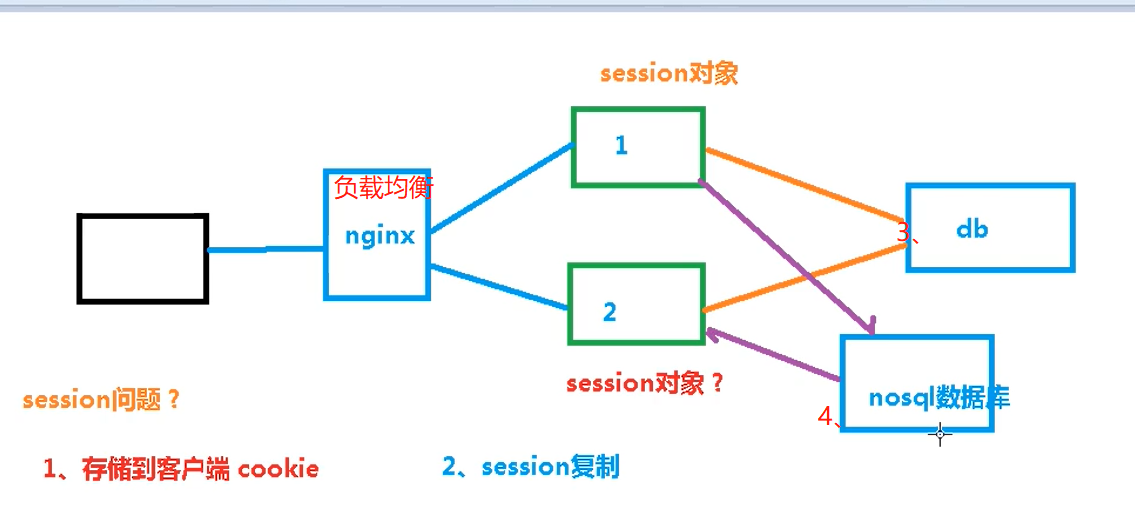
此时如何解决 session 在不同服务器的共享存取问题:
- 存储到客户端中的 cookie,安全性低
- 存储于文件服务器或数据服务器,增大了 IO 压力。
- session 复制 数据冗余,浪费空间
- 缓存于 NoSQL 数据库中,完全在内存中,速度快,数据结构简单
解决 IO 压力
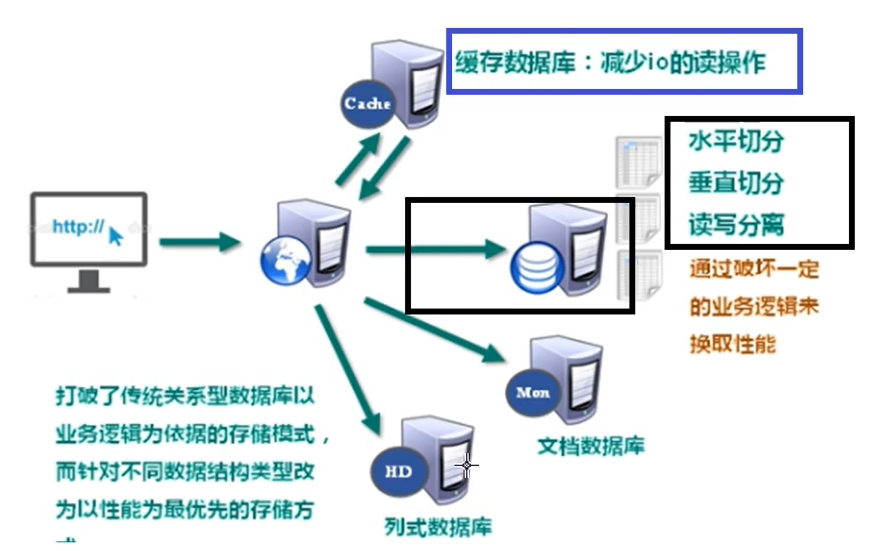
NOSQL 数据库
概述
NoSQL( NOSQL = Not Only SQL), 意即“不仅仅是 SQL”, 泛指非关系型的数据库。“
NOSQL 不依赖业务逻辑方式存储, 而以简单的 key- value 模式存储。因此大大的增加了数据库的扩展能力。
- 非结构化数据
- 数据之间无关联关系
- 不遵循 SQL 标准,数据操作语法不统一
- 不支持事务(ACID),大多能满足基本的一致性(BASE)
- 远超于 SQL 的性能
- 水平扩展
适用场景
- 对数据高并发的读写
- 海量数据的读写
- 对数据高可扩展性的
不适用场景
- 需要事务支持
- 基于 sq 的结构化查询存储, 处理复杂的关系需要即席查询。
- (用不着 sql 的和用了 sq 也不行的情况, 请考虑用 NoSql)
Mem cache(Key-value,键值存储)
HBase(Columnar,列式存储)
Redis(Key-value,,键值类型,命令行操作)
- 几乎覆盖了 Memcached 的绝大部分功能
- 数据都在内存中, 支持持久体、主要用作备份恢复
- 除了支持简单的 key- value 模式, 还支持多种数据结构的存储, 比如 list、set、hash、zset 等
- 一般是作为缓存数据库辅助持久化的数据库
MongoDB(Document,文档存储,函数调用式操作)
- 文档型数据库
- 内存不足,可以存储硬盘
- key- value 模式对 value 尤其 json,提高丰富查询方法
- 一般是作为缓存数据库辅助持久化的数据库
ElasticSearch(Document,文档存储,RESTful 风格 API 操作)
Neo4j(Graph,图存储)
数据库排名
DB-Engines Ranking - popularity ranking of database management systems
Redis 概述
Redis 是什么
Redis 诞生于 2009 年全称是 Remote Dictionary Server,远程词典服务器,是一个基于内存的键值型 NoSQL 数据库。
- Reds 是 key- value 存储系统,value 支持多种不同数据结构,功能丰富。
- 单线程,命令具有 原子性,数据类型都支持 push/pop、 add/remove 及取交集并集和差集及更丰富的操作。
- Redis 支持各种不同方式的 排序。
- 低延迟,速度快(基于 内存、IO 多路复用、良好的 C 语言编码)
- 支持数据 持久化,周期性 的把更新的数据写入磁盘或者把修改操作写入追加的记录文件
- 支持 主从集群、分片集群,水平扩展
- 支持多语言客户端
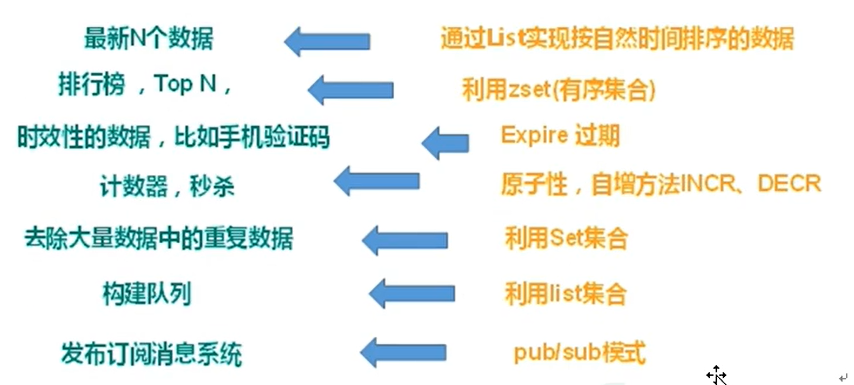
应用场景
配合关系型数据库做高速缓存
高频次, 热门访问的数据, 降低数据库 IO 分布式架构, 做 session 共享
多样的数据结构存储持久化数据
Redis 入门
安装
官方网站:Redis
下载:Download Redis now and learn what fast really means
实际使用都是在 Linux 系统环境下
Redis 是基于 C 语言编写的,因此首先需要安装 Redis 所需要的 C 语言编译环境 gcc 依赖:、
apt install gcc -y
sudo mv redis-6.2.6.tar.gz  /opt/
cd /opt
sudo tar -zxvf redis-6.2.6.tar.gz
cd redis-6.2.6/
sudo make && make install
安装目录:/usr/local/bin
查看默认安装目录 reds-benchmark: 性能测试工具, 可以在自己本子运行, 看看自己本子性能如何 redis-check-aof: 修复有问题的 AOF 文件, rdb 和 aof 后面讲 redis-check-dump: 修复有问题的 dump.rdb 文件 redis-sentinel: Redis 集群使用 reds-server: Reds 服务器启动命令 redis-cli: 客户端, 操作入口
前台启动服务
redis-server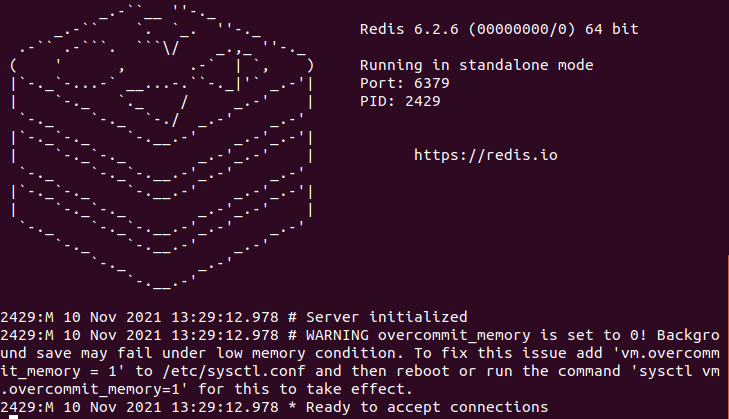
后台启动服务
备份 redis.conf
修改 redis, conf(128 行文件将里面的 daemonize no 改成 yes, 让服务在后台启动
后台启动
  root@ubuntu:/opt/redis-6.2.6# redis-server /etc/redis.conf
 root@ubuntu:/opt/redis-6.2.6# ps -ef|grep redis
root       3118   1838  0 13:38 ?        00:00:00 redis-server 127.0.0.1:6379
root       3124   3083  0 13:39 pts/0    00:00:00 grep --color=auto redis
开机自启
# 编辑服务单元文件
vim /etc/systemd/system/redis.service[Unit]
Description=redis-server
After=network.target
[Service]
Type=forking
ExecStart=/usr/local/bin/redis-server /usr/local/src/redis-6.2.6/redis.confPrivateTmp=true
[Install]
WantedBy=multi-user.target# 重载系统服务
systemctl daemon-reload
# 控制 redis 服务
systemctl start redis
systemctl stop redis
systemctl restart redis
systemctl status redisRedis 客户端
命令行客户端访问
root@ubuntu:/opt/redis-6.2.6# redis-cli
127.0.0.1:6379> ping
PONG
redis 关闭
127.0.0.1:6379> shutdown
not connected> exitroot@ubuntu:/opt/redis-6.2.6# ps -ef | grep redis
root 3152 1838 0 13:44 ? 00:00:00 redis-server 127.0.0.1:6379
root 3159 3083 0 13:44 pts/0 00:00:00 grep --color=auto redis
root@ubuntu:/opt/redis-6.2.6# kill -9 3152
root@ubuntu:/opt/redis-6.2.6# ps -ef | grep redis
root 3162 3083 0 13:45 pts/0 00:00:00 grep --color=auto redis其中常见的 options 有:
-h 127.0.0.1:指定要连接的 redis 节点的 IP 地址,默认是 127.0.0.1-p 6379:指定要连接的 redis 节点的端口,默认是 6379-a 123321:指定 redis 的访问密码- 为了安全性,可以不指定密码,先进入交互通过
auth来设置密码
- 为了安全性,可以不指定密码,先进入交互通过
其中的 commonds 就是 Redis 的操作命令,例如:ping:与 redis 服务端做心跳测试,服务端正常会返回 pong。不指定 commond 时,会进入 redis-cli 的交互控制台。
图形化客户端访问
Windows Redis 的图形化桌面客户端源码:redis/RedisDesktopManager
安装包地址:Releases · lework/RedisDesktopManager-Windows
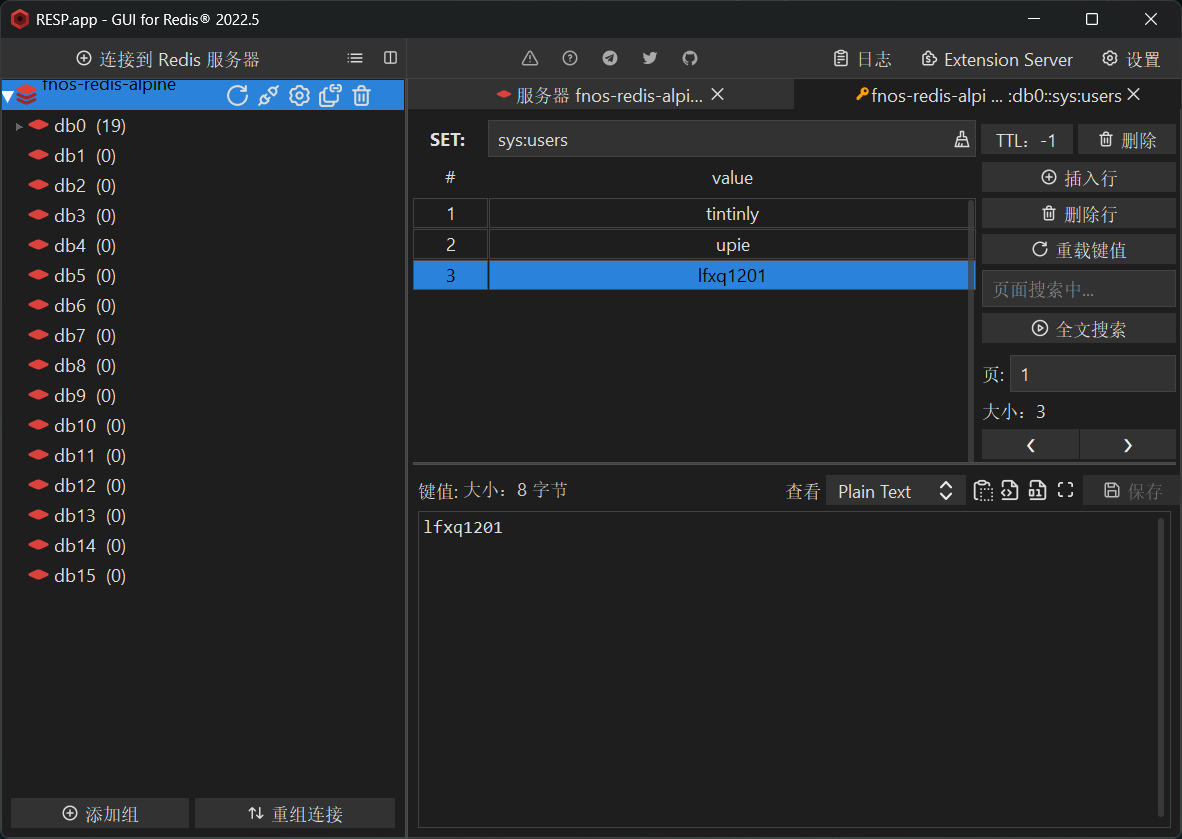
Redis 基础知识
数据库
默认 16 个数据库, 类似数组下标从 0 开始, 初始默认使用 0 号库
- 使用命令
select <dbid>来切换数据库。如: select8 - 统一密码管理, 所有库同样密码。
- dbsize 查看当前数据库的 key 的数量
- flushdb 清空当前库
- flushall 通杀全部库。
线程模型
- 4 版本之前是 单线程。Redis 的核心逻辑(网络 IO、命令处理、数据操作)由单个主线程完成。
- 从 4 开始慢慢支持多线程。启动少量后台线程处理 非核心任务,如 RDB 持久化、AOF 重写、异步删除。
- 直到 redis6/7 开始 全面支持多线程。多个线程处理网络 IO,解决 Redis 网络 IO 上的性能瓶颈。但命令处理、数据操作仍由主线程专属负责。
Redis 4 之前采用单线程的原因
Redis 4 以前的网络 IO 和键值对读写是由一个线程来完成的,有以下好处
- 开发维护简单,无需设计复杂的同步机制
- 避免了多线程模型中的上下文切换和锁竞争问题导致的性能消耗
- 虽然是单线程,但也可以并发处理多客户端的请求(IO 多路复用和非阻塞 IO)
- 对于 redis 系统,主要的性能瓶颈是内存/网络带宽,而非 CPU。
引入多线程特性的原因
- 随着硬件的发展,多核 CPU 已经成为常态,引入多线程可以更大限度的利用 CPU
- 单线程 del 指令删除大 key 数据会造成主线程卡顿。
- 多线程负责扛住高并发的网络流量
I/O 多路复用技术
多路复用是指使用一个线程来检查多个文件描述符( Socket)的就绪状态, 比如调用 select 和 pol 函数, 传入多个文件描述符, 如果有—个文件描述符就绪, 则返回, 否则阻塞直到超时。得到就绪状态后进行真正的操作可以在同一个线程里执行, 也可以启动线程执行(比如使用线程池)
- 阻塞 I/O (BIO) : 一个连接一个线程,线程在等待数据的网络传输时被挂起 (
block)。 - 非阻塞 I/O (NIO) : 主线程不断地轮询 (polling) 所有连接。虽然不会被阻塞,但大量的轮询会消耗巨量 CPU,做了很多无用功。
- I/O 多路复用:这里“多路”指的是多个网络连接客户端,“复用”指的是复用同一个线程(主线程)。只有当连接真正有数据时,才会通知主线程去处理。从而就不会出现 I/O 堵塞的问题,提高了网络通信的性能。
实现原理:
- 客户端与 Redis 服务端建立连接时,会生成套接字描述符(文件描述符的一种)。
- Redis 将所有的套接字描述符全部注册在 I/O 多路复用程序 的监听队列中。将客户端的命令(read、write 等操作)封装成一个个事件,并绑定到对应的套接字描述符上。此步骤可以在多线程下进行。
- 文件事件处理器 是在单线程上运行的,但可以通过 I/O 多路复用程序模块可以同时对多个套接字描述符进行监控,当其中一个 client 端达到写或读的状态,文件事件处理器就马上执行。
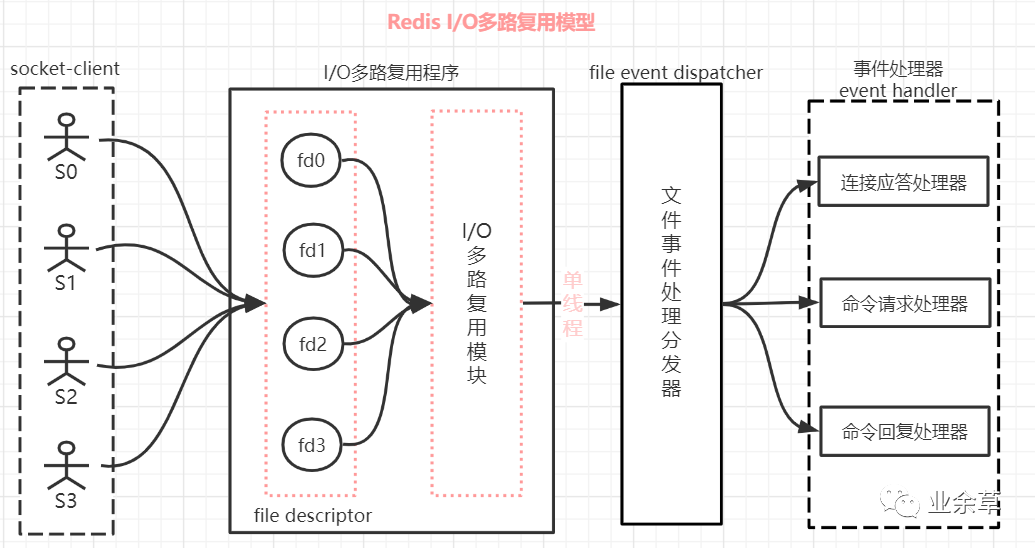
内存回收机制
当内存不足执行写入操作时:
- allkeys-lru:在所有键中移除最近最少使用的键。(最常用的)
- volatile-lru:在有过期时间的键中移除最近最少使用的键。前提:回收足已容纳新添加数据的空间
- allkeys-random:从所有键中随机回收。
- volatile-random:从有过期时间的键中随机回收。
- allkeys-lfu:在所有键中移除最不常使用的键。
- volatile-lfu:在有过期时间的键中移除最不常使用的键。
- volatile-ttl:在有过期时间的键中移除最早过期的键。
- noeviction:返回一个错误。(默认选项,一般不选用)
回收范围:allkeys 所有键 volatile 有过期时间的键
回收策略:lru 最近最少使用 lfu 最不常使用 random 随机 ttl 最早过期
对于 volatile-xx 的回收机制,若没有足够键回收来容纳新添加的数据,则和 noeviction 差不多。
常见命令及数据类型
Redis 是一个 key-value 的数据库,key 一般是 String 类型,而 value 的类型有:
- 基本类型:String、Hash、List、Set、SortedSet、
- 特殊类型:GEO、BitMap、HyperLog
命令帮助
help
help @<group>
help <command>
help <tab>
键 Key
简介
Redis 的 key 允许有多个单词形成层级结构,多个单词之间用 : 隔开,示例格式如下:
项目名:业务名:类型:id常见命令
keys <pattern>查看符合模式的所有 key,不建议在生产环境设备的主节点上使用exists <key>判断某个 key 是否存在type <key>查看你的 key 是什么类型del <key>删除指定的 key 数据unlink <key>根据 value 选择非阻塞删除,仅将 keys 从 keyspace 元数据中删除, 真正的删除会在后续异步操作。expire <key> <seconds>为给定的 key 设置过期时间(秒级精度)expire <key> <milliseconds>为给定的 key 设置过期时间(毫秒级精度)expireat <key> <seconds_timestamp>为给定的 key 设置过期时间戳(秒级精度)expireat <key> <milliseconds_timestamp>为给定的 key 设置过期时间戳(毫秒级精度)ttl <key>查看还有多少秒过期,-1 表示永不过期,-2 表示已过期bash127.0.0.1:6379> expire k1 10 (integer) 1 127.0.0.1:6379> ttl k1 (integer) 7 127.0.0.1:6379> ttl k1 (integer) 5 127.0.0.1:6379> ttl k1 (integer) 1 127.0.0.1:6379> ttl k1 (integer) -2 127.0.0.1:6379> ttl k2 (integer) -1
如何淘汰过期的 keys:
- 定期删除(主动式):提取样本判断,若多于 25%的 keys 过期,则删除所有已过期的 keys
- 惰性删除(被动式):当客户端尝试访问 keys 时,keys 过期则删除。
字符串 String
简介
String 是 Redis 最基本的类型,一个 Redis 中字符串 value 最多可以是 512M
根据字符串的格式不同,String 又可以分为 3 类:
- string:普通字符串
- int:整数类型,可以做自增、自减操作
- float:浮点类型,可以做自增、自减操作
String 类型是二进制安全的。意味着 Reds 的 string 可以包含任何数据。比如 jpg 图片或者序列化的对象。
常用命令
set <key> <vaue>添加键值对setnx <key> <vaue>只有在 key 不存在时设置 key 的值setex <key> <vaue>设置 key 的值,并指定有效期mset <key1> <value1> <key2> <value2>同时设置一个或多个 key-vaue 对mget <key1> <key2> <key3>同时获取一个或多个 vamsetnx <key1> <value1> <key2> <value2>同时设置一个或多个 key- value 对, 当且仅当所有给定 key 都不存在。get <key>查询对应键值append <key> <vaue>将给定的<vaue>追加到原值的末尾strlen <key>获得值的长度incr <key>让一个整型的 key 自增 1(原子操作)incrby <key> <num>让一个整型的 key 自增一个步长(原子操作)decr <key>让一个整型的 key 自减 1(原子操作)incrby/ decrby <key> <num>让一个整型的 key 自动增减自定义步长(原子操作)incrbyfloat/ decrbyfloat <key> <num>让一个浮点型的 key 自动增减自定义步长(原子操作)
所谓 原子操作 是指不会被线程调度机制打断的操作; 这种操作一旦开始, 就一直运行到结束, 中间不会有任何 context switch(切换到另线程)。
- 在单线程中, 能够在单条指令中完成的操作都可以认为是原子操作”, 因为中断只能发生于指令之间。
- 在多线程中, 不能被其它进程(线程)打断的操作就叫原子操作。
Reds 单命令的原子性主要得益于 Redis 的单线程。
getrange<key><起始位置><结束位置>获得值的范围, 类似 java 中的 substring, 前包, 后包setrange<key><起始位置>< value>用< value>覆写<key>所储存的字符串值, 从<起始位置>开始索引从 0 开始)。setex <key> <过期时间> < value>设置键值的同时, 设置过期时间, 单位秒。getset <key> <value>以新换旧, 设置了新值同时获得旧值。
数据结构
String 的数据结构为简单动态字符串( Simple Dynamic String, 缩写 SDS)。是可以修改的字符串, 内部结构实现上类似于 Java 的 Array List, 采用 预分配冗余空间的方式来减少内存的频繁分配
字符串最大长度为 512M
内部为当前字符串实际分配的空间 capacity 一般要高于实际字符串长度 len,当 len 大于 capacity 则进行扩容。当字符串长度小于 1M 时,扩容直解加倍现有空间。超过 1M,扩容一次增加 1M 空间。
列表 List
简介
单键多值
列表是简单的字符串列表, 按照插入顺序排序。你可以添加一个元素到列表的头部(左边)或链表尾部(右边)。
它的底层实际是个 双向链表, 对两端的操作性能很高, 通过索引下标的操作中间的节点性能会较差,与 Java 中的 LinkedList 类似,
特性:
- 有序
- 元素可以重 复
- 插入和删除块
- 查询速度一般
常用命令
lpush/ rpush <key1> <value1> <value2> <value3>…从左边/右边插入一个或多个值。lpop/rpop <key>从左边/右边吐出一个值。值在键在, 值光键亡blpop/brpop <key> <timeout>与 LPOP 和 RPOP 类似,只不过在没有元素时等待指定时间,而不是直接返回 nil。类似于 JavaBlockingQueue的poll(time, unit)rpoplpush <key1> <key2>从<key1>列表右边吐出—个值, 插到<key2>列表左边。lrange <key> <start> <stop>, 按照索引下标获得元素(从左到右)lrange mylist 0 -10 左边第一个,1 右边第一个(表示获取所有)
lindex <key> <index>按照索引下标获得元素(从左到右)llen <key>获得列表长度linsert <key> before <vaue> <newvalue>在<value>的后面插入< newvalue>插入值lrem <key> <n> <vaue>从左边删除 n 个 vaue 从左到右)lset <key> <index> <vaue>将列表 key 下标为 index 的值替换成 value.
lpush + lpop 或者 rpush + rpop 模拟一个栈 lpush + rpop 或者 rpush + lpop 模拟一个队列 lpush + brpop 或者 rpush blpop 模拟一个阻塞队列
数据结构
List 的数据结构为快速链表 quickList.
首先在列表元素较少的情况下会使用一块连续的内存存储, 这个结构是 ziplist, 也即是压缩列表。
它将所有的元素紧挨着一起存储, 分配的是一块连续的内存。
当数据量比较多的时候才会改成 quicklist
因为普通的链表需要的附加指针空间太大, 会比较浪费空间。比如这个列表里存的只是 int 类型的数据, 结构上还需要两个额外的指针 prev 和 next
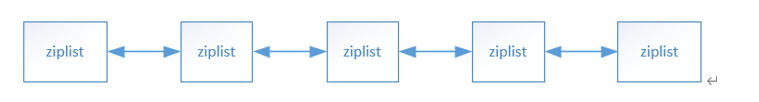
Redis 将链表和 ziplist 结合起来组成了 quicklist。也就是将多个 ziplist 使用双向指针串起来使用。这样既满足了快速的插入删除性能,又不会出现太大的空间冗余。
集合 Set
简介
Redis 的 Set 结构与 Java 中的 HashSet 类似,可以看做是一个 value 为 null 的 HashMap。因为也是一个 hash 表,因此具备与 HashSet 类似的特征:
- 无序
- 元素不可重复
- 查找快
- 支持交集、并集、差集等功能
自动排重
Reds 的 string 类型的无序集合。它底层其实是个 value 为 null 的 hash 表 , 所以添加, 删除, 查找的复杂度都是 o(1)。
算法的时间复杂度如果是
o(1), 随着数据的增加, , 执行时间的长短不变
常用命令
sadd <key> <value1> <value2>……将—个或多个 member 元素加入到集合 key 中, 已经存在的 member 元素将被忽略srem <key> <vaue1> <value2>删除集合中的某个元素。smembers <key>获取该集合的所有值sismember <key> <value>判断集合<key>是否为含有该<value>值, 有 1, 没有 0scard<key>返回该集合的元素个数。spop<key>随机从该集合中吐出一个值。srandmember <key> <n>随机从该集合中获取出 n 个值。smove <source> <destination> <value>把集合中一个值从一个集合移动到另一个集合sinter <key1> <key2>返回两个集合的交集元素。sunion <key1> <key2>返回两个集合的并集元素。sdiff <key1> <key2>返回两个集合的差集元素。
数据结构
Set 数据结构是 dict 字典,字典是用哈希表实现的。
Java 中 HashSet 的内部实现使用的是 HashMap,只不过所有的 value 都指向同一个对象。Redis 的 set 结构也是一样,它的内部也使用 hash 结构,所有的 value 都指向同一个内部值。
哈希 Hash
简介
Hash 类型,也叫散列,其 value 是一个无序字典(键值对集合),类似于 Java 中的 HashMap 结构 Map<String,Object>。
Hash 结构可以将对象中的每个字段独立存储,可以针对单个字段做 CRUD
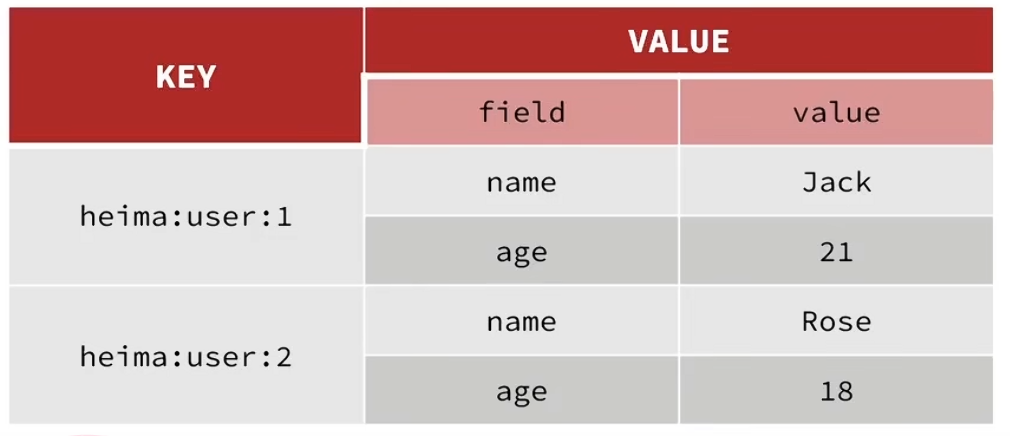
常用命令
hset <key> <field> <value>给集合中的<field>键赋值<value>hget <key> <field>从集合<field>取出 valuehmset <key1> <field1> <value1> <field2> <value2>...批量设置 hash 的值hexists <key1> <field>查看哈希表 key 中,给定域 field 是否存在。hkeys <key>列出该 hash 集合的所有 fieldhvals <key>列出该 hash 集合的所有 valuehgetall:获取一个 hash 类型的 key 中的所有的 field 和 valuehincrby <key> <field> <increment>为哈希表 key 中的域 field 的值自增 1hsetnx <key> <field> <value>将哈希表 key 中的域 field 的值设置为 value ,当且仅当域 field 不存在 .
数据结构
Hash 类型对应的数据结构是两种: ziplist(压缩列表), hashtable(哈希表)。
当 field-value 长度较短且个数较少时, 使用 ziplist, 否则使用 hashtable
有序集合 Zset
简介
Redis 的 Zset(SortedSet)是一个可排序的 set 集合,与 Java 中的 TreeSet 有些类似,但底层数据结构却差别很大。Zset 中的每一个元素都带有一个 score 评分属性,可以基于 score 属性对元素排序,底层的实现是一个跳表(SkipList)加 hash 表。
特性:
- 可排序
- 元素不重复
- 查询速度快
常用命令
zadd <key> <score1> <value1> <score2> <value2>…将一个或多个 member 元素及其 score 值加入到有序集 key 当中。zscore <key> <member>获取 sorted set 中的指定元素的 score 值zrange <key> <start> <stop> [WITHSCORES]返回有序集 key 中,下标在<start> <stop>之间的元素带 WITHSCORES,可以让分数一起和值返回到结果集。zrangebyscore key min max [withscores] [limit offset count]返回有序集 key 中,所有 score 值介于 min 和 max 之间(包括等于 min 或 max )的成员。有序集成员按 score 值递增(从小到大)次序排列。zrevrangebyscore key max min [withscores] [limit offset count]同上,改为从大到小排列。zincrby <key> <increment> <value>为元素的 score 加上增量zrem <key><value>删除该集合下,指定值的元素zcard <key>统计该集合的元素个数zcount <key> <min> <max>统计该集合,分数区间内的元素个数zrank <key><value>返回该值在集合中的排名,从 0 开始。zdiff、zinter、zunion: 求差集、交集、并集
注意:所有的排名默认都是升序,如果要降序则在命令的 Z 后面添加 REV 即可
数据结构
一方面 它等价于 Java 的数据结构 Map<String, Double>
一方面它又类似于 TreeSet,内部的元素会按照权重 score 进行排序,可以得到每个元素的名次,还可以通过 score 的范围来获取元素的列表。
zset 底层使用了两个数据结构
- hash,hash 的作用就是关联元素 value 和权重 score,保障元素 value 的唯一性,可以通过元素 value 找到相应的 score 值。
- 跳跃表,跳跃表的目的在于给元素 value 排序,根据 score 的范围获取元素列表。
跳跃表
有序集合 在生活中比较常见,例如根据成绩对学生排名,根据得分对玩家排名等。对于有序集合的底层实现,可以用数组、平衡树、链表等。数组 不便元素的插入、删除;平衡树或红黑树 虽然效率高但结构复杂;链表 查询需要遍历所有效率低。Redis 采用的是跳跃表。跳跃表效率堪比红黑树,实现远比红黑树简单。
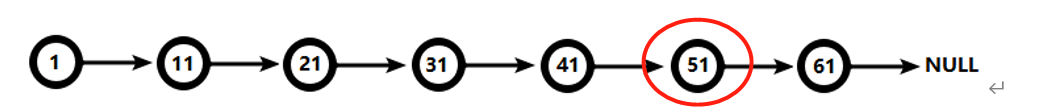
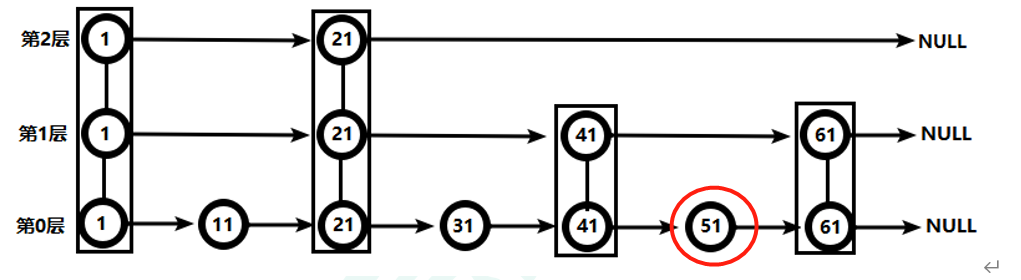
Reds 配置文件详解 redis.conf
Redis6 的发布和订阅
什么是发布和订阅
Redis 发布订阅 (pub/sub) 是一种消息通信模式:发送者 (pub) 发送消息,订阅者 (sub) 接收消息。
Redis 客户端可以订阅任意数量的频道
Redis 的发布和订阅
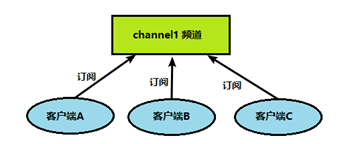
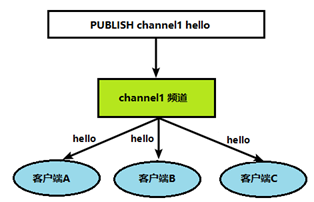
发布订阋命令行实现
打开一个客户端,订阅频道 1
hadoop@ubuntu:~$ redis-cli
127.0.0.1:6379> subscribe channel1
Reading messages... (press Ctrl-C to quit)
1) "subscribe"
2) "channel1"
3) (integer) 1
打开另一个客户端,给频道 1 发送消息 hello
hadoop@ubuntu:~$ redis-cli
127.0.0.1:6379> publish channel1 hello
(integer) 1
打开第一个客户端看到发送的消息消息
1) "message"
2) "channel1"
3) "hello"
Redis6 新数据类型
Bitmap
简介
现代计算机用二进制(位) 作为信息的基础单位, 1 个字节等于 8 位。
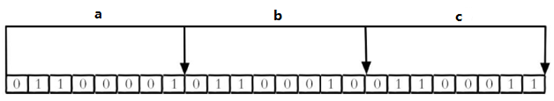
合理地使用操作位能够有效地提高内存使用率和开发效率。
Redis 提供了 Bitmaps 这个“数据类型”可以实现对位的操作:
- Bitmaps 本身不是一种数据类型, 实际上它就是字符串(key-value) , 但是它可以对字符串的位进行操作。
- Bitmaps 单独提供了一套命令, 所以在 Redis 中使用 Bitmaps 和使用字符串的方法不太相同。 可以把 Bitmaps 想象成一个以位为单位的数组, 数组的每个单元只能存储 0 和 1, 数组的下标在 Bitmaps 中叫做偏移量。

命令
setbit <key> <offset> <value>设置 Bitmaps 中某个偏移量的值(0 或 1)getbit <key> <offset>获取 Bitmaps 中某个偏移量的值bitcount <key> [start end]统计字符串从 start 字节 到 end 字节比特值为 1 的数量般情况下,给定的整个字符串都会被进行计数,通过指定额外的 start 或 end 参数,可以让计数只在特定的位上进行。start 和 end 参数的设置,都可以使用负数值:比如 -1 表示最后一个位,而 -2 表示倒数第二个位,start、end 是指 bit 组的字节的下标数,二者皆包含。
bitop and(or/not/xor) <destkey> [key…]bitop 是一个复合操作, 它可以做多个 Bitmaps 的 and(交集) 、 or(并集) 、 not(非) 、 xor(异或) 操作并将结果保存在 destkey 中。
应用
每个独立用户是否访问过网站存放在 Bitmaps 中, 将访问的用户记做 1, 没有访问的用户记做 0, 用偏移量作为用户的 id。
很多应用的用户 id 以一个指定数字(例如 10000) 开头, 直接将用户 id 和 Bitmaps 的偏移量对应势必会造成一定的浪费, 通常的做法是每次做 setbit 操作时将用户 id 减去这个指定数字。
Bitmaps 与 set 对比
set 存储访问过的 id(64 位),Bitmaps 存储访问过 id 和为访问过的 id(1 位)
网站每天的独立访问用户很多时,使用 Bitmaps 存储 id 将比 set 节省大量存储空间
假如该网站每天的独立访问用户很少, 例如只有 10 万(大量的僵尸用户) , 那么两者的对比如下表所示, 很显然, 这时候使用 Bitmaps 就不太合适了, 因为基本上大部分位都是 0。
HyperLogLog
6.2.1 简介
在工作当中,我们经常会遇到与统计相关的功能需求,比如统计网站 PV(PageView 页面访问量), 可以使用 Redis 的 incr、incrby 轻松实现。但像 UV(UniqueVisitor,独立访客)、独立 IP 数、搜索记录数等需要去重和计数的问题如何解决?这种求集合中 不重复元素个数 的问题称为 基数问题。
解决基数问题的方案:
- 数据存储在 MySQL 表中,使用 distinct count 计算不重复个数
- 使用 Redis 提供的 hash、set、bitmaps 等数据结构来处理
弊端:随着数据不断增加,占用空间越来越大
解决:Redis HyperLogLog 是用来做基数统计的算法
HyperLogLog 只会根据输入元素来计算基数,而不会储存输入元素本身,所以 HyperLogLog 不能像集合那样,返回输入的各个元素。
命令
pfadd <key>< element> [element ...] 添加指定元素到 HyperLogLog 中
pfcount<key> [key ...] 计算 HLL 的近似基数,可以计算多个 HLL,比如用 HLL 存储每天的 UV,计算一周的 UV 可以使用 7 天的 UV 合并计算即可
pfmerge<destkey><sourcekey> [sourcekey ...] 将一个或多个 HLL 合并后的结果存储在另一个 HLL 中,比如每月活跃用户可以使用每天的活跃用户来合并计算可得
Geospatial
简介
Redis 3.2 中增加了对 GEO 类型的支持。GEO,Geographic,地理信息的缩写。该类型,就是元素的 2 维坐标,在地图上就是经纬度。redis 基于该类型,提供了经纬度设置,查询,范围查询,距离查询,经纬度 Hash 等常见操作。
命令
geoadd<key>< longitude><latitude><member> [longitude latitude member...] 添加地理位置(经度,纬度,名称)
geopos <key><member> [member...] 获得指定地区的坐标值
geodist<key><member1><member2> [m|km|ft|mi ] 获取两个位置之间的直线距离
georadius<key>< longitude><latitude>radius m|km|ft|mi 以给定的经纬度为中心,找出某一半径内的元素
Jedis 操作 Redis6
依赖
<dependency>
    <groupId>redis.clients</groupId>
    <artifactId>jedis</artifactId>
    <version>3.2.0</version>
</dependency>
连接 Redis 注意事项
redis.conf 中注释掉 bind 127.0.0.1 , 然后 protected-mode no
禁用 Linux 的防火墙:Linux(CentOS7)里执行命令 systemctl stop/disable firewalld.service Ubuntu64 sudo ufw disable
测试 Jedis
public class JedisTest {

    private Jedis jedis;

    @BeforeEach
    void setup() {
        jedis = new Jedis("192.168.1.117", 36379);
        jedis.select(0);
        String pong = jedis.ping("Hello, Jedis!");
        System.out.println(pong);
    }

    @Test
    void testString() {
        jedis.set("foo", "bar");
        String foo = jedis.get("foo");
        System.out.println(foo);
    }

    @Test
    void testHash() {
        jedis.hset("user:1000", "name", "jedis");
        String name = jedis.hget("user:1000", "name");
        System.out.println(name);
    }

    @AfterEach
    void teardown() {
        if (jedis != null) {
            jedis.close();
        }
    }
}
测试 Jedis API
模拟验证码发送
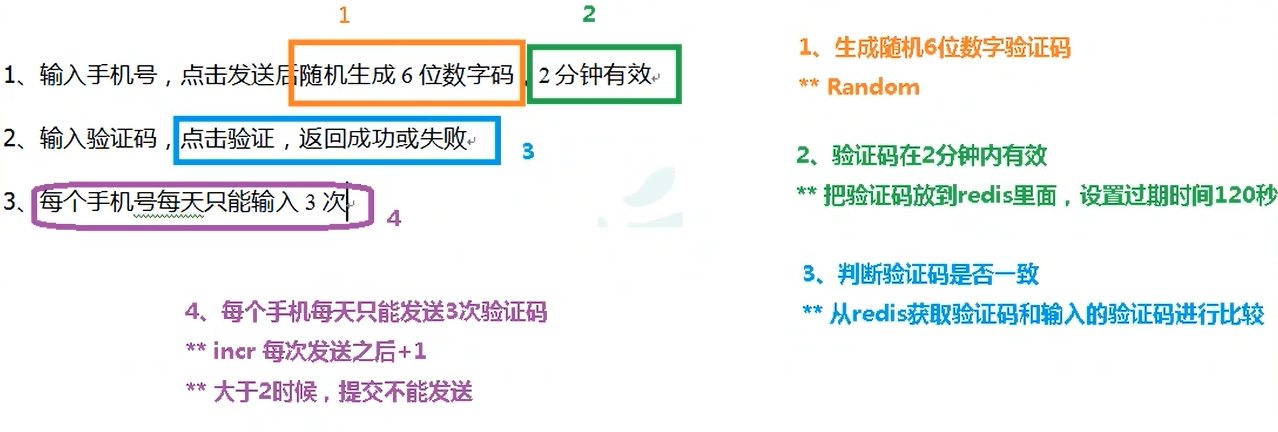
Jedis 连接池
Jedis 本身是线程不安全的,并且频繁的创建和销毁连接会有性能损耗,因此我们推荐大家使用 Jedis 连接池代替 Jedis 的直连方式。
public class JedisConnectionFactory {
    private static JedisPool jedisPool;

    static {
        // 连接池配置
        JedisPoolConfig jedisPoolConfig = new JedisPoolConfig();
        jedisPoolConfig.setMaxTotal(8);
        jedisPoolConfig.setMaxIdle(8);
        jedisPoolConfig.setMaxWaitMillis(1000);
        // 创建连接池
        jedisPool = new JedisPool(jedisPoolConfig, "192.168.1.117", 36379);
    }

    public static Jedis getJedis() {
        return jedisPool.getResource();
    }
}
后续通过 jedis = JedisConnectionFactory.getJedis(); 获取 jedis 连接对象,且 close() 源码不是真正的销毁连接,而是判断是否有连接池并归还。
Spring Boot 整合 Redis
SpringData 是 Spring 中数据操作的模块,包含对各种数据库的集成,其中对 Redis 的集成模块就叫做 SpringDataRedis,官网地址:https://spring.io/projects/spring-data-redis
- 提供了对不同 Redis 客户端的整合(Lettuce 和 Jedis)
- 提供了 RedisTemplate 统一 API 来操作 Redis
- 支持 Redis 的发布订阅模型
- 支持 Redis 哨兵和 Redis 集群
- 支持基于 Lettuce 客户端的响应式编程
- 支持基于 JDK、JSON、字符串、Spring 对象的数据序列化及反序列化
- 支持基于 Redis 的 JDKCollection 实现
在 pom.xml 文件中引入 redis 相关依赖
<!-- redis -->
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-data-redis</artifactId>
        </dependency>

        <!-- spring2.X集成redis所需common-pool2-->
        <dependency>
            <groupId>org.apache.commons</groupId>
            <artifactId>commons-pool2</artifactId>
            <version>2.6.0</version>
        </dependency>
application.properties 配置 redis 配置
#Redis服务器地址
spring.redis.host=192.168.190.128
#Redis服务器连接端口
spring.redis.port=6379
#Redis数据库索引(默认为0)
spring.redis.database= 0
#连接超时时间(毫秒)
spring.redis.timeout=1800000
#连接池最大连接数(使用负值表示没有限制)
spring.redis.lettuce.pool.max-active=20
#最大阻塞等待时间(负数表示没限制)
spring.redis.lettuce.pool.max-wait=-1
#连接池中的最大空闲连接
spring.redis.lettuce.pool.max-idle=5
#连接池中的最小空闲连接
spring.redis.lettuce.pool.min-idle=0
添加 redis 配置类,
主要解决以下问题:SpringDataRedis 默认使用 JdkSerializationRedisSerializer 序列化器,序列化方式是 ObjectOutputStream.writeObject(Object object),存入的结果较长,且可读性差

@EnableCaching
public class RedisConfig {

    @Bean
    public RedisTemplate<String, Object> redisTemplate(RedisConnectionFactory connectionFactory) {
        RedisTemplate<String, Object> template = new RedisTemplate<>();
        template.setConnectionFactory(connectionFactory);
        //key 序列化方式 hash key 序列化
        template.setKeySerializer(RedisSerializer.string());
        template.setHashKeySerializer(RedisSerializer.string());
        //value 序列化
        template.setValueSerializer(RedisSerializer.json());
        //hash value 序列化
        template.setHashValueSerializer(RedisSerializer.json());
        return template;
    }
}
SpringDataRedis 中提供了 RedisTemplate 工具类,其中封装了各种对 Redis 的操作。并且将不同数据类型的操作 API 封装到了不同的类型中:
- 操作 String 类型数据
redisTemplate.opsForValue() - 操作 Hash 类型数据
redisTemplate.opsForHash() - 操作 List 类型数据
redisTemplate.opsForList() - 操作 Set 类型数据
redisTemplate.opsForSet() - 操作 SortedSet 类型数据
redisTemplate.opsForZSet() - 其他通用命令通过
redisTemplate调用
测试
@SpringBootTest
public class RedisTemplateTest {

    @Autowired
    private RedisTemplate redisTemplate;

    @Test
    void testRedis() {
        ValueOperations valueOperations = redisTemplate.opsForValue();
        valueOperations.set("key", "value");
        System.out.println(valueOperations.get("key"));

        // 测试存取对象
        Map map = new HashMap<>();
        map.put("k1", "v1");
        map.put("k2", "v2");
        redisTemplate.opsForValue().set("object", map);
        System.out.println(redisTemplate.opsForValue().get("object"));
    }

}
由于为了在反序列化时知道对象的类型,JSON 序列化器会将类的 class 类型写入 json 结果中,存入 Redis,会带来额外的内存开销。

实际工作中,需要存储 java 对象时,建议将 key 和 value 的序列化方式都设置为 StringRedisSerializer.UTF_8,并且在代码中手动完成对象的序列化和反序列化。而 spring 提供了 stringRedisTemplate 省去了配置的麻烦。
@SpringBootTest
public class StringRedisTemplateTest {

    @Autowired
    private StringRedisTemplate stringRedisTemplate;

    private ObjectMapper objectMapper = new ObjectMapper();

    @Test
    void testStringRedisTemplate() throws JsonProcessingException {
        // 测试 value 操作
        stringRedisTemplate.opsForValue().set("name", "zhangsan");
        System.out.println(stringRedisTemplate.opsForValue().get("name"));

        // 测试存取对象
        Map map = new HashMap<>();
        map.put("k1", "v1");
        map.put("k2", "v2");
        stringRedisTemplate.opsForValue().set("object", objectMapper.writeValueAsString(map));
        System.out.println(stringRedisTemplate.opsForValue().get("object"));

        // 测试 hash 类型数据操作
        stringRedisTemplate.opsForHash().put("hash", "hashKey1", "hashValue1");
        stringRedisTemplate.opsForHash().put("hash", "hashKey2", "hashValue2");
        Map<Object, Object> entries = stringRedisTemplate.opsForHash().entries("hash");
        System.out.println("entries = " + entries);
    }
}
Redis6 的事务
事务的定义
类似 MySql 的事务 本质是一组命令/SQL 语句的集合,同时满足具有四个特性——原子性、一致性、隔离性、持久性。
Redis 事务三特性
- 单独的隔离操作
- 事务中的所有命令都会序列化、按顺序地执行。事务在执行的过程中,不会被其他客户端发送来的命令请求所打断。
- 没有隔离级别的概念
- 队列中的命令没有提交之前都不会实际被执行,因为事务提交前任何指令都不会被实际执行
- 不保证原子性
- 事务中如果有一条命令执行失败,其后的命令仍然会被执行,没有回滚
Multi、Exec、discard
从输入 Multi 命令开始,输入的命令都会依次进入命令队列中,但不会执行.
直到输入 Exec 后,Redis 会将之前的命令队列中的命令依次执行。
组队的过程中可以通过 discard 来放弃组队。
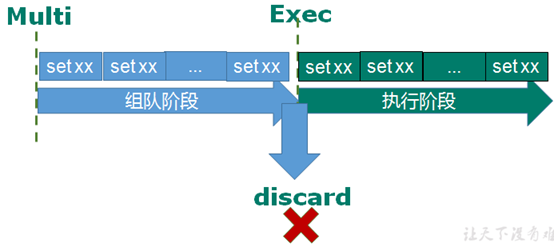
WATCH、UNWATCH
WATCH 监视一个或多个 key, 如果事务在执行前,这个 key(或多个 key)被其他命令修改,则事务被中断,不会执行事务中的任何命令。
UNWATCH 取消 WATCH 对所有 key 的监视。
Redis 事务的隔离性
Redis 事务是一个单独的隔离操作,没有区分不同隔离级别,事务中的所有命令都会 序列化、按顺序地执行。事务在执行的过程中,不会被其他客户端发送来的命令请求所打断。
Redis 事务的主要作用就是串联多个命令防止别的命令插队。
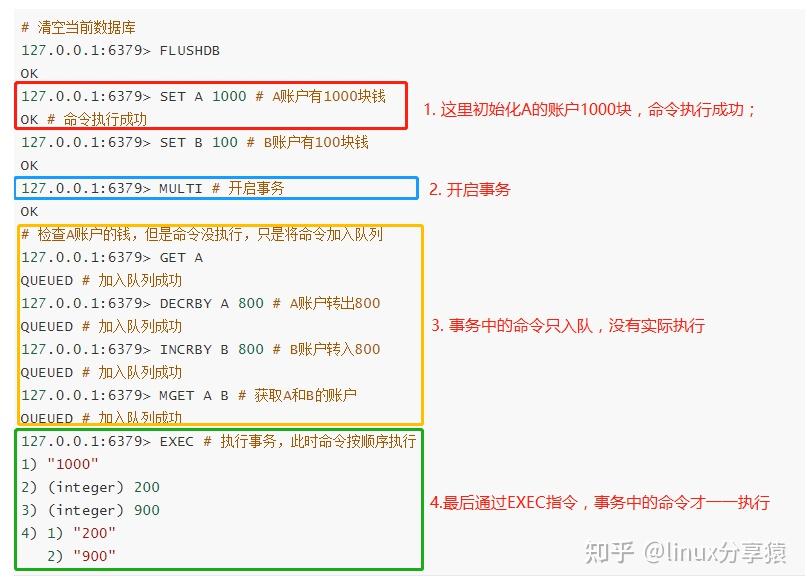
Redis 事务的些许原子性
Redis 事务不保证原子性,当执行 EXEC 命令时,所有命令一定会被执行,当某个命令 报错失败 不会影响其他命令执行,也 不支持回滚。
因为 Redis 认为命令的失败大部分是错误的语法引起的,应该在开发过程中被发现,不应该出现在生产环境。同时 Redis 内部可以保持简单且快速。
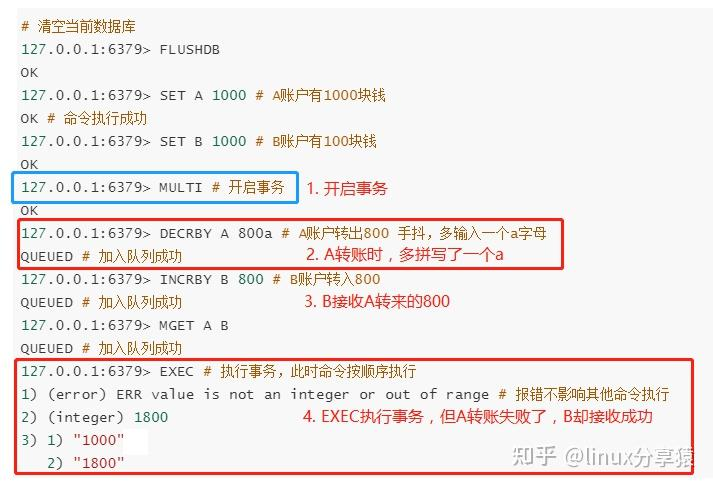
些许原子性的体现:
- 组队中(执行 EXEC 命令之前)某个命令出现了报告错误或者用 DISCARD 放弃事务,执行时整个的所有队列都会被取消。
- 使用 WATCH 命令实现乐观锁。如果监视的 Key 的值改变,事务最终会执行失败。
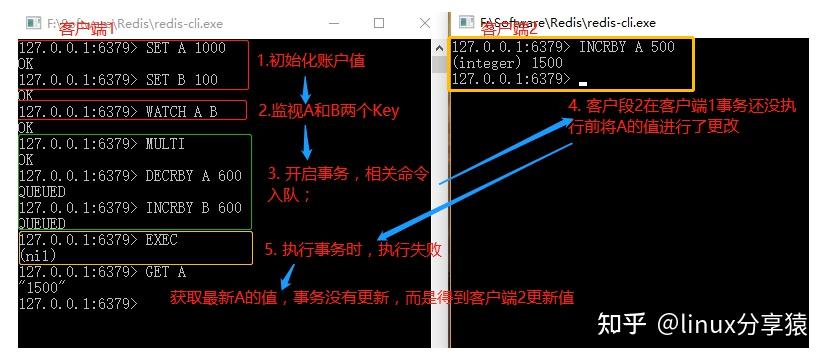
事务的冲突问题
例子
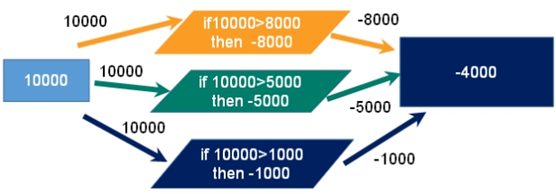
悲观锁
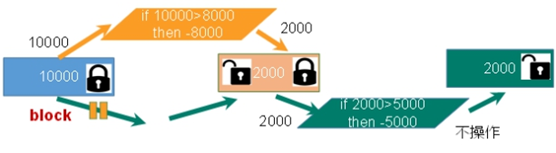
悲观锁是指在访问共享变量之前就认为会出现线程安全问题,所以需要在上锁之后再访问共享变量,由于悲观锁每次访问时都会上锁,就会造成程序的并发性降低。
传统的关系型数据库里边就用到了很多这种锁机制,比如 行锁,表锁 等,读锁,写锁 等,都是在做操作之前先上锁。
乐观锁
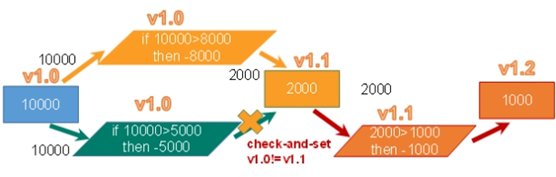
乐观锁是指在访问共享变量之前认为不会出现线程安全问题,所以不会上锁,如果在访问时出现了线程安全问题再解决
乐观锁在更新的时候会判断一下在此期间别人有没有去更新这个数据,可以使用版本号等机制。乐观锁适用于多读的应用类型,这样可以提高吞吐量。Redis 就是利用这种 check-and-set 机制实现事务的。
通过 watch 命令减少共享的变量可以实现乐观锁
WATCH key [key ...]
在执行 multi 之前,先执行 watch key1 [key2], 可以监视一个(或多个) key ,如果在事务 执行之前这个(或这些) key 被其他命令所改动,那么事务将被打断。
unwatch
取消 WATCH 命令对所有 key 的监视。
如果在执行 WATCH 命令之后,EXEC 命令或 DISCARD 命令先被执行了的话,那么就不需要再执行 UNWATCH 了。
Redis 事务:秒杀案例
超卖问题
解决:乐观锁 但是会造成库存遗留问题,因为大部分用户都因为版本号的问题导致事务失败。
库存遗留问题
解决: LUA 脚本 (类似于悲观锁)
Lua 脚本
Lua 是一个小巧的 脚本语言,Lua 脚本可以很容易的被 C/C++ 代码调用,也可以反过来调用 C/C++的函数,Lua 并没有提供强大的库,一个完整的 Lua 解释器不过 200k,所以 Lua 不适合作为开发独立应用程序的语言,而是作为嵌入式脚本语言。
很多应用程序、游戏使用 LUA 作为自己的嵌入式脚本语言,以此来实现可配置性、可扩展性。
这其中包括魔兽争霸地图、魔兽世界、博德之门、愤怒的小鸟等众多游戏插件或外挂。
Lua 脚本在 redis 的优势
将复杂的或者多步的 redis 操作,写为一个脚本,一次提交给 redis 执行,减少反复连接 redis 的次数。提升性能。
LUA 脚本是类似 redis 事务,有 一定的原子性,不会被其他命令插队,可以完成一些 redis 事务性的操作。
但是注意 redis 的 lua 脚本功能,只有在 Redis 2.6 以上的版本才可以使用。
利用 lua 脚本淘汰用户,解决超卖问题。
redis 2.6 版本以后,通过 lua 脚本解决 争抢问题,实际上是 redis 利用其单线程的特性,用任务队列的方式解决多任务并发问题。
Redis 连接池
节省每次连接 redis 服务带来的消耗,把连接好的实例反复利用。
通过参数管理连接的行为
- MaxTotal:控制一个 pool 可分配多少个 jedis 实例,通过 pool.getResource()来获取;如果赋值为-1,则表示不限制;如果 pool 已经分配了 MaxTotal 个 jedis 实例,则此时 pool 的状态为 exhausted。
- maxIdle:控制一个 pool 最多有多少个状态为 idle(空闲)的 jedis 实例;
- MaxWaitMillis:表示当 borrow 一个 jedis 实例时,最大的等待毫秒数,如果超过等待时间,则直接抛 JedisConnectionException;
- testOnBorrow:获得一个 jedis 实例的时候是否检查连接可用性(ping());如果为 true,则得到的 jedis 实例均是可用的;
public class JedisPoolUtil {
	private static volatile JedisPool jedisPool = null;

	private JedisPoolUtil() {
	}

	public static JedisPool getJedisPoolInstance() {
		if (null == jedisPool) {
			synchronized (JedisPoolUtil.class) {
				if (null == jedisPool) {
					JedisPoolConfig poolConfig = new JedisPoolConfig();
					poolConfig.setMaxTotal(200);
					poolConfig.setMaxIdle(32);
					poolConfig.setMaxWaitMillis(100*1000);
					poolConfig.setBlockWhenExhausted(true);
					poolConfig.setTestOnBorrow(true);  // ping  PONG

					jedisPool = new JedisPool(poolConfig, "192.168.44.168", 6379, 60000 );
				}
			}
		}
		return jedisPool;
	}

	public static void release(JedisPool jedisPool, Jedis jedis) {
		if (null != jedis) {
			jedisPool.returnResource(jedis);
		}
	}

}
Redis6 持久化
Redis 持久化
Redis 提供了 2 个不同形式的持久化方式。
- RDB(Redis DataBase)
- AOF(Append Of File)
RDB(Redis DataBase)
RDB 简介
在 指定的时间间隔 内将内存中的数据集 快照 写入磁盘, 也就是行话讲的 Snapshot 快照,它恢复时是将快照文件直接读到内存里
优点:
- 文件紧凑,易于传输。
- 可以恢复各个时间点的数据,适合备份。
- 使用多进程 COW(Copy On Write)机制。fork()产生一个子进程进行持久化,父进程继续处理读写请求,且子进程与父进程共享大部分的内存空间,只有写入被标记的数据才会复制,以此尽量不影响 redis 性能。
- 存储的使二进制数据,恢复速度快。
缺点:
- 无法实时保存,数据丢失率高。
- 数据集过大时,fork 子进程的过程非常耗时。
备份的执行
Redis 会单独创建(fork)一个子进程来进行持久化,会先将数据写入到 一个临时文件中,待持久化过程都结束了,再用这个临时文件替换上次持久化好的文件。 整个过程中,主进程是不进行任何 IO 操作的,这就确保了极高的性能 如果需要进行大规模数据的恢复,且对于数据恢复的完整性不是非常敏感,那 RDB 方式要比 AOF 方式更加的高效。RDB 的缺点是最后一次持久化后的数据可能丢失。
持久化流程
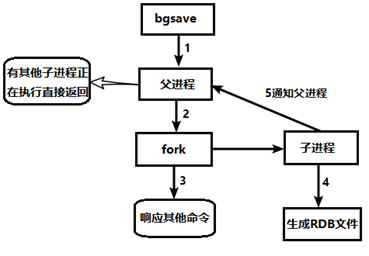
关于 RDB 的配置
在 Redis.conf 的 SNAPSHOTTING 配置下
################################ SNAPSHOTTING  ################################

# The filename where to dump the DB
# 默认快照文件名称
dbfilename dump.rdb

# Note that you must specify a directory here, not a file name.
# 快照文件位置
dir ./

# However if you have setup your proper monitoring of the Redis server
# and persistence, you may want to disable this feature so that Redis will
# continue to work as usual even if there are problems with disk,
# permissions, and so forth.
# 当Redis无法写入磁盘的话,直接关掉Redis的写操作。推荐yes.
stop-writes-on-bgsave-error yes

# Compress string objects using LZF when dump .rdb databases?
# By default compression is enabled as it's almost always a win.
# If you want to save some CPU in the saving child set it to 'no' but
# the dataset will likely be bigger if you have compressible values or keys.
# 对于存储到磁盘中的快照,可以设置是否进行压缩存储。如果是的话,redis会采用LZF算法进行压缩。
# 如果你不想消耗CPU来进行压缩的话,可以设置为关闭此功能。推荐yes.
rdbcompression yes

# Since version 5 of RDB a CRC64 checksum is placed at the end of the file.
# This makes the format more resistant to corruption but there is a performance
# hit to pay (around 10%) when saving and loading RDB files, so you can disable it
# for maximum performances.
#
# RDB files created with checksum disabled have a checksum of zero that will
# tell the loading code to skip the check.
# 在存储快照后,还可以让redis使用CRC64算法来进行数据校验,
# 但是这样做会增加大约10%的性能消耗,如果希望获取到最大的性能提升,可以关闭此功能
# 推荐yes.
rdbchecksum yes

# Unless specified otherwise, by default Redis will save the DB:
#   * After 3600 seconds (an hour) if at least 1 key changed
#   * After 300 seconds (5 minutes) if at least 100 keys changed
#   * After 60 seconds if at least 10000 keys changed
#
# You can set these explicitly by uncommenting the three following lines.
# 配置复合的快照触发条件,在指定时间内达到指定的写的操作次数则触发快照条件
# save后给空值,表示禁用保存策略 命令redis-cli config set save ""
# save 3600 1
# save 300 100
# save 60 10000
手动触发触发 RDB 快照
save :save 时只管保存,其它不管,全部阻塞。手动保存。不建议。
bgsave:Redis 会在后台异步进行快照操作,快照同时还可以响应客户端请求。
可以通过 lastsave 命令获取最后一次成功执行快照的时间
优势
- 适合大规模的数据恢复
- 对数据完整性和一致性要求不高更适合使用
- 节省磁盘空间
- 恢复速度快
劣势
- Fork 的时候,内存中的数据被克隆了一份,大致 2 倍的膨胀性需要考虑
- 虽然 Redis 在 fork 时使用了 写时拷贝技术, 但是如果数据庞大时还是比较消耗性能。
- 在备份周期在一定间隔时间做一次备份,所以如果 Redis 意外 down 掉的话,就会丢失最后一次快照后的所有修改。
AOF(Append Of File)
简介
以日志的形式来记录每个 写操作(增量保存),将 Redis 执行过的所有写指令记录下来(读操作不记录), 只许 追加文件 但不可以改写文件,redis 启动之初会读取该文件重新构建数据,换言之,redis 重启的话就根据日志文件的内容将写指令从前到后执行一次以完成数据的恢复工作。
优点:
- 故障的数据丢失率很低。丢失率与 fsync(类似于 UNIX 传统操作系统磁盘 I/O 的缓冲延迟写)的策略有关,丢失率:no > everysec > always
- 可以 AOF 重写,使日志文件变小。
- 有序的保存了所有写入操作。
缺点:
- AOF 文件大于 RDB 文件的体积,记录的文本形式的命令操作,恢复时间比较长。
- Redis 开启 AOF 持久化的,由于频繁的 I/O 操作,Redis 读写性能通常情况下会慢于 RDB。fsync 策略对应读写性能:no > everysec > always
AOF 持久化流程
- 客户端的请求写命令会被 append 追加到 AOF 缓冲区内;
- AOF 缓冲区根据 AOF 持久化策略 [always, everysec, no] 将操作 sync 同步到磁盘的 AOF 文件中;
- AOF 文件大小超过重写策略或手动重写时,会对 AOF 文件 rewrite 重写,压缩 AOF 文件容量;
- Redis 服务重启时,会重新 load 加载 AOF 文件中的写操作达到数据恢复的目的;
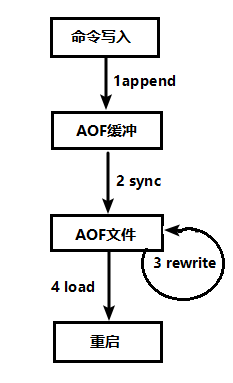
关于 AOF 的配置
############################## APPEND ONLY MODE ###############################
# AOF and RDB persistence can be enabled at the same time without problems.
# If the AOF is enabled on startup Redis will load the AOF, that is the file
# with the better durability guarantees.
# AOF和RDB同时开启,系统默认取AOF的数据(数据不会存在丢失)
# Please check https://redis.io/topics/persistence for more information.

# AOF默认不开启
# 开启AOF
appendonly yes

# The name of the append only file (default: "appendonly.aof")

appendfilename "appendonly.aof"

# AOF同步频率设置
# 始终同步,每次Redis的写入都会立刻记入日志;性能较差但数据完整性比较好
# appendfsync always
# 每秒同步,每秒记入日志一次,如果宕机,本秒的数据可能丢失。
appendfsync everysec
# redis不主动进行同步,把同步时机交给操作系统。
# appendfsync no

# AOF重写机制设置
#如果 no-appendfsync-on-rewrite=yes ,rdb 的快照不写入aof文件只写入缓存,用户请求不会阻塞,但是在这段时间如果宕机会丢失这段时间的缓存数据。(降低数据安全性,提高性能)
#如果 no-appendfsync-on-rewrite=no,  还是会把数据往磁盘里刷,但是遇到重写操作,可能会发生阻塞。(数据安全,但是性能降低)
no-appendfsync-on-rewrite no

# Redis会记录上次重写时的AOF大小,默认配置是当AOF文件大小是上次rewrite后大小的一倍且文件大于64M时触发
# 设置重写的基准值,文件达到100%时开始重写(文件是原来重写后文件的2倍时触发)
auto-aof-rewrite-percentage 100
# 设置重写的基准值,最小文件64MB。达到这个值开始重写。
auto-aof-rewrite-min-size 64mb
AOF 恢复的机制
AOF 的备份机制和性能虽然和 RDB 不同, 但是备份和恢复的操作同 RDB 一样,都是拷贝备份文件,需要恢复时再拷贝到 Redis 工作目录下,启动系统即加载。
正常恢复
修改默认的 appendonly no,改为 yes
将有数据的 aof 文件复制一份保存到对应目录(查看目录:config get dir)
恢复:重启 redis 然后重新加载
异常恢复
修改默认的 appendonly no,改为 yes
如遇到 AOF 文件损坏,通过/usr/local/bin/
redis-check-aof--fix appendonly.aof进行恢复备份被写坏的 AOF 文件
恢复:重启 redis,然后重新加载
Rewrite 压缩
定义
AOF 采用文件追加方式,文件会越来越大为避免出现此种情况,新增了重写机制, 当 AOF 文件的大小超过所设定的阈值时,Redis 就会启动 AOF 文件的内容压缩, 只保留可以恢复数据的最小指令集.可以使用命令 bgrewriteaof
重写原理
AOF 文件持续增长而过大时,会 fork 出一条新进程来将文件重写(也是先写临时文件最后再 rename),redis4.0 版本后的重写,是指上就是把 rdb 的快照,以二级制的形式附在新的 aof 头部,作为已有的历史数据,替换掉原来的流水账操作。
重写虽然可以节约大量磁盘空间,减少恢复时间。但是每次重写还是有一定的负担的,因此设定 Redis 要满足一定条件才会进行重写。
如果 Redis 的 AOF 当前大小 >= base_size +base_size*100% (默认)且当前大小 >= 64mb(默认)的情况下,Redis 会对 AOF 进行重写。 (base_size 为系统载入时或者上次重写完毕时 AOF 文件大小)
重写流程
- bgrewriteaof 触发重写,判断是否当前有 bgsave 或 bgrewriteaof 在运行,如果有,则等待该命令结束后再继续执行。
- 主进程 fork 出子进程执行重写操作,保证主进程不会阻塞。
- 子进程遍历 redis 内存中数据到临时文件,客户端的写请求同时写入 aof_buf 缓冲区和 aof_rewrite_buf 重写缓冲区保证原 AOF 文件完整以及新 AOF 文件生成期间的新的数据修改动作不会丢失。
- 子进程写完新的 AOF 文件后,向主进程发信号,父进程更新统计信息。2).主进程把 aof_rewrite_buf 中的数据写入到新的 AOF 文件。
- 使用新的 AOF 文件覆盖旧的 AOF 文件,完成 AOF 重写。
优势
- 备份机制更稳健,丢失数据概率更低。
- 可读的日志文本,通过操作 AOF 稳健,可以处理误操作。
劣势
- 比起 RDB 占用更多的磁盘空间。
- 恢复备份速度要慢。
- 每次读写都同步的话,有一定的性能压力。
- 存在个别 Bug,造成恢复不能。
混合策略
4.x 版本的混合策略
同时开启 RDB 和 AOF 后,AOF 重写文件时,以 RDB 格式保存当前数据状态,然后继续 AOF 格式记录新的写操作。恢复时,先 RDB 恢复再执行增量的命令。
总结
官方推荐两个都启用。
如果对数据不敏感,可以选单独用 RDB。
不建议单独用 AOF,因为可能会出现 Bug。
如果只是做纯内存缓存,可以都不用。
Redis6 的主从复制
主从复制(主从复制集群)
主机数据更新后根据配置和策略, 自动同步到备机的 master/slaver 机制,Master 以写为主,Slave 以读为主。
架构:一主(Master)多从(Slave)。主节点处理写操作,从节点异步复制主节点数据,并承担读请求。
好处:提高数据冗余、防止数据丢失。适合读多写少的场景。
同步原理:
- Slave 启动(首次连接)后向 Master 发送 sync/psync 命令
- Master 执行 BGSAVE 生成 RDB 快照并发送给 Slave(全量同步)
- 同步期间及之后,Master 将收到的写命令缓冲并异步发送给 Slave 执行(增量同步)
- 当连接断开重新连接,Redis2.8 之前 sync 命令直接全量同步,Redis2.8 之后 psync 命令会尝试部分重同步,当无法部分重同步时再进行全量同步。
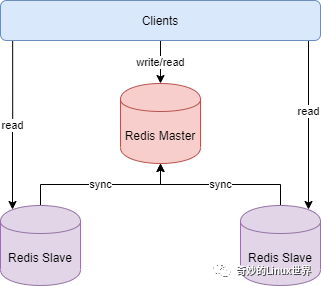
哨兵式基于主从复制模式,只是引入了哨兵来监控与自动处理故障,Master 宕机后,无需手动干预,自动切换 Slave 为新的 Master,大大降低服务中断时间。
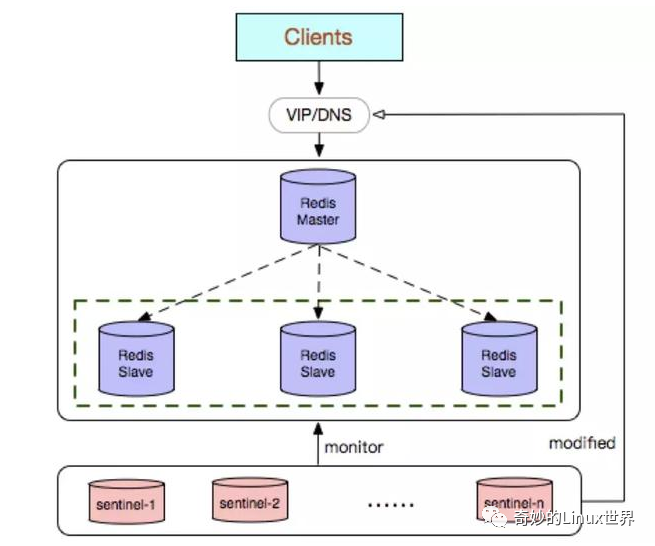
作用
- 读写分离,性能扩展
- 容灾快速恢复
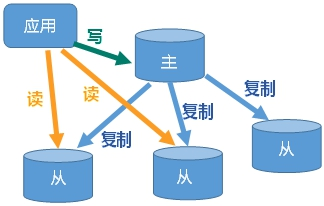
实现主从复制
拷贝原配置文件 redis.conf , 并创建三个配置文件(一主二从)
root@ubuntu:/home/hadoop/myredis# ls
redis6379.conf  redis6380.conf  redis6381.conf  redis.conf
配置如下,以 redis6379.conf 为例
# 拷贝多个redis.conf文件include(写绝对路径)
include /home/hadoop/myassets/redis.conf
# Pid文件名字
pidfile /var/run/redis_6379.pid
# 指定端口
port 6379
# dump.rdb名字
dbfilename dump6379.rdb
启动三台服务器
root@ubuntu:/home/hadoop/myredis# redis-server redis6379.conf
root@ubuntu:/home/hadoop/myredis# redis-server redis6380.conf
root@ubuntu:/home/hadoop/myredis# redis-server redis6381.conf
root@ubuntu:/home/hadoop/myredis# ps -ef | grep redis
root       8651   1610  0 11:18 ?        00:00:00 redis-server *:6379
root       8658   1610  0 11:18 ?        00:00:00 redis-server *:6380
root       8664   1610  0 11:18 ?        00:00:00 redis-server *:6381
root       8670   8504  0 11:18 pts/0    00:00:00 grep --color=auto redis
连接服务器并查看主机状态(以端口 6379 为例)
hadoop@ubuntu:~$ redis-cli -p 6379
127.0.0.1:6379> keys *
(empty array)
127.0.0.1:6379> info replication
# Replication
role:master
connected_slaves:0
master_failover_state:no-failover
master_replid:e579e33c7f98a9fde75b6ce35febc89062d1d25e
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:0
second_repl_offset:-1
repl_backlog_active:0
repl_backlog_size:1048576
repl_backlog_first_byte_offset:0
repl_backlog_histlen:0
配置从库和主库
slaveof <ip><port> 成为某个实例的从服务器
在 6380 和 6381 上执行: slaveof 127.0.0.1 6379
bash127.0.0.1:6380> slaveof 127.0.0.1 6379 OK 127.0.0.1:6380> info replication # Replication role:slave master_host:127.0.0.1 master_port:6379 master_link_status:up 127.0.0.1:6381> slaveof 127.0.0.1 6379 OK 127.0.0.1:6381> info replication # Replication role:slave master_host:127.0.0.1 master_port:6379 master_link_status:up 127.0.0.1:6379> info replication # Replication role:master connected_slaves:2 slave0:ip=127.0.0.1,port=6380,state=online,offset=14,lag=1 slave1:ip=127.0.0.1,port=6381,state=online,offset=28,lag=1在主机上写,在从机上可以读取数据,在从机上写数据报错
主机挂掉,重启就行,一切如初
从机重启需重设:slaveof 127.0.0.1 6379。可以将其配置增加到文件中。永久生效。
应对常用场景
一主二仆
- 从服务器挂掉后,重新启动,将从头开始复制
- 主服务器挂掉后,从机原地待命,主机重新启动,主机新增记录,从机能顺利复制
薪火相传
- 上一个 Slave 可以是下一个 slave 的 Master,Slave 同样可以接收其他 slaves 的连接和同步请求,那么该 slave 作为了链条中下一个的 master,
- 可以有效减轻 master 的写压力, 去中心化降低风险。
反客为主
- 当一个 master 宕机后,后面的 slave 可以立刻升为 master,其后面的 slave 不用做任何修改。
- 用
slaveof no one将从机变为主机。
复制原理
- Slave 启动成功连接到 master 后会发送一个 sync 命令
- Master 接到命令启动后台的存盘进程,同时收集所有接收到的用于修改数据集命令, 在后台进程执行完毕之后,master 将传送整个数据文件(.rdb 文件)到 slave, 以完成一次完全同步
- 每次主服务器进行写操作之后, 和从服务器进行数据同步
- 全量复制:而 slave 服务在接收到数据库文件数据后,将其存盘并加载到内存中。
- 增量复制:Master 继续将新的所有收集到的修改命令依次传给 slave, 完成同步
- 但是只要是重新连接 master, 一次完全同步(全量复制)将被自动执行
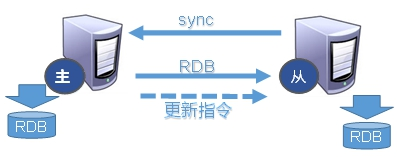
哨兵模式
反客为主的自动版,能够后台监控主机是否故障,如果故障了根据投票数自动将从库转换为主库
实现哨兵模式流程:
使用一主二仆模式
自定义的 myredis 目录下新建 sentinel.conf 文件
配置哨兵, 填写内容 sentinel monitor mymaster 127.0.0.1 6379 1 其中 mymaster 为监控对象起的服务器名称, 1 为至少有多少个哨兵同意迁移的数量。
启动哨兵 /usr/local/bin redis 做压测可以用自带的 redis-benchmark 工具 执行 redis-sentinel /myassets/sentinel.conf
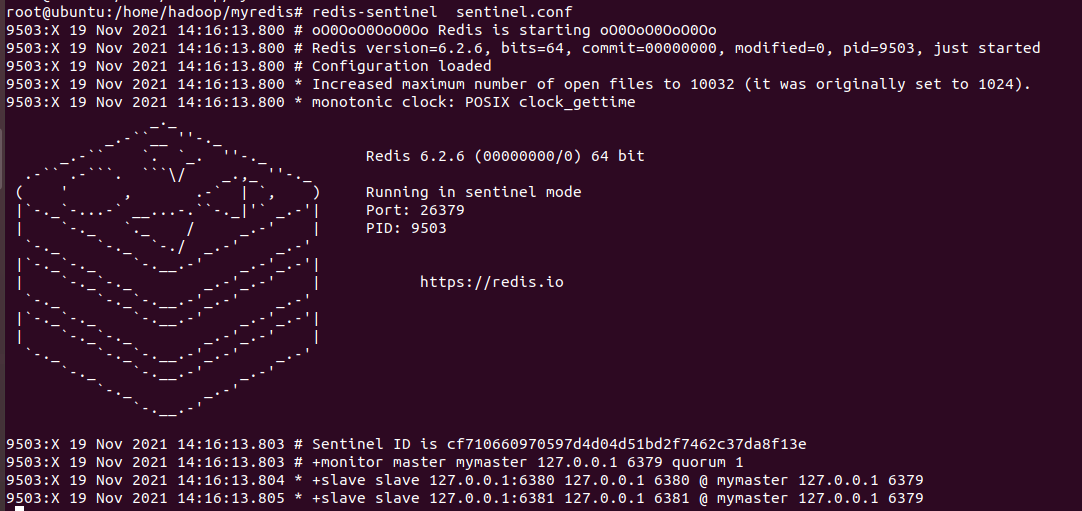
主机挂掉,从机选举中产生新的主机 (大概 10 秒左右可以看到哨兵窗口日志,切换了新的主机)
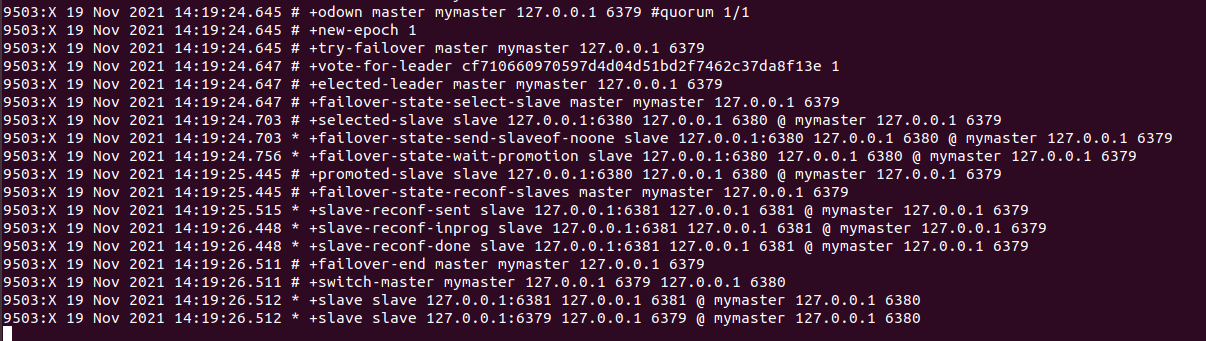
故障恢复
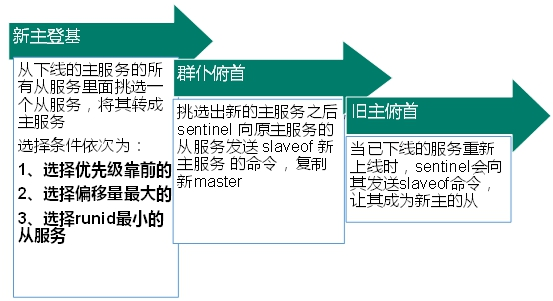 哪个从机会被选举为主机呢?根据优先级别:slave-priority 优先级在 redis.conf 中默认:slave-priority 100,值越小优先级越高 原主机重启后会变为从机。
 偏移量是指获得原主机数据最全的 每个 redis 实例启动后都会随机生成一个 40 位的 runid
主从复制 Java 实现
private static JedisSentinelPool jedisSentinelPool=null;

public static  Jedis getJedisFromSentinel(){
if(jedisSentinelPool==null){
            Set<String> sentinelSet=new HashSet<>();
            sentinelSet.add("192.168.11.103:26379");

            JedisPoolConfig jedisPoolConfig =new JedisPoolConfig();
            jedisPoolConfig.setMaxTotal(10); //最大可用连接数
jedisPoolConfig.setMaxIdle(5); //最大闲置连接数
jedisPoolConfig.setMinIdle(5); //最小闲置连接数
jedisPoolConfig.setBlockWhenExhausted(true); //连接耗尽是否等待
jedisPoolConfig.setMaxWaitMillis(2000); //等待时间
jedisPoolConfig.setTestOnBorrow(true); //取连接的时候进行一下测试 ping pong

jedisSentinelPool=new JedisSentinelPool("mymaster",sentinelSet,jedisPoolConfig);
return jedisSentinelPool.getResource();
        }else{
return jedisSentinelPool.getResource();
        }
}
Redis6 集群
解决问题
容量不足,redis 如何扩容?
并发写操作, redis 如何分摊?
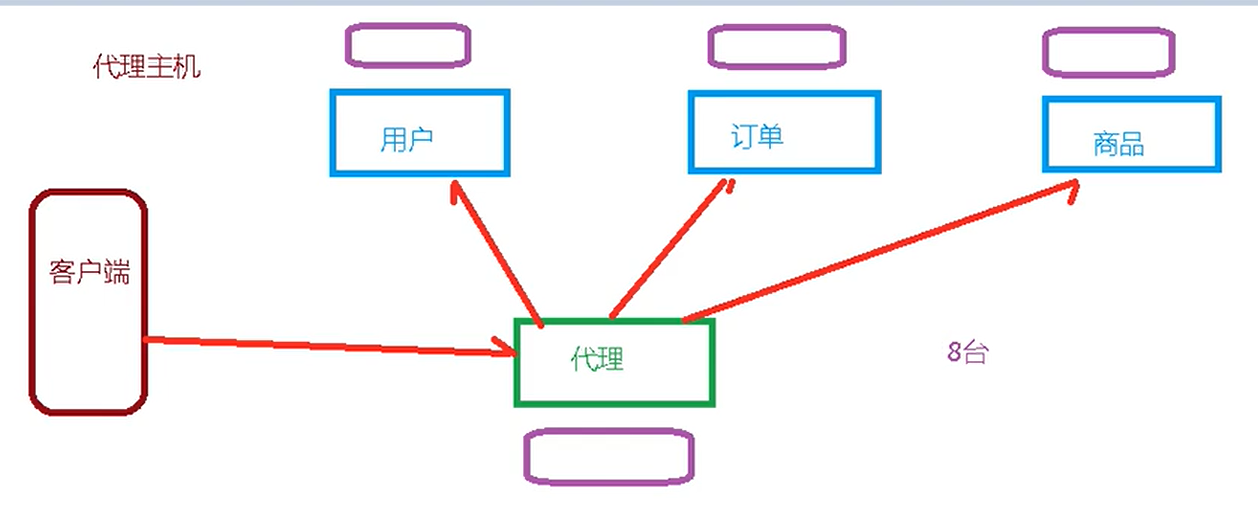
主从模式下,主机宕机,导致 ip 地址发生变化,应用程序中配置需要修改对应的主机地址、端口等信息。
代理主机
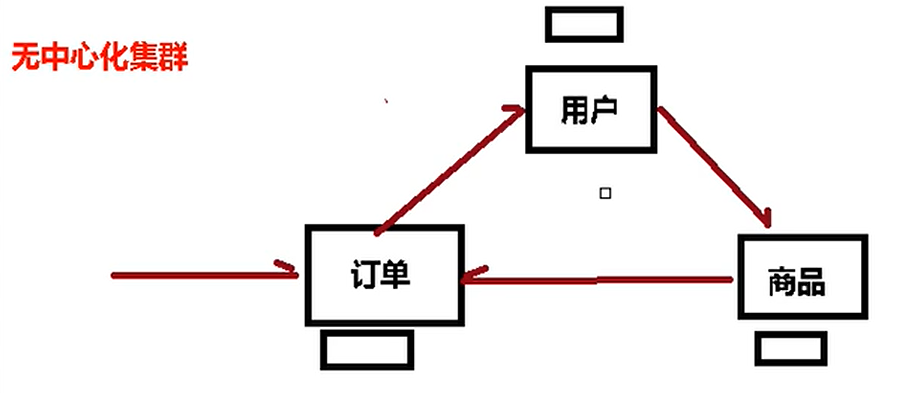
无中心化集群(redis3.0 解决方案)
集群(分片集群)
Redis 集群实现了对 Redis 的水平扩容,即启动 N 个 redis 节点,将整个数据库分布存储在这 N 个节点中,每个节点存储总数据的 1/N。
Redis 集群通过分区(partition)来提供一定程度的可用性(availability): 即使集群中有一部分节点失效或者无法进行通讯, 集群也可以继续处理命令请求。
客户端实现路由索引的分片集群
使用中间件代理层的分片集群
redis 的 cluster 的分片集群
架构:采用去中心化设计,数据分片存储在多个主节点上,每个主节点又有对应的从节点。主节点故障时,从节点自动接替。
好处:高存储量(分片存储)、高性能(多主节点同时处理读写)、高可用(自动故障转移)
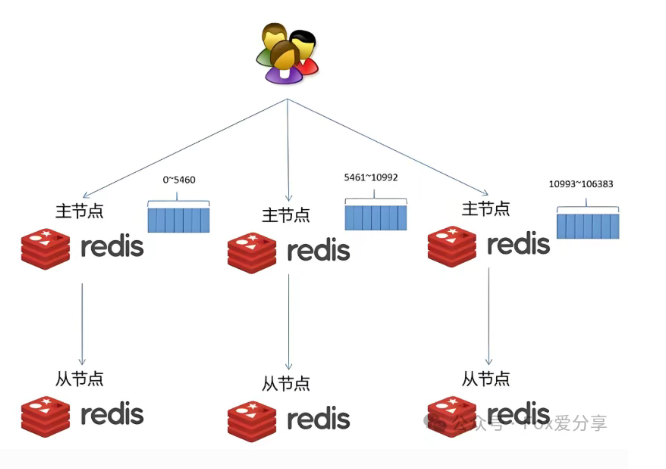
集群的实现
创建 6 个实例,6379,6380,6381,6389,6390,6391
配置(以 redis6379.conf 为例)
include /home/hadoop/myassets/redis.conf
pidfile /var/run/redis_6379.pid
port 6379
dbfilename dump6379.rdb

# 打开集群模式
cluster-enabled yes
# 设定节点配置文件名
cluster-config-file nodes-6379.conf
# 设定节点失联时间,超过该时间(毫秒),集群自动进行主从切换。
cluster-node-timeout 15000
启动 6 个 redis 服务
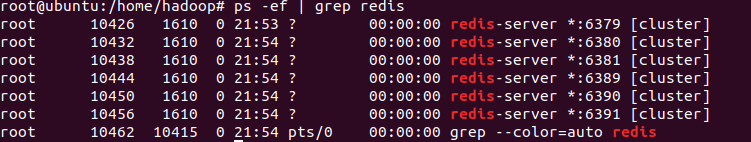
组合之前,请确保所有 redis 实例启动后,nodes-xxxx.conf 文件都生成正常。

合成一个集群
cd  /opt/redis-6.2.1/src
root@ubuntu:/opt/redis-6.2.6/src# redis-cli --cluster create --cluster-replicas 1 192.168.190.136:6379 192.168.190.136:6380 192.168.190.136:6381 192.168.190.136:6389 192.168.190.136:6390 192.168.190.136:6391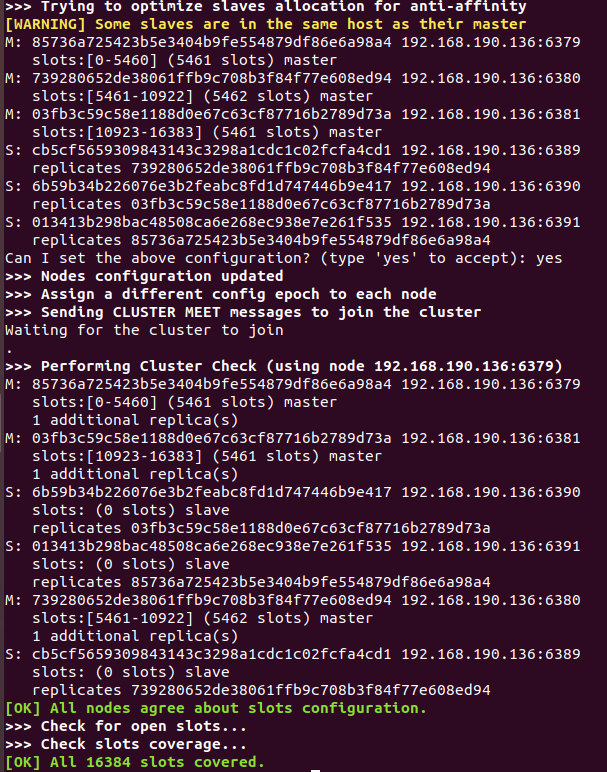
此处不要用 127.0.0.1, 请用真实 IP 地址
--replicas 1 采用最简单的方式配置集群,一台主机,一台从机,正好三组。
采用集群策略连接
普通方式登录, 直接进入读主机,存储数据时,可能会出现 MOVED 重定向操作。所以,应该以集群方式登录。
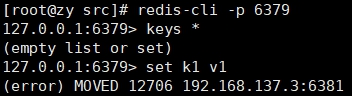
-c 采用集群策略连接,设置数据会自动切换到相应的写主机
cluster nodes 命令查看集群信息

如何分配节点
一个集群至少要有三个主节点。
选项 --cluster-replicas 1 表示我们希望为集群中的每个主节点创建一个从节点。
分配原则尽量保证每个主数据库运行在不同的 IP 地址,每个从库和主库不在一个 IP 地址上。
slots
一个 Redis 集群包含 16384 个插槽(hash slot), 数据库中的每个键都属于这 16384 个插槽的其中一个,
集群使用公式 CRC16(key) % 16384 来计算键 key 属于哪个槽, 其中 CRC16(key) 语句用于计算键 key 的 CRC16 校验和 。
集群中的每个节点负责处理一部分插槽。 举个例子, 如果一个集群可以有主节点, 其中:
节点 A 负责处理 0 号至 5460 号插槽。
节点 B 负责处理 5461 号至 10922 号插槽。
节点 C 负责处理 10923 号至 16383 号插槽。
集群中录入值
在 redis-cli 每次录入、查询键值,redis 都会计算出该 key 应该送往的插槽,如果不是该客户端对应服务器的插槽,redis 会报错,并告知应前往的 redis 实例地址和端口。
redis-cli 客户端提供了 –c 参数实现自动重定向。
如 redis-cli -c –p 6379 登入后,再录入、查询键值对可以自动重定向。
不在一个 slot 下的键值,是不能使用 mget, mset 等多键操作。

可以通过{}来定义组的概念,从而使 key 中{}内相同内容的键值对放到一个 slot 中去。

查询集群中值
CLUSTER GETKEYSINSLOT <slot><count> 返回 count 个 slot 槽中的键。
故障恢复
主节点下线,从节点经历超时时间后自动升为主节点。
主节点恢复后,主节点变成从机。
如果某一段插槽的主从都挂掉,而 cluster-require-full-coverage 为 yes ,那么 ,整个集群都挂掉
如果某一段插槽的主从都挂掉,而 cluster-require-full-coverage 为 no ,那么,该插槽数据全都不能使用,也无法存储。
redis.conf 中的参数 cluster-require-full-coverage
集群的 Java 实现
即使连接的不是主机,集群会自动切换主机存储。主机写,从机读。
无中心化主从集群。无论从哪台主机写的数据,其他主机上都能读到数据。
public class JedisClusterTest {
  public static void main(String[] args) {
     Set<HostAndPort>set =new HashSet<HostAndPort>();
     set.add(new HostAndPort("192.168.31.211",6379));
     JedisCluster jedisCluster=new JedisCluster(set);
     jedisCluster.set("k1", "v1");
     System.out.println(jedisCluster.get("k1"));
  }
}
集群的优势
实现扩容
分摊压力
无中心配置相对简单
集群的不足
多键操作是不被支持的
多键的 Redis 事务是不被支持的。lua 脚本不被支持
由于集群方案出现较晚,很多公司已经采用了其他的集群方案,而代理或者客户端分片的方案想要迁移至 redis cluster,需要整体迁移而不是逐步过渡,复杂度较大。
Redis 实战场景
下列场景图源自黑马程序员视频
Redis 代替 Session 实现登录
基于 Session 的登录流程
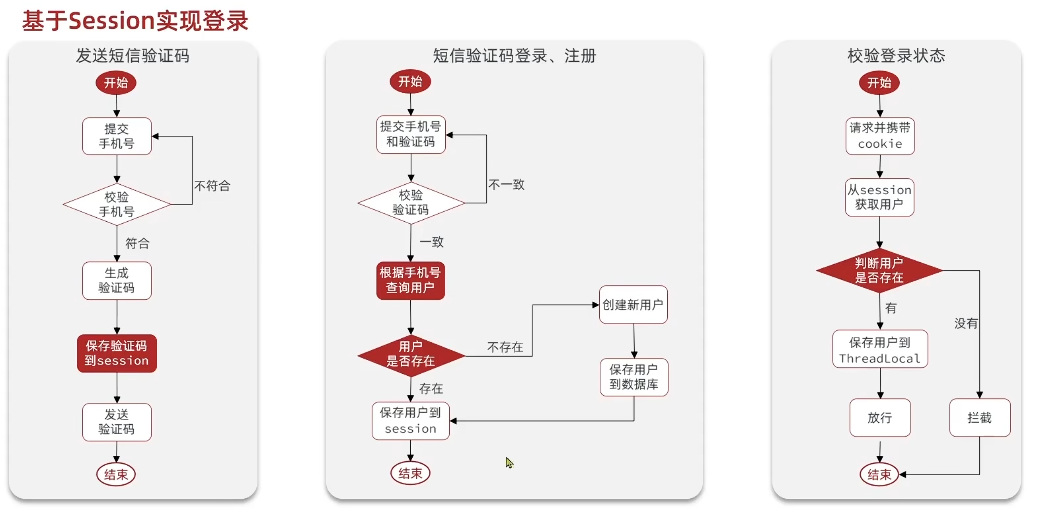
校验登录状态的功能,通常写在 Servlet 过滤器 或者 SpringMVC 的拦截器中,有利于代码复用。拦截器验证成功后,将用户保存到 ThreadLocal 以便后续业务使用,然后放行,
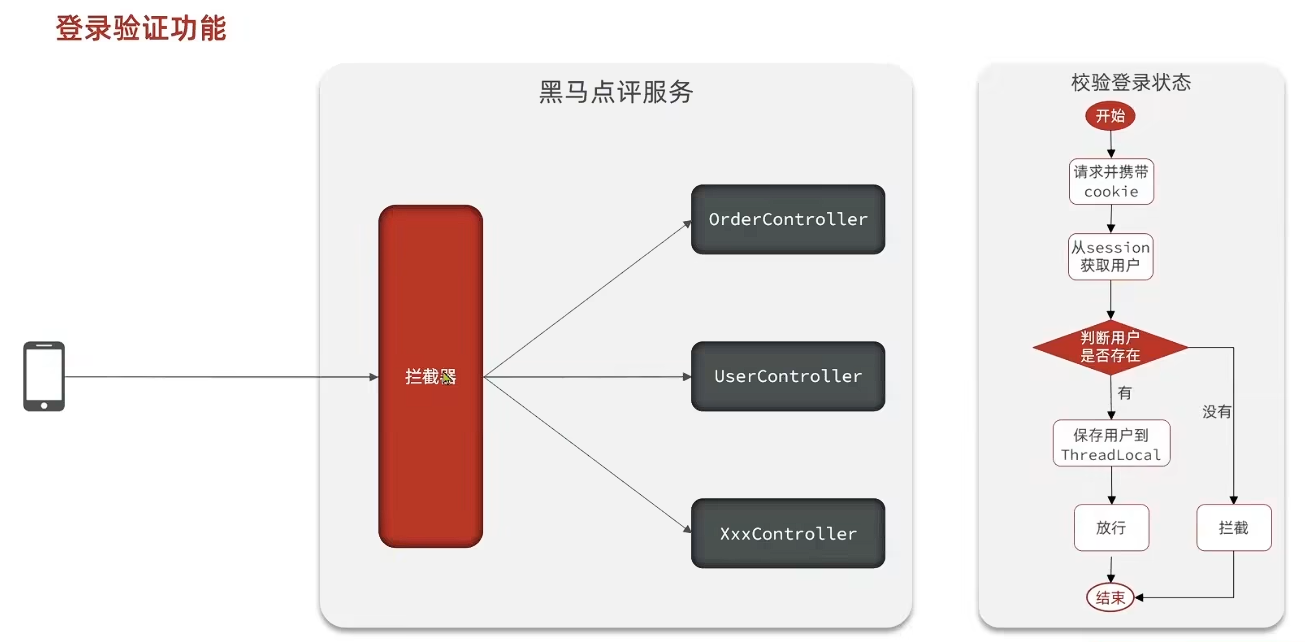
注意:
- 登录时存入 Session 的用户信息不要太臃肿
- 登录验证接口不要返回敏感信息
基于 Redis 的登录流程
Redis 引子之 session 分布式共享问题:多台 Tomcat 并不共享 session 存储空间,当请求切换到不同 tomcat 服务时导致数据丢失的问题。
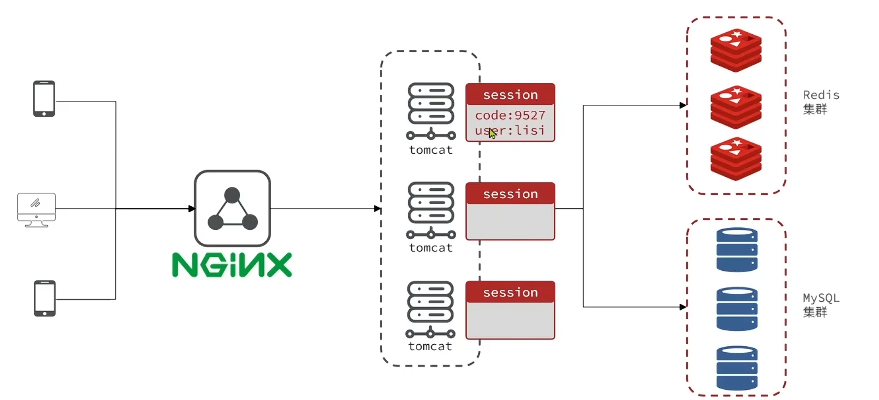
解决方案:
- 服务器之间 session 拷贝同步(存在延迟)
- Redis 共享用户信息 (基于内存数据共享)
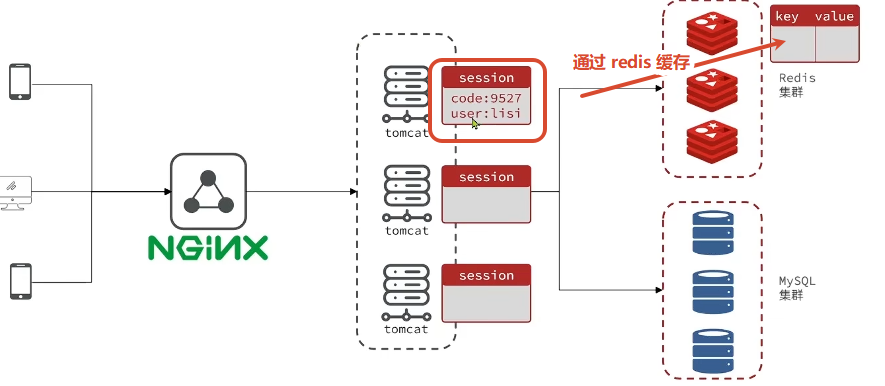
用 Redis 代替 session 登录
String 型数据存储验证码,设置超时时间
set phone:130xxxxxxxx 9527 5分钟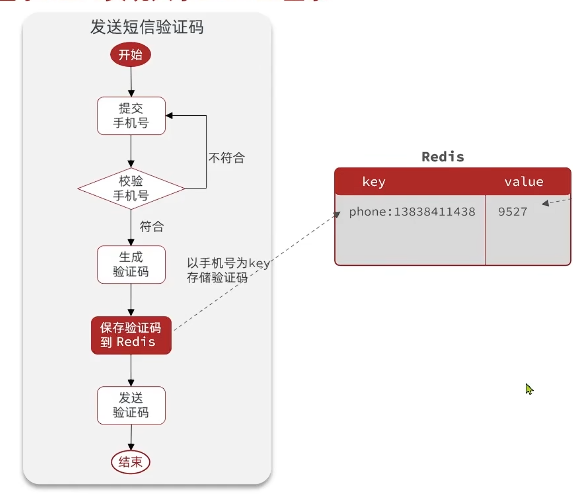
session 登录凭证时效性问题:在 Session 保存登录的用户信息时,sessionid 自动保存到浏览器的 cookie 中,前端每次请求携带 sessionid 并找到对应的 session ,所以 sessionid 就是登录凭证,但是 cookie 默认 关闭浏览器就会失效,session 默认半个小时无请求就会过期,登录时效性太短,长期不点击或者退出浏览器都会退出登录。
通常的做法是在登录时生成并返回给前端一个唯一性的 token(例如 UUID 生成),由前端自行保管(cookie/localStorage/sessionStorage),后续的请求都要带上 token (通常附在请求头中)来验证登录状态。
// 前端 登录 部分逻辑
login(){
    axios.post("/user/login", this.form).then(({data}) =>{
        if (data) {
            // 登录成功后 保存用户信息到sessionStorage
            sessionStorage.setItem("token", data);
        }
        // 跳转到首页
        location.href = "/info.html"
    })
    .catch(err => this.$message.error(err))
},// 前端拦截器 部分逻辑
// request拦截器,将用户token放入头中
let token = sessionStorage.getItem("token");
axios.interceptors.request.use(
config => {
if(token) config.headers['authorization'] = token
return config
},
error => {
console.log(error)
return Promise.reject(error)
}
}在 Redis 中保存登录的用户信息。以随记 token 为 key。以用户信息为 Value 可以使用 String 型 + JSON 字符串 ,比较直观,也可以使用 Hash 型,内存占用更少。用户信息需要设置过期时间,拦截器每次验证登录状态时,也要刷新 token 的过期时间。
// 登录 部分逻辑
String token = UUID.randomUUID().toString(isSimple: true);
String tokenKey = LOGIN_USER_KEY + token; // key
UserDTO userDTO = BeanUtil.copyProperties(user, UserDTO.class);
Map<String, Object> userMap = BeanUtil.beanToMap(userDTO); // value
stringRedisTemplate.opsForHash().putAll(tokenKey,userMap); // 存入 redis
stringRedisTemplate.expire(tokenKey,LOGIN_USER_TTL,TimeUnit.MINUTES); // 设置有效期// 校验 部分逻辑
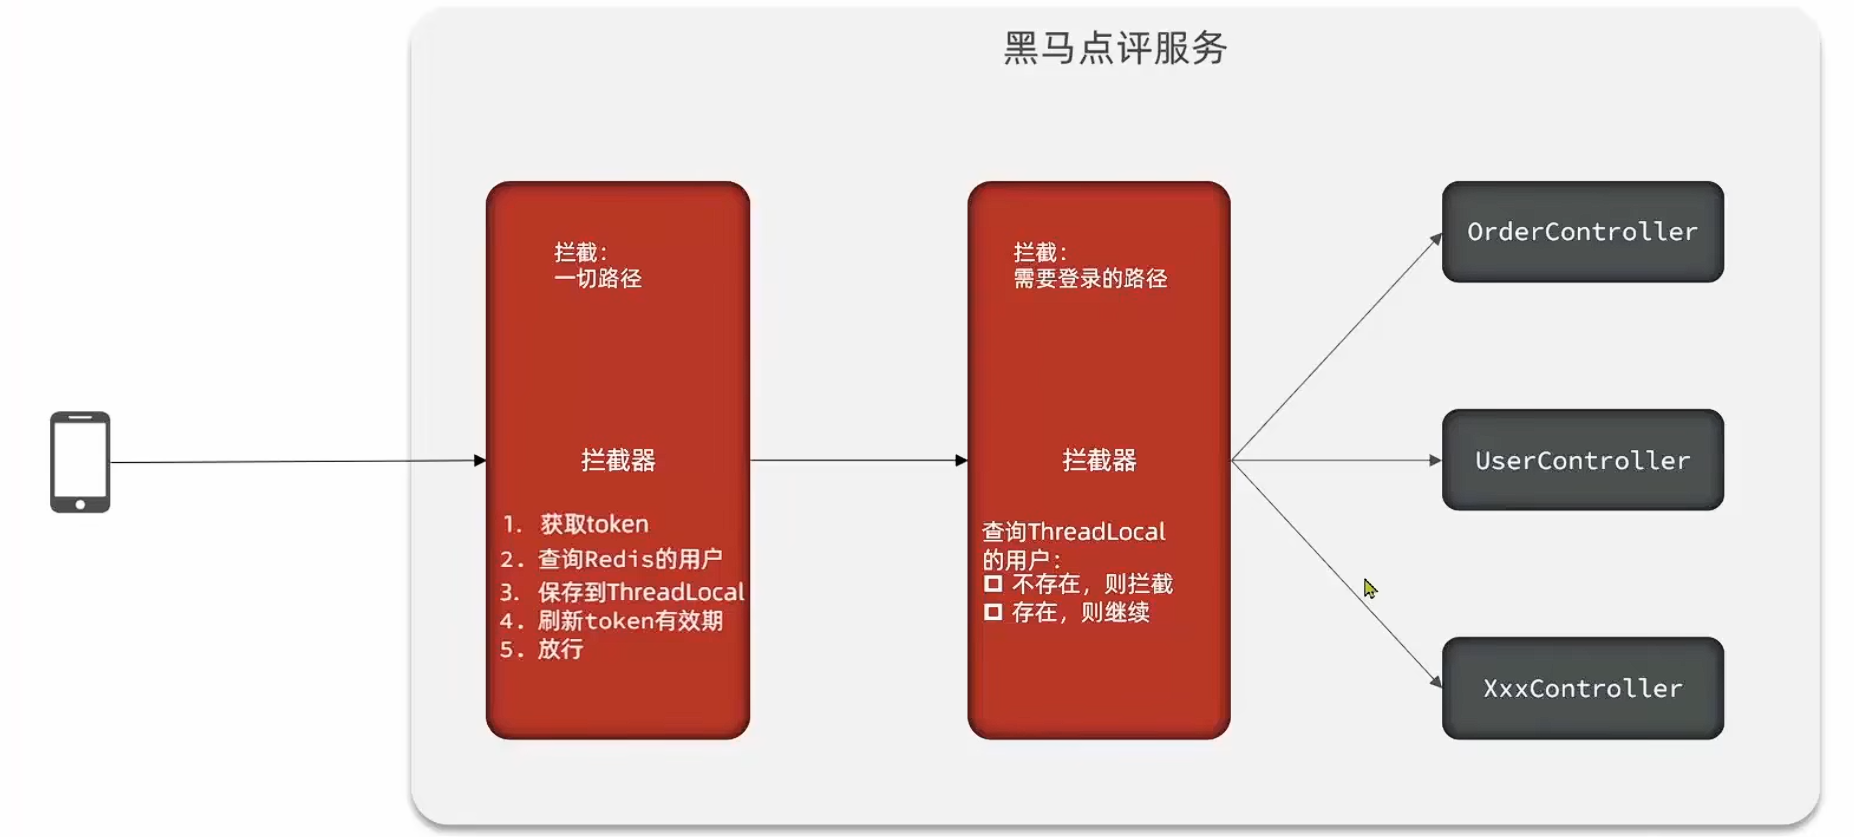
stringRedisTemplate.expire(key,RedisConstants.LOGIN_USER_TTL, TimeUnit.MINUTES); // 刷新token有效期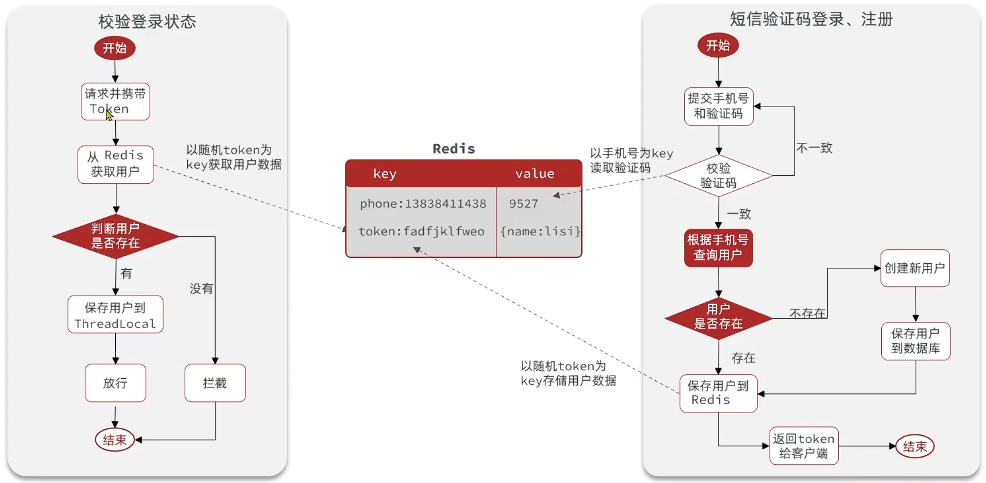
由于 token 的有效期每次请求都要重置一次,因此拦截器需要拆分,不能只针对需要登录的业务。
查询缓存
缓存是什么
缓存就是数据交换的缓冲区(称作 Cache [kæ∫]),是存贮数据的临时地方,一般读写性能较高。
缓存的应用场景非常广泛,浏览器缓存、服务器应用层缓存、数据库缓存、磁盘缓存、CPU 缓存...
缓存的好处:
- 降低后端负载
- 提高读写效率,降低响应时间
好处的成本:
- 数据一致性成本
- 代码维护成本
- 运维成本
查询缓存流程和缓存一致性问题
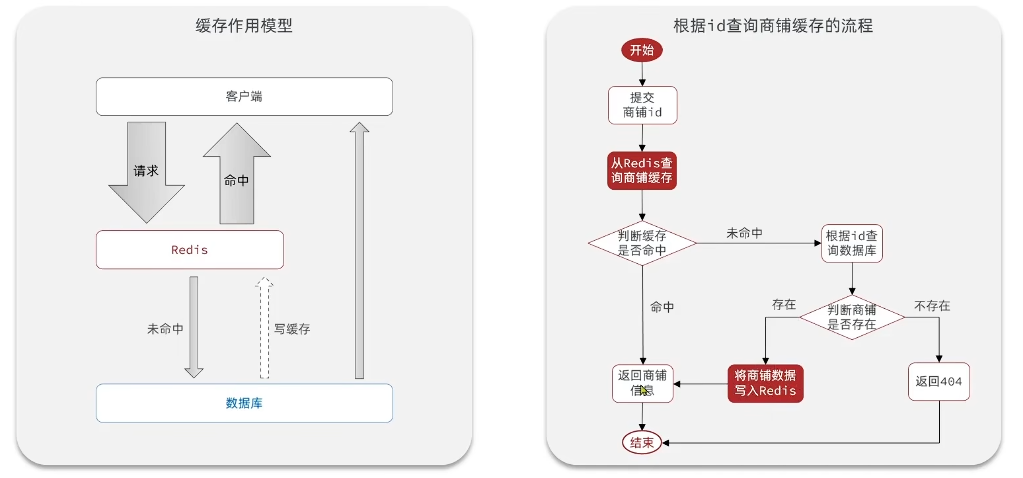
缓存一致性问题:数据库修改后,缓存没有更新,用户查询得到旧数据与数据库中数据不一致。
解决方案:
- 内存淘汰机制:直接利用 Redis 的内存淘汰机制,内存不足自动淘汰部分数据。虽然无需做任何维护的动作,但是一致性十分差。
- 超时剔除:给缓存数据添加 TTL 时间,到期后自动删除缓存。下次查询时更新缓存。设置缓存有效期很简单,但是一致性一般。适合 低一致性需求 的场景例如,店铺类型的查询缓存。
- 主动更新:编写业务逻辑,在修改数据库的同时,更新缓存。上图就是使用这个方案,一致性好,但是需要维护的内容比较多。适合 高一致性需求 的场景例如,店铺详情的查询缓存。
- 缓存搁置模式:由缓存的调用者,在更新数据库的同时更新缓存。这是最稳当的一种 模式。
- 读写直通模式:缓存与数据库整合为一个服务,无需关心缓存一致性。
- 后写式缓存模式:调用者只操作缓存,由其他缓存异步将缓存持久化到数据库,保证 最终一致性。还能将缓存的多次写操作整合成数据库的一次操作。
当我们采用了主动更新的缓存搁置模式的缓存方案,还需考虑以下三个问题:
新数据写入数据库后缓存的处理方式?
更新缓存:每次更新数据库都更新缓存,无效写操作较多
删除缓存:更新数据库时让缓存失效,查询时再更新缓存
如何保证缓存与数据库的操作的同时成功或失败?
单体系统,将缓存与数据库操作放在一个 事务
分布式系统,利用 TCC 等分布式事务方案
先操作缓存还是先操作数据库?
先删除缓存,再写入数据库,容易出现并发问题。
先写入数据库,再删除缓存,在满足原子性的情况下,这个方式并发问题出现的概率较低。
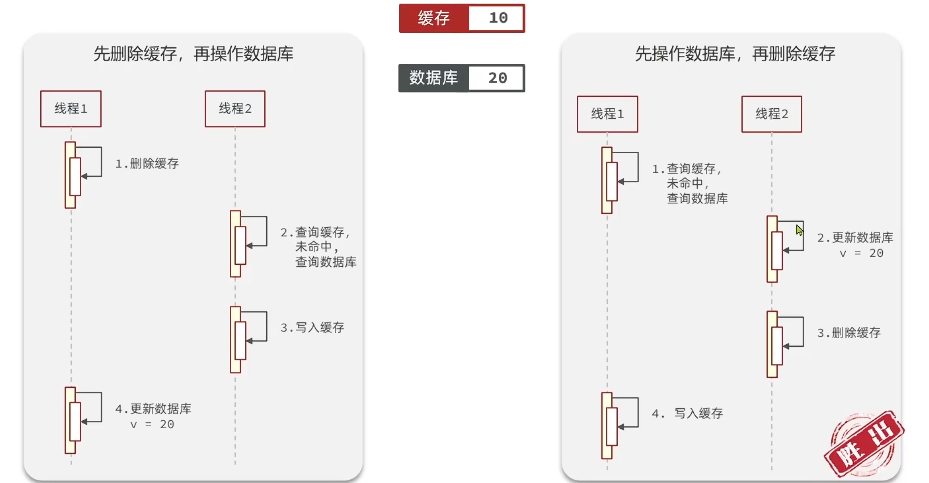
主动更新由于多线程操作,依然会有缓存不一致的现象出现,因此建议用 超时剔除作为兜底方案
查询缓存最佳实践
查询数据时:
- 先查询缓存
- 如果缓存命中,直接返回
- 如果缓存未命中,则查询数据库
- 将数据库数据写入缓存
- 返回结果
修改数据库时(需要事务)
- 先修改数据库
- 然后删除缓存
全局唯一 ID
数据库自增的 ID 有以下问题:
- id 的规律性太明显,在某些业务系统中会暴露一些关键信息
- 受单表数据量的限制,单表数据量性能有限,如果出现分表分库、集群则无法保证 id 的唯一性。
全局 ID 生成器,是一种在分布式系统下用来生成全局唯一 ID 的工具,一般要满足下列特性:
- 唯一性
- 高可用
- 高性能
- 递增性
- 安全性
全局唯一 ID 生成策略:
- JDK 自带 UUID,16 进制符号的字符串
- snowflack 雪花算法,性能好,对时钟依赖高
- Redis 自增
- 数据库内维护一个负责自增的表
为了增加 ID 的安全性,我们可以不直接使用 Redis 自增的数值,而是拼接一些其它信息:
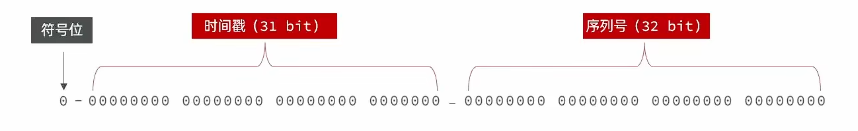
ID 的组成部分:
- 符号位:1bit,永远为 0
- 时间戳:31bit,以秒为单位,可以使用 69 年
- 序列号: 32bit,秒内的计数器,支持每秒产生 2^32 个不同 ID
@Component
public class RedisWorker {

    private StringRedisTemplate stringRedisTemplate;

    private static final int COUNT_BITS = 32;

    private RedisWorker(StringRedisTemplate stringRedisTemplate) {
        this.stringRedisTemplate = stringRedisTemplate;
    }

    private static long BEGIN_TIMESTAMP = 1784948871L;
    public long nextID(String keyPrefix) {
        // 生成时间戳
        LocalDateTime now = LocalDateTime.now();
        long nowTimestamp = now.toEpochSecond(ZoneOffset.UTC);
        long timestamp = nowTimestamp - BEGIN_TIMESTAMP;

        // 生成序列号
        String date = now.format(DateTimeFormatter.ofPattern("yyyy:MM:dd"));
        long count = stringRedisTemplate.opsForValue().increment("icr:" + keyPrefix + date);
        return timestamp << COUNT_BITS | count;
    }

    public static void main(String[] args) {
        LocalDateTime localDateTime = LocalDateTime.now();
        long nowTimestamp = localDateTime.toEpochSecond(ZoneOffset.UTC);
        System.out.println(nowTimestamp);
    }
}
秒杀超卖问题
秒杀流程
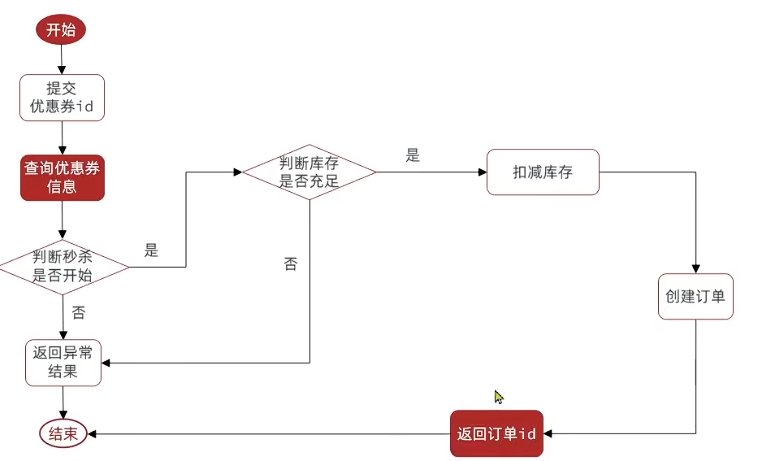
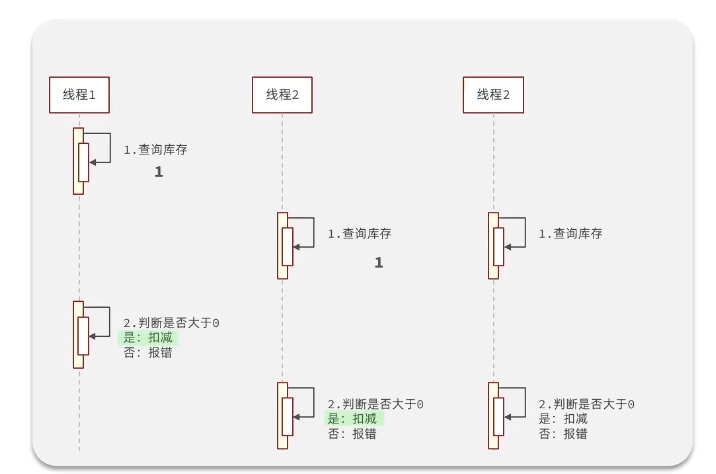
超卖问题
多个线程同一时间查询到的库存都是大于 0 的,都执行了扣减操作,但线程数大于库存数,因此扣减库存至负数。
超卖解决方案
- 加悲观锁,性能太差
- 加乐观锁,性能好
乐观锁的关键时判断之前的查询到的数据是否被修改过,两种常见方式:
版本号,每一次查询要带上版本号,每一次写操作要先判断版本号是否发生改变,成功以后要使版本号加 1。
sqlselect stock, version from stocks where id = 10; update stocks set stock = stock - 1, version = version + 1 where id = 10 and version = 1;CAS,与版本号判断类似,但不维护版本号,而是直接用数据来比较,也就是 compare and swap。
sqlselect stock from stocks where id = 10; update stocks set stock = stock - 1, version = version + 1 where id = 10 and stock = 1;
但是秒杀情况下会出现获得并发的线程,因此 CAS 成功率不高,我们可以考虑在代码加上自旋或者时直接将 compare 条件改为 stock > 0 ,确保库存足够时任何线程都能够修改成功。
一人一单(单机情况)
要求一个用户只能购买有限的货物数量,也就是用户创建的订单不能超过限制,这种情况不属于修改数据的行为,因此无法使用乐观锁,只能使用 syncronized 等同步机制。
锁是用户 id。锁的范围必须要大于等于事务的范围,否则锁释放了以后,事务还未提交,其他线程查询到没更新的用户订单数量。
实战篇-03.优惠券秒杀-添加优惠券_哔哩哔哩_bilibili
基于 Redis 的消息队列
实战篇-25.Redis 消息队列-认识消息队列_哔哩哔哩_bilibili
Redis 应用问题解决
缓存穿透
问题描述
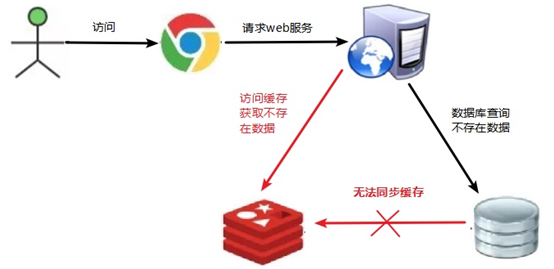
查询一个 根本不存在于数据库中的数据。由于缓存遵循“查不到就不存”的原则,这类请求会直接绕过缓存,穿透到后端的数据库上进行查询。
数据库不存在该数据,在有缓存和没缓存的情况下请求都会到数据库中,简言之 Redis 只缓存“存在的数据”。讨论这个问题是因为我们可以从缓存这个层面去解决缓存穿透在某些场景可能会产生的更严重问题,例如
- 秒杀、热搜场景下,每秒有万级别请求查询一个不存在的商品 ID
- 大量穿透请求涌入,数据库线程会忙于执行这些无效的
SELECT查询,导致连接池被占满,正常的请求阻塞。- 容易被黑客或爬虫利用这一点,故意构造大量随机不存在的 Key,属于廉价、有效的后端攻击。
解决方案
接口检验参数。用户编号不可能是小于 1 或极大的数字,应该限制无法请求。杜绝一切非法请求。
对空值缓存
- 把查询的到的空结果也进行缓存,设置空结果的过期时间会很短,最长不超过五分钟
- 优点:实现简单,维护方便。缺点:额外的内存消耗
设置可访问的名单(白名单)
- 使用 bitmaps 类型定义一个可以访问的名单 id 作为 bitmaps 的偏移量,每次访问和 bitmap 里面的 id 进行比较,如果访问 id 不在 bitmaps 里面,进行拦截,不允许访问。
- 优点:实现相对简单,不会误判。缺点:数据量越多,内存占用越大。
采用布隆过滤器
- 它实际上是一个很长的 二进制向量(位图)和一系列随机 映射 函数(哈希函数)。将所有可能存在的数据散列到一个足够大的 bitmaps 中,一个一定不存在的数据会被这个 bitmaps 拦截掉,从而避免了对底层存储系统的查询压力。
- 下面以白名单为例,演示布隆过滤器的工作原理
- 初始化。创建长度为 m 的位数组(Bit Array),所有位初始值都为 0。准备 k 个不同的哈希函数。
- 预热。扫描数据库全表,将存在的 key 写入布隆过滤器。
- 写入过程。key 通过 k 个哈希函数找到到布隆过滤器的 k 个位置,并设置为 1。
- 读取过程。key 通过 k 个哈希函数找到到布隆过滤器的 k 个位置,查看值。
- 用户查询。发现缓存不存在(不知道是缓存失效,还是数据库真的没有数据),如果有任意一位是 0,说明数据一定不存在,如果所有位置都是 1,说明数据可能存在。
- 业务新增。执行 SQL
INSERT写入数据库成功后,将 key 写入布隆过滤器。
- 优点:内存占用较少。缺点:实现复杂,可能误判。
进行实时监控
发现 Redis 的命中率开始急速降低,需要排查访问对象和访问的数据,和运维人员配合,可以设置黑名单限制服务。
缓存击穿
问题描述
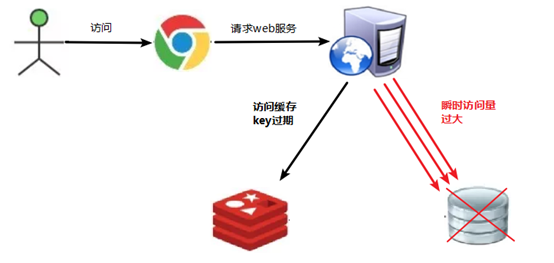
key 对应的数据存在,但在 redis 中过期,此时有并发请求过来,虽然这些请求发现缓存过期一般都会从后端 DB 加载数据并回设到缓存,但大并发的请求可能会 瞬间 把后端 DB 压垮。
缓存击穿问题也叫热点 Key 问题,就是一个被高并发访问并且缓存重建业务较复杂的 key 突然失效了,无数的请求访问会在瞬间给数据库带来巨大的冲击。
解决方案
key 可能会在某些时间点被超高并发地访问,是一种非常“热点”的数据。这个时候,需要考虑一个问题:缓存被“击穿”的问题。
预先设置热门数据
在 redis 高峰访问之前,把一些热门数据提前存入到 redis 里面,加长这些热门数据 key 的时长,甚至永远不过期。
实时调整
现场监控哪些数据热门,实时调整 key 的过期时长
接口限流与熔断,降级。
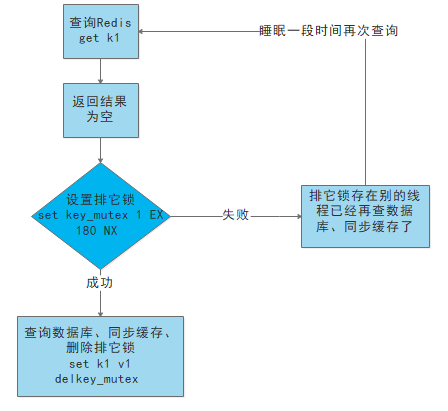
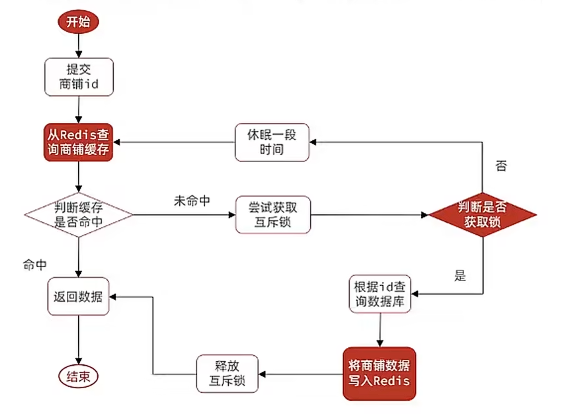
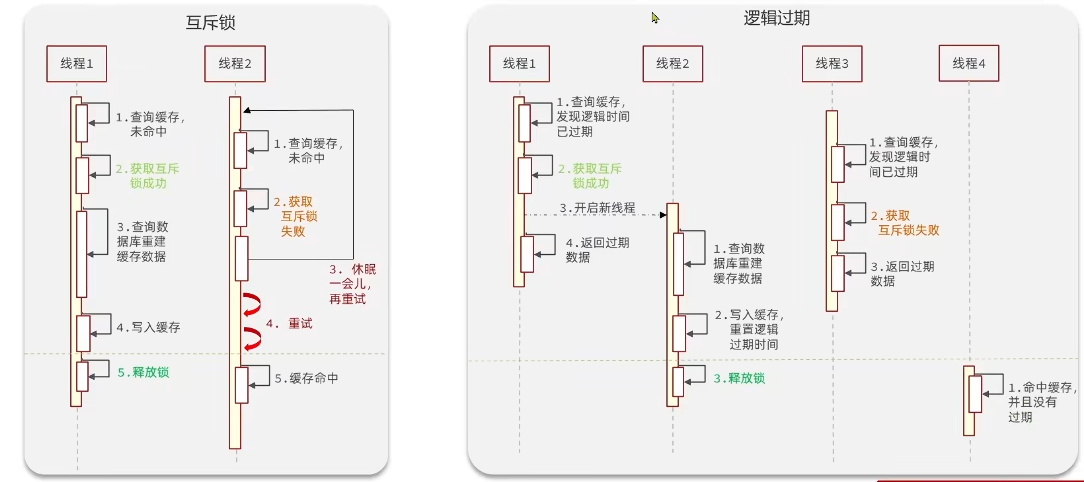
使用锁(这个互斥锁的获取与释放是基于
setnx和del实现 )- 就是在缓存失效的时候(判断拿出来的值为空),不是立即去 load db。
- 先使用缓存工具的某些 带成功操作返回值 的操作(比如 Redis 的 SET NX)去 set 一个 mutex key
- 当操作返回成功时,再进行 load db 的操作,并回设缓存, 最后删除 mutex key;
- 当操作返回失败,证明有线程在 load db,当前线程睡眠一段时间再重试整个 get 缓存的方法。
 java
private boolean tryLock(String key) {
    Boolean flag = stringRedisTemplate.opsForValue().setIfAbsent(key, value: "1", timeout: 10, TimeUnit.SECONDS);
    return BooleanUtil.isTrue(flag);
}
private void unlock(String key) {
	stringRedisTemplate.delete(key);
}
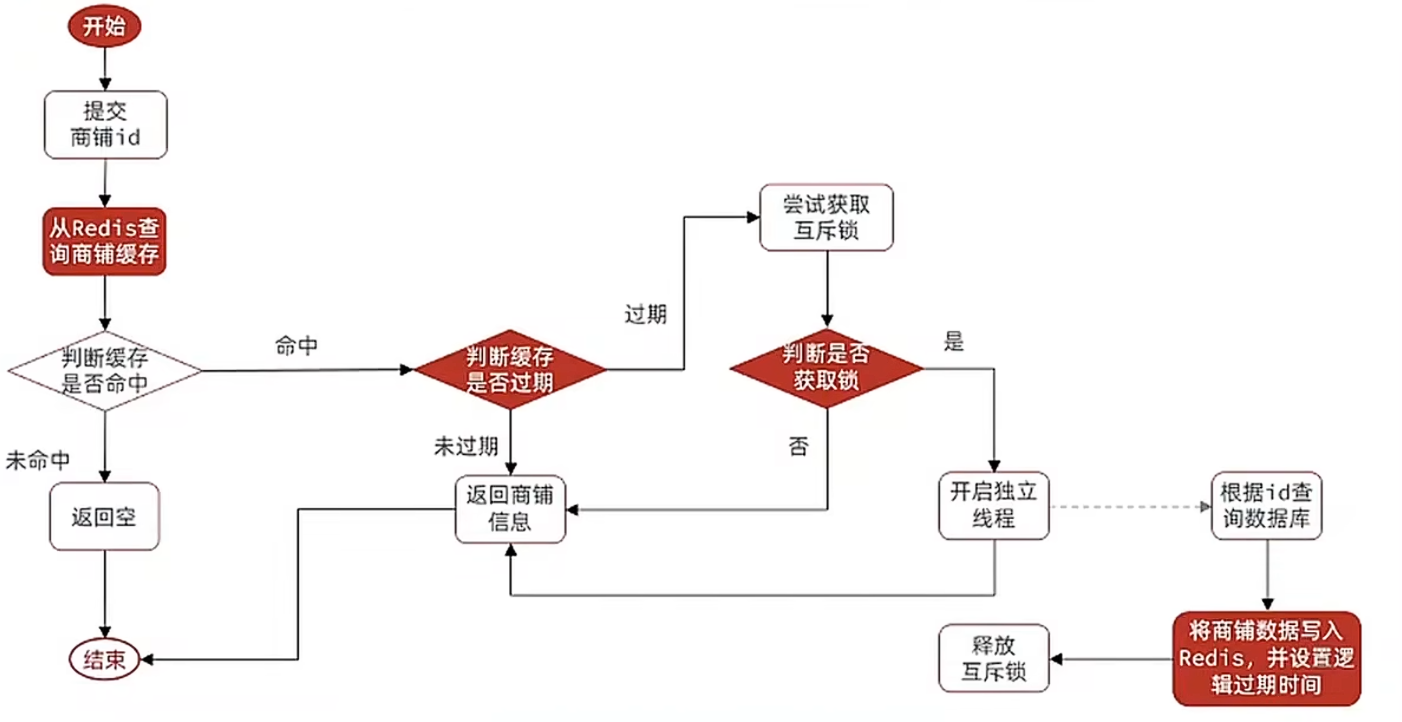
逻辑过期
不设置 key 的有效期
在 value 中额外维护一个逻辑过期时间
当查询缓存发现逻辑时间未过期
直接返回缓存数据
当查询缓存发现逻辑时间已过期
获取互斥锁成功
- 开启一个新的线程去查询重建缓存
- 不等待线程任务完成,直接返回旧的数据
- 异步线程,查到新数据后,写入缓存,并重置逻辑过期时间,释放锁。
获取互斥锁失败
- 说明已有线程正在重建缓存,直接返回旧数据
使用锁和逻辑过期方案对比
解决方案 优点 缺点 互斥锁 没有额外的内存消耗
保证一致性
实现简单线程需要等待,性能受影响
可能有死锁风险逻辑过期 线程无需等待,性能较好 不保证一致性
有额外内存消耗
实现复杂
缓存雪崩/缓存宕机
问题描述
key 对应的数据存在,但在 redis 中过期,此时若有大量并发请求过来,这些请求发现缓存过期一般都会从后端 DB 加载数据并回设到缓存,这个时候大并发的请求可能会瞬间把后端 DB 压垮。缓存如果宕机了也是一样的道理。
缓存雪崩与缓存击穿的区别在于这里针对很多 key 缓存,前者则是某一个 key 正常访问。
解决方案
缓存失效时的雪崩效应对底层系统的冲击非常可怕!
构建多级缓存架构
nginx 缓存 + redis 缓存 +其他缓存(ehcache 等)
使用锁或队列
用加锁或者队列的方式来保证不会有大量的线程对数据库一次性进行读写,从而避免失效时大量的并发请求落到底层存储系统上。不适用高并发情况
设置过期标志更新缓存
记录缓存数据是否过期(设置提前量),如果过期会触发通知另外的线程在后台去更新实际 key 的缓存。
将缓存失效时间分散开
比如我们可以在原有的失效时间基础上增加一个 随机值,比如 1-5 分钟随机,这样每一个缓存的过期时间的重复率就会降低,就很难引发集体失效的事件。
针对宕机的解决方案:
- 利用 Redis 集群提高服务的可用性,开启哨兵模式。
- 给缓存业务添加降级限流策略,当 Redis 故障时,做服务降级或拒绝服务。
分布式锁
问题描述
随着业务发展的需要,原单体单机部署的系统被演化成分布式集群系统后,由于分布式系统多线程、多进程并且分布在不同机器上,这将使原单机部署情况下的并发控制锁策略失效,单纯的 Java API 并不能提供分布式锁的能力。为了解决这个问题就需要一种跨 JVM 的互斥机制来控制共享资源的访问,这就是分布式锁要解决的问题!
即一台服务器加锁,对集群中的其他节点也生效
分布式锁主流的实现方案
基于数据库实现分布式锁
基于缓存(Redis 等,性能高)
基于 Zookeeper(可靠性高)
使用 redis 实现分布式锁
set sku:1:info “OK” NX PX 10000
EX second :设置键的过期时间为 second 秒。 SET key value EX second 效果等同于 SETEX key second value 。
PX millisecond :设置键的过期时间为 millisecond 毫秒。 SET key value PX millisecond 效果等同于 PSETEX key millisecond value 。
NX :只在键不存在时,才对键进行设置操作。 SET key value NX 效果等同于 SETNX key value 。
XX :只在键已经存在时,才对键进行设置操作。
如果直接使用两句命令分别设置值以及过期时间,因为没有原子性可能导致过期时间没有设置。
分布式锁流程
多个客户端同时获取锁(setnx)
获取成功,执行业务逻辑{从 db 获取数据,放入缓存},执行完成释放锁(del)
其他客户端等待重试
分布式锁 Java 实现
@GetMapping("testLock")
public void testLock(){
    //1获取锁,setne
    Boolean lock = redisTemplate.opsForValue().setIfAbsent("lock", "111");
    //2获取锁成功、查询num的值
    if(lock){
        Object value = redisTemplate.opsForValue().get("num");
        //2.1判断num为空return
        if(StringUtils.isEmpty(value)){
            return;
        }
        //2.2有值就转成成int
        int num = Integer.parseInt(value+"");
        //2.3把redis的num加1
        redisTemplate.opsForValue().set("num", ++num);
        //2.4释放锁,del
        redisTemplate.delete("lock");

    }else{
        //3获取锁失败、每隔0.1秒再获取
        try {
            Thread.sleep(100);
            testLock();
        } catch (InterruptedException e) {
            e.printStackTrace();
        }
    }
}
分布式锁优化
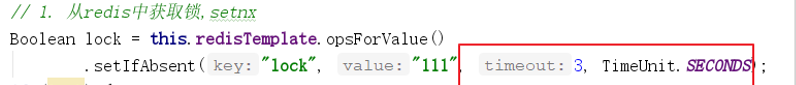
问题:setnx 刚好获取到锁,业务逻辑出现异常,导致锁无法释放
解决:设置锁的过期时间
问题:当 set 锁之后,服务器异常,导致不能 setnx,锁无法释放
解决:在 set 时指定过期时间 [如何在 set 时指定过期时间](#13.4.3 使用redis实现分布式锁)
问题:当该服务器的锁过期时间已到,此时再 del 释放锁,可能会释放其他服务器的锁。
解决:setnx 获取锁时,设置一个指定的唯一值(例如:uuid);释放前获取这个值,判断是否自己的锁
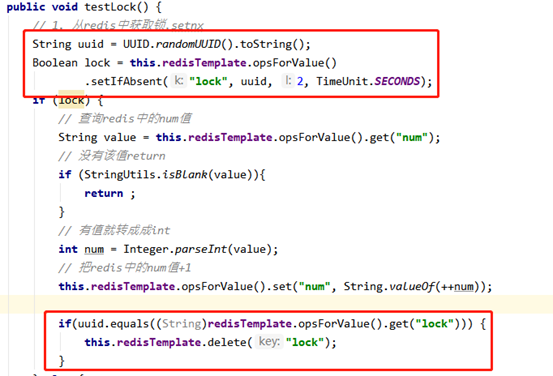
问题:删除操作缺乏原子性。
解决:LUA 脚本保证删除的原子性
java@GetMapping("testLockLua") public void testLockLua() { //1 声明一个uuid ,将做为一个value 放入我们的key所对应的值中 String uuid = UUID.randomUUID().toString(); //2 定义一个锁:lua 脚本可以使用同一把锁,来实现删除! String skuId = "25"; // 访问skuId 为25号的商品 100008348542 String locKey = "lock:" + skuId; // 锁住的是每个商品的数据 // 3 获取锁 Boolean lock = redisTemplate.opsForValue().setIfAbsent(locKey, uuid, 3, TimeUnit.SECONDS); // 第一种: lock 与过期时间中间不写任何的代码。 // redisTemplate.expire("lock",10, TimeUnit.SECONDS);//设置过期时间 // 如果true if (lock) { // 执行的业务逻辑开始 // 获取缓存中的num 数据 Object value = redisTemplate.opsForValue().get("num"); // 如果是空直接返回 if (StringUtils.isEmpty(value)) { return; } // 不是空 如果说在这出现了异常! 那么delete 就删除失败! 也就是说锁永远存在! int num = Integer.parseInt(value + ""); // 使num 每次+1 放入缓存 redisTemplate.opsForValue().set("num", String.valueOf(++num)); /*使用lua脚本来锁*/ // 定义lua 脚本 String script = "if redis.call('get', KEYS[1]) == ARGV[1] then return redis.call('del', KEYS[1]) else return 0 end"; // 使用redis执行lua执行 DefaultRedisScript<Long> redisScript = new DefaultRedisScript<>(); redisScript.setScriptText(script); // 设置一下返回值类型 为Long // 因为删除判断的时候,返回的0,给其封装为数据类型。如果不封装那么默认返回String 类型, // 那么返回字符串与0 会有发生错误。 redisScript.setResultType(Long.class); // 第一个要是script 脚本 ,第二个需要判断的key,第三个就是key所对应的值。 redisTemplate.execute(redisScript, Arrays.asList(locKey), uuid); } else { // 其他线程等待 try { // 睡眠 Thread.sleep(1000); // 睡醒了之后,调用方法。 testLockLua(); } catch (InterruptedException e) { e.printStackTrace(); } } }
总结
为了确保分布式锁可用,我们至少要确保锁的实现同时 满足以下四个条件:
互斥性。在任意时刻,只有一个客户端能持有锁。
不会发生死锁。即使有一个客户端在持有锁的期间崩溃而没有主动解锁,也能保证后续其他客户端能加锁。
解铃还须系铃人。加锁和解锁必须是同一个客户端,客户端自己不能把别人加的锁给解了。
加锁和解锁必须具有原子性。
Redis 缓存工具封装
Redis 新功能
ACL
简介
Redis ACL 是 Access Control List(访问控制列表)的缩写,该功能允许根据可以执行的命令和可以访问的键来限制某些连接。
在 Redis 5 版本之前,Redis 安全规则只有 密码控制 还有通过 rename 来调整高危命令 比如 flushdb , KEYS* , shutdown 等。Redis 6 则提供 ACL 的功能对用户进行更细粒度的权限控制 :
- 接入权限: 用户名和密码
- 可以执行的命令
- 可以操作的 KEY
命令
- 使用
acl list命令展现用户权限列表
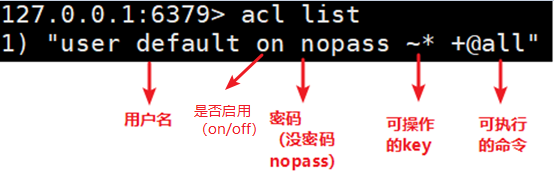
使用
acl cat命令 查看添加权限指令类别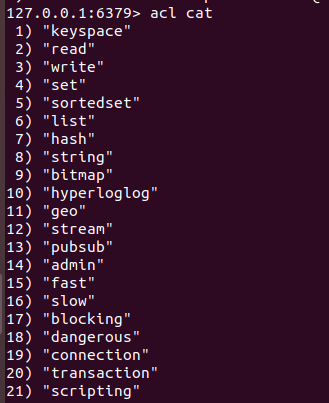
使用
acl cat 参数类型名可以查看类型下具体命令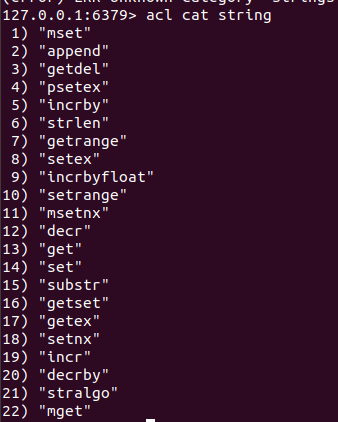
使用
acl whoami命令查看当前用户使用
acl setuser命令创建和编辑用户 ACL参数 说明 on 激活某用户账号 off 禁用某用户账号。注意,已验证的连接仍然可以工作。如果默认用户被标记为 off,则新连接将在未进行身份验证的情况下启动,并要求用户使用 AUTH 选项发送 AUTH 或 HELLO,以便以某种方式进行身份验证。 ><password>密码 ~<key>可操作的 key +<command>将指令添加到用户可以调用的指令列表中 -<command>从用户可执行指令列表移除指令 +@<category>添加该类别中用户要调用的所有指令,有效类别为@admin、@set、@sortedset…等,通过调用 ACL CAT 命令查看完整列表。特殊类别@all 表示所有命令,包括当前存在于服务器中的命令,以及将来将通过模块加载的命令。 -@<category>从用户可调用指令中移除类别 allcommands +@all 的别名 nocommand -@all 的别名 ~<pattern>添加可作为用户可操作的键的模式。例如~*允许所有的键 例
acl setuser user1如果用户不存在,这将使用 just created 的默认属性来创建用户。如果用户已经存在,则上面的命令将不执行任何操作。acl setuser user2 on >password ~cached:* +get创建密码为 password 只能对前缀为 cached: 的 key 进行 get 操作
使用
auth <username> <password>切换用户,验证权限
IO 多线程
IO 多线程其实指 客户端交互部分 的 网络 IO 交互处理模块 多线程,而非 执行命令多线程。Redis6 执行命令依然是单线程。
Redis 6 加入多线程, 但跟 Memcached 这种从 IO 处理到数据访问多线程的实现模式有些差异。Redis 的多线程部分只是用来处理网络数据的读写和协议解析,执行命令仍然是单线程。之所以这么设计是不想因为多线程而变得复杂,需要去控制 key、lua、事务,LPUSH/LPOP 等等的并发问题。整体的设计大体如下:
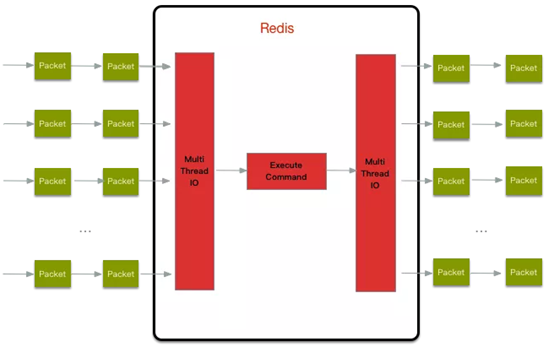
另外,多线程 IO 默认也是不开启的,需要再配置文件中配置
io-threads-do-reads yes

io-threads 4