
Kafka
Kafka 概述
Kafka 是一个由 Scala 和 Java 语言开发的,经典高吞吐量的 分布式消息发布和订阅系统,也是 大数据技术 领域中用作数据交换的核心组件之一。以高伸缩(可扩展性),高可靠性(持久性、容错性),高可用性(高并发、高吞吐,低延迟),且社区活跃度高等特性,从而备受广大技术组织的喜爱。
ApacheKafka 最初由 LinkedIn 开发并于 2011 年开源。他主要解决大规模数据的实时流式处理和数据管道问题。后来捐献给 Apache 基金会,开源。
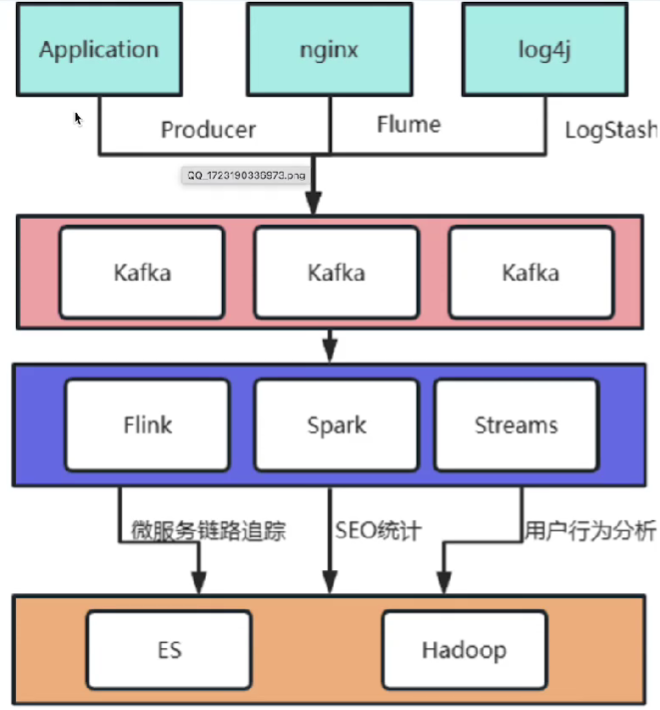
Kafka 拥有作为一个消息系统应该具备的功能,但是却有着独特的设计。可以这样说,Kafka 借鉴了 JMS 规范的思想,但是却并没有完全遵循 JMS 规范。这也恰恰是软件名称为 Kafka,而不是 KafkaMQ 的原因。
Kafka 基本结构
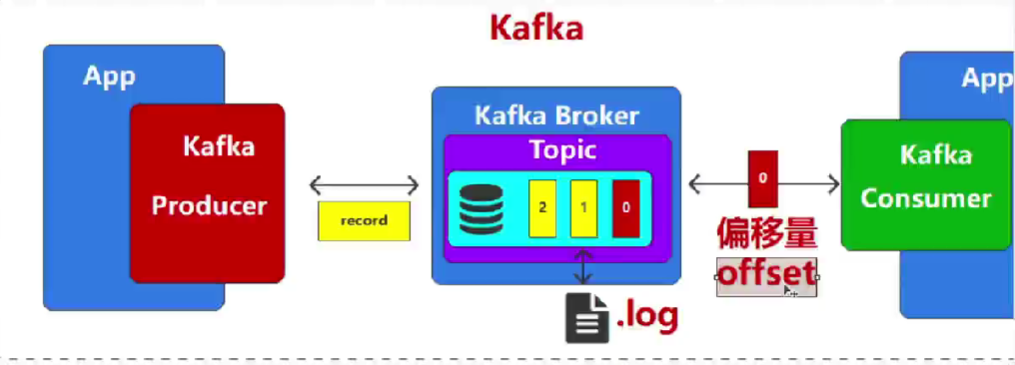
Kafka 版本
Kafka 4.0 不再支持 Java 8,彻底移除了 Zookeeper,正式启用 KRaft 模式,让 Kafka 变得更加独立、高效。
Kafka 安装
二进制安装
安装 JDK 虽然是 Scala 语言写的,但是二进制版本可以在 JVM 中运行。安装 Kafka ,安装 Zookeeper 提供集群环境
先启动 Zookeeper nohup bin/zookeeper-server-start.sh config/zookeeper.properties & ,再启动 kafka nohup bin/kafka-server-start.sh config/server-properties &
Docker 安装
以 4.3.1 版本为例
单机部署 自包含的 KRaft Kafka,让同一个进程同时扮演 broker 和 controller。
services:
    kafka:
        image: 'apache/kafka:4.3.1'
        container_name: kafka
        network_mode: bridge
        restart: unless-stopped
        ports:
            - '39092:9092'
        volumes:
            - "./config:/opt/kafka/config"
            - "./logs:/opt/kafka/logs"
        environment:
          KAFKA_NODE_ID: 1
          KAFKA_PROCESS_ROLES: broker,controller
          KAFKA_LISTENERS: PLAINTEXT://0.0.0.0:9092,CONTROLLER://0.0.0.0:9093
          KAFKA_ADVERTISED_LISTENERS: PLAINTEXT://192.168.10.3:39092
          KAFKA_CONTROLLER_LISTENER_NAMES: CONTROLLER
          KAFKA_LISTENER_SECURITY_PROTOCOL_MAP: CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT
          KAFKA_CONTROLLER_QUORUM_VOTERS: 1@localhost:9093
          KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR: 1
          KAFKA_TRANSACTION_STATE_LOG_REPLICATION_FACTOR: 1
          KAFKA_TRANSACTION_STATE_LOG_MIN_ISR: 1
          KAFKA_GROUP_INITIAL_REBALANCE_DELAY_MS: 0
          KAFKA_NUM_PARTITIONS: 3
集群部署——分离部署,Controller 节点 c1、c2、c3,Broker 节点 b1、b2、b3,比起合并部署好处就是隔离性好,适合大规模集群。
集群部署——合并部署(Controller+Broker 节点 cb1、cb2、cb3) ,比起分离部署好处就是节省及其、运维简单
# 集群部署
services:
  controller-1:
    image: apache/kafka:4.3.1
    container_name: controller-1
    environment:
      KAFKA_NODE_ID: 1
      KAFKA_PROCESS_ROLES: controller
      KAFKA_LISTENERS: CONTROLLER://:9093
      KAFKA_INTER_BROKER_LISTENER_NAME: PLAINTEXT
      KAFKA_CONTROLLER_LISTENER_NAMES: CONTROLLER
      KAFKA_CONTROLLER_QUORUM_VOTERS: 1@controller-1:9093,2@controller-2:9093,3@controller-3:9093
      KAFKA_GROUP_INITIAL_REBALANCE_DELAY_MS: 0

  controller-2:
    image: apache/kafka:4.3.1
    container_name: controller-2
    environment:
      KAFKA_NODE_ID: 2
      KAFKA_PROCESS_ROLES: controller
      KAFKA_LISTENERS: CONTROLLER://:9093
      KAFKA_INTER_BROKER_LISTENER_NAME: PLAINTEXT
      KAFKA_CONTROLLER_LISTENER_NAMES: CONTROLLER
      KAFKA_CONTROLLER_QUORUM_VOTERS: 1@controller-1:9093,2@controller-2:9093,3@controller-3:9093
      KAFKA_GROUP_INITIAL_REBALANCE_DELAY_MS: 0

  controller-3:
    image: apache/kafka:4.3.1
    container_name: controller-3
    environment:
      KAFKA_NODE_ID: 3
      KAFKA_PROCESS_ROLES: controller
      KAFKA_LISTENERS: CONTROLLER://:9093
      KAFKA_INTER_BROKER_LISTENER_NAME: PLAINTEXT
      KAFKA_CONTROLLER_LISTENER_NAMES: CONTROLLER
      KAFKA_CONTROLLER_QUORUM_VOTERS: 1@controller-1:9093,2@controller-2:9093,3@controller-3:9093
      KAFKA_GROUP_INITIAL_REBALANCE_DELAY_MS: 0

  broker-1:
    image: apache/kafka:4.3.1
    container_name: broker-1
    ports:
      - 29092:9092
    environment:
      KAFKA_NODE_ID: 4
      KAFKA_PROCESS_ROLES: broker
      KAFKA_LISTENERS: 'PLAINTEXT://:19092,PLAINTEXT_HOST://0.0.0.0:9092'
      KAFKA_ADVERTISED_LISTENERS: 'PLAINTEXT://broker-1:19092,PLAINTEXT_HOST://192.168.10.3:29092'
      KAFKA_INTER_BROKER_LISTENER_NAME: PLAINTEXT
      KAFKA_CONTROLLER_LISTENER_NAMES: CONTROLLER
      KAFKA_LISTENER_SECURITY_PROTOCOL_MAP: CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT,PLAINTEXT_HOST:PLAINTEXT
      KAFKA_CONTROLLER_QUORUM_VOTERS: 1@controller-1:9093,2@controller-2:9093,3@controller-3:9093
      KAFKA_GROUP_INITIAL_REBALANCE_DELAY_MS: 0
    depends_on:
      - controller-1
      - controller-2
      - controller-3

  broker-2:
    image: apache/kafka:4.3.1
    container_name: broker-2
    ports:
      - 39092:9092
    environment:
      KAFKA_NODE_ID: 5
      KAFKA_PROCESS_ROLES: broker
      KAFKA_LISTENERS: 'PLAINTEXT://:19092,PLAINTEXT_HOST://0.0.0.0:9092'
      KAFKA_ADVERTISED_LISTENERS: 'PLAINTEXT://broker-2:19092,PLAINTEXT_HOST://192.168.10.3:39092'
      KAFKA_INTER_BROKER_LISTENER_NAME: PLAINTEXT
      KAFKA_CONTROLLER_LISTENER_NAMES: CONTROLLER
      KAFKA_LISTENER_SECURITY_PROTOCOL_MAP: CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT,PLAINTEXT_HOST:PLAINTEXT
      KAFKA_CONTROLLER_QUORUM_VOTERS: 1@controller-1:9093,2@controller-2:9093,3@controller-3:9093
      KAFKA_GROUP_INITIAL_REBALANCE_DELAY_MS: 0
    depends_on:
      - controller-1
      - controller-2
      - controller-3

  broker-3:
    image: apache/kafka:4.3.1
    container_name: broker-3
    ports:
      - 49092:9092
    environment:
      KAFKA_NODE_ID: 6
      KAFKA_PROCESS_ROLES: broker
      KAFKA_LISTENERS: 'PLAINTEXT://:19092,PLAINTEXT_HOST://0.0.0.0:9092'
      KAFKA_ADVERTISED_LISTENERS: 'PLAINTEXT://broker-3:19092,PLAINTEXT_HOST://192.168.10.3:49092'
      KAFKA_INTER_BROKER_LISTENER_NAME: PLAINTEXT
      KAFKA_CONTROLLER_LISTENER_NAMES: CONTROLLER
      KAFKA_LISTENER_SECURITY_PROTOCOL_MAP: CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT,PLAINTEXT_HOST:PLAINTEXT
      KAFKA_CONTROLLER_QUORUM_VOTERS: 1@controller-1:9093,2@controller-2:9093,3@controller-3:9093
      KAFKA_GROUP_INITIAL_REBALANCE_DELAY_MS: 0
    depends_on:
      - controller-1
      - controller-2
      - controller-3
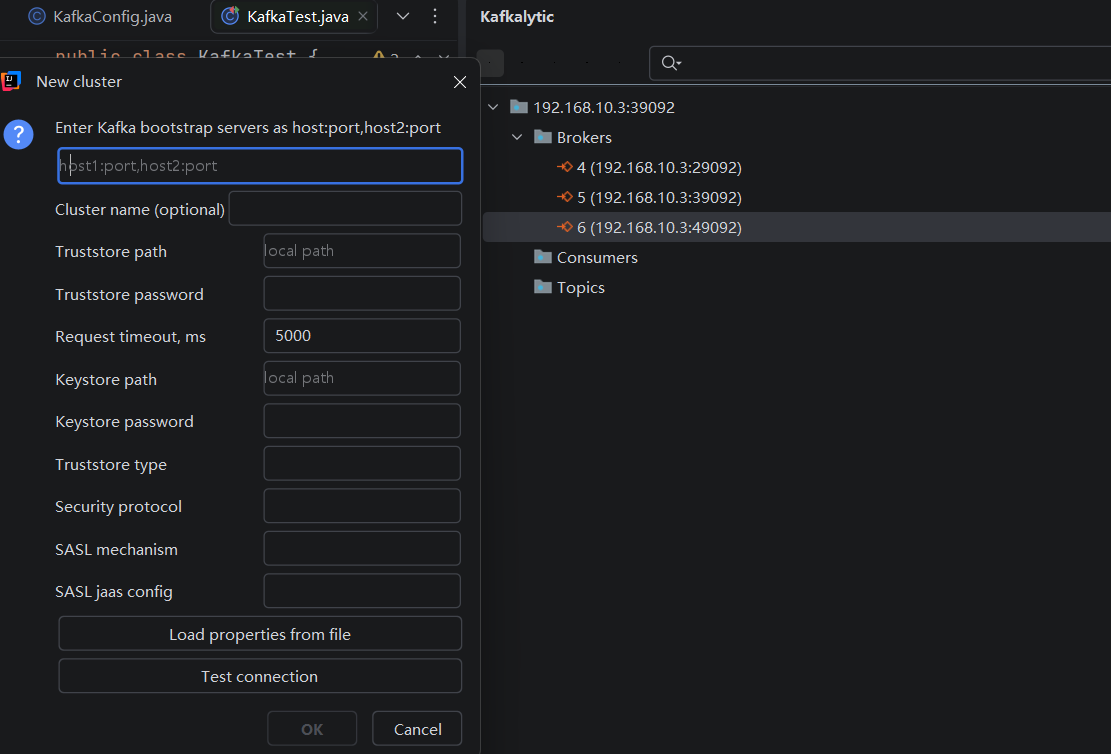
安装 Kafkalytic 插件,连接 Kafka
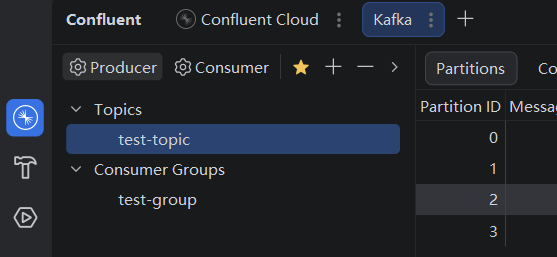
或安装 Confluent 插件
Kafka 简单收发消息
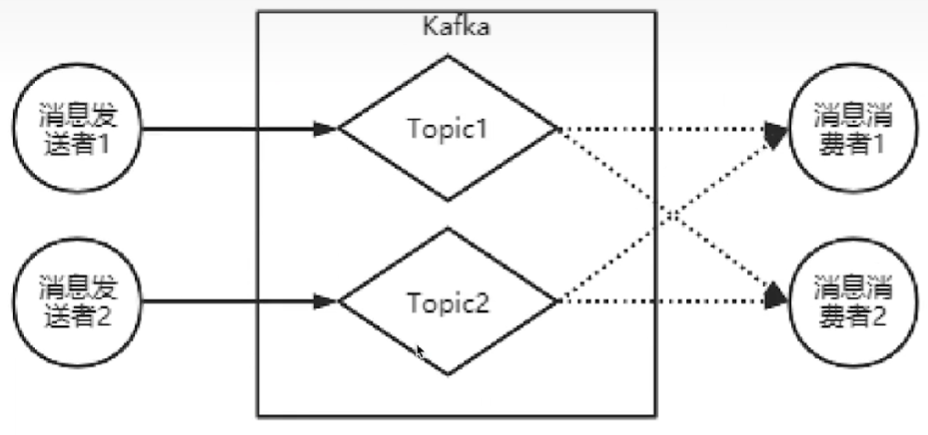
Kafka 的基础工作机制是消息发送者可以将消息发送到 kafka 上指定的 topic,而消息消费者,可以从指定的 topic 上消费消息。
创建 topic bin/kafka-topics.sh --bootstrap-server localhost:9092 --create --topic test
查看 topics bin/kafka-topics.sh --bootstrap-server localhost:9092 --list
生产对应 topic 的消息 bin/kafka-console-producer.sh --bootstrap-server localhost:9092 --topic test
消费对应 topic 的消息 bin/kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic test
- 从头消费
--from-beginning - 指定消费者组
--group group1,消息会发送到不同的消费组,但每个消费组里只有一个消费成员能获取数据。
查看消费组 bin/kafka-consumer-groups.sh --bootstrap-server localhost:9092 --list
查看消费组详情 bin/kafka-consumer-groups.sh --bootstrap-server localhost:9092 --describe --group test
Kafka 基本概念
生产者和消费者
与一般消息中间件的生产者和消费者概念相似
消息和批次
消息,Kafka 里的数据单元,也就是我们一般消息中间件里的消息的概念(可以比作数据库中一条记录)。消息由字节数组组成。消息还可以包含键(可选元数据,也是字节数组),主要用于对消息选取分区。
作为一个高效的消息系统,为了提高效率,消息可以被 分批写入 Kafka。批次就是一组消息,这些消息属于同一个主题和分区。如果只传递单个消息,会导致大量的网络开销,把消息分成批次传输可以减少这开销。但是,这个需要权衡(时间延迟和吞吐量之间),批次里包含的消息越多,单位时间内处理的消息就越多,单个消息的传输时间就越长(吞吐量高延时也高)。如果进行压缩,可以提升数据的传输和存储能力,但需要更多的计算处理。
对于 Kafka 来说,消息是晦涩难懂的字节数组,一般我们使用 序列化和反序列化技术,格式常用的有 JSON 和 XML,还有 AYIo(Hadoop 开发的款序列化框架),具体怎么使用依据自身的业务来定。
主题和分区
Kafka 里的消息用 主题进行分类(主题好比数据库中的表):主题下有可以被分为若十个分区(分表技术)。分区本质上是个提交日志文件,有新消息,这个消息就会以追加的方式写入分区(写文件的形式),然后用先入后出的顺序读取。
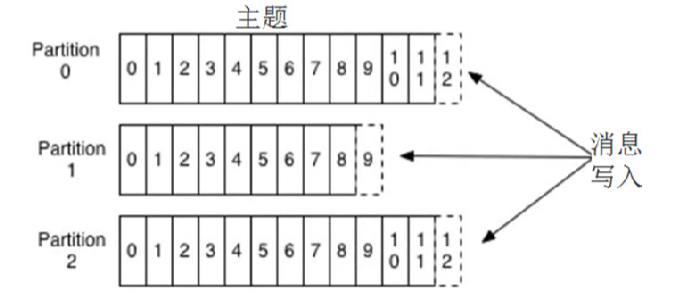
但是因为主题会有多个分区,所以在整个主题的范国内,是无法保证消息的顺序的,单个分区则可以保证。
Kafka 通过分区来实现伸缩性,因为分区可以分布在不同的服务器上,那就是说一个主题可以跨越多个服务器(这是 Kalka 高性能的一个原因,多台服务器的磁盘读写性能比单台更高)。
Kafka 通过分区来实现数据冗余,因为分区在多个服务器之间可以发生分区复制。一旦主服务器失效,其他服务器可以接管领导权。当然相关的消费者和生产者都要重新连接到新的首领上。
前面我们说 Kafka 可以看成一个流平台,很多时候,我们会把一个主题的数据看成一个流,不管有多少个分区。
Kafka 集群
为什么需要集群
单机服务下,Kafka 已经具备了非常高的性能。TPS 能够达到百万级别。但是,在实际工作中使用时,单机搭建的 Kafka 会有很大的局限性。
一方面,消息太多,需要分开保存。Kafka 是面向海量消息设计的,一个 Topic 下的消息会非常多,单机服务很难存得下来。这些消息就需要分成不同的 Partition,分布到多个不同的 Broker 上。这样每个 Broker 就只需要保存一部分数据。这些分区的个数就称为分区数。
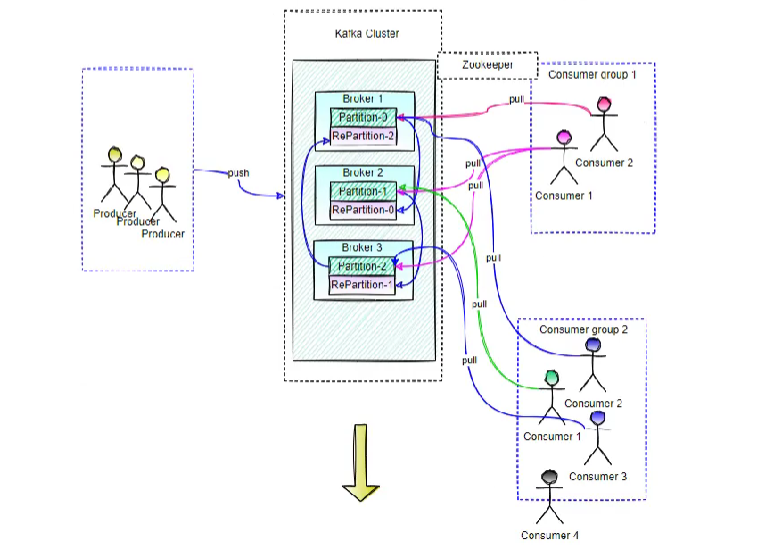
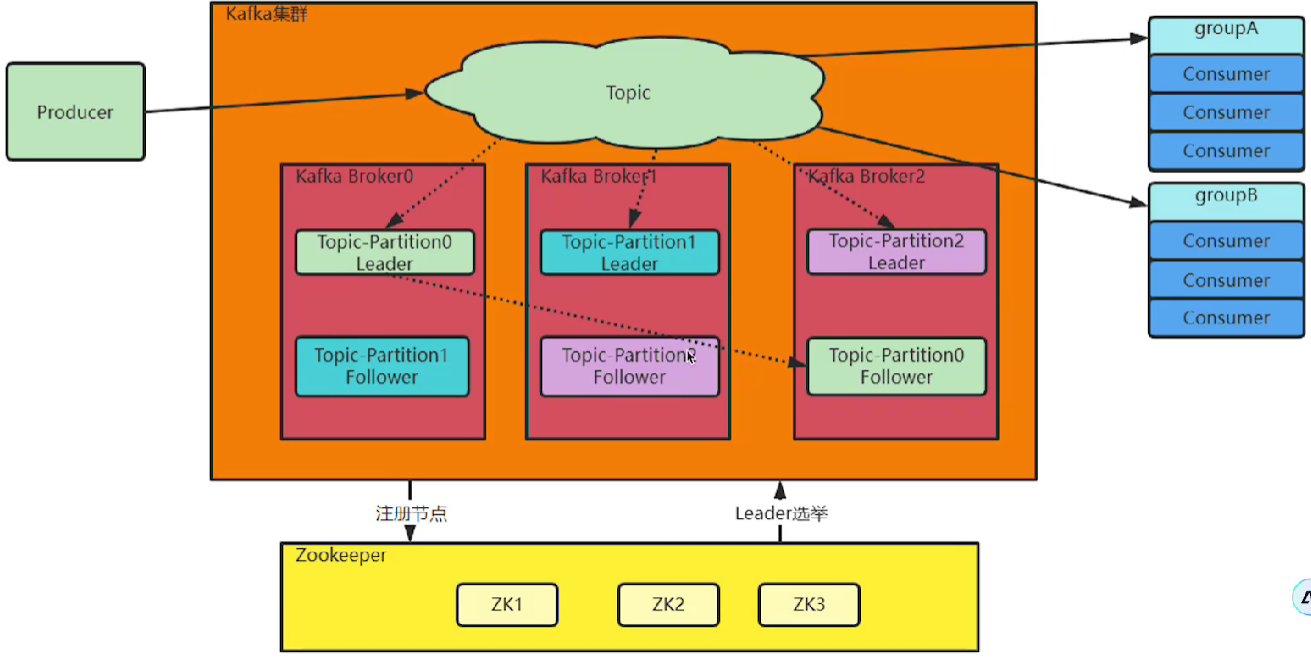
另一方面,服务不稳定,数据容易丢失。单机服务下,如果服务崩溃,数据就丢失了。为了保证数据安全,就需要给每个 Partition 配置一个或多个备份,保证数据不丢失。Kafka 的集群模式下,每个 Partition 都有一个或多个备份。Kafka 会通过一个统一的 Zookeeper 集群作为选举中心,给每个 Partition 选举出一个主节点 Leader,其他节点就是从节点 Follower。主节点负责响应客户端的貝体业务请求,并保存消息。而从节点则负责同步主节点的数据。当主节点发生故障时,Kaka 会选举出一个从节点成为新的主节点。
最后,Kafka 集群中的这些 Broker 信息,包括 Partition 的选举信息,都会保存在额外部署的 Zookeeper 集群当中,这样,kafka 集群就不会因为某一些 Broker 服务崩溃而中断。
Broker 和集群
一个独立的 Kafka 服务器叫 Broker。broker 的主要工作是,接收生产者的消息,设置偏移量,提交消息到磁盘保存;为消费者提供服务,响应请求,返回消息。在合适的硬件上,单个 broker 可以处理上千个分区和每秒百万级的消息量。(要达到这个目的需要做操作系统调优和 JVM 调优)
多个 broker 可以组成一个集群。 每个集群中 broker 会选举出一个集群控制器。控制器会进行管埋,包括将分区分配给 broker 和监控 broker。
集群里,一个分区从属于一个 broker,这个 broker 被称为首领。但是分区可以被分配给多个 broker,这个时候会发生分区复制。集群中 Kafka 内部一般使用管道技术进行高效的复制。
示例,3 个 Broker 的 kafka 集群模式,创建一个 Topic(3 个 Partition, 3 个 Replicatlon) 数据流程图。
集群协调的方式
在 Kfaka 集群中,没有内建一套通用共识协议来管理集群的元数据,还需要一个“控制面”进行元数据协调,决定集群里谁管什么、谁是 controller、分区 leader 是谁...
- ZooKeeper 模式:每个 broker 都连 ZK,其中一个 broker 被选为 controller,controller 通过 ZK 管理元数据并指挥其他 broker。
- KRaft 模式:一组 controller 节点组成 Raft quorum,active controller 管理元数据;broker 向 controller 注册、心跳、拉取元数据。controller 和 broker 可以是不同节点,也可以同一节点同时承担两种角色。
Kafka 4.0.0 彻底移除 Zookeeper ,完全基于 KRaft 模式运行,无法再与 ZooKeeper 一起部署。
Zookeeper
ZooKeeper 是一个分布式的,开放源码的分布式应用程序协调服务,是 Google 的 Chubby 一个开源的实现,是 Hadoop 和 Hbase 的重要组件。它是一个为分布式应用提供一致性服务的软件,提供的功能包括:配置维护、域名服务、分布式同步、组服务等。
Zookeeper 从设计模式的角度来理解工作机制:是一个基于观察者模式的分布式服务管理框架,它负责存储和管理重要的数据,然后接受观察者的注册,一旦这些被观察的数据状态发生变化,Zookeeper 就负责通知已经在 Zookeeper 上注册的那些观察者让他们做出相应的反应。
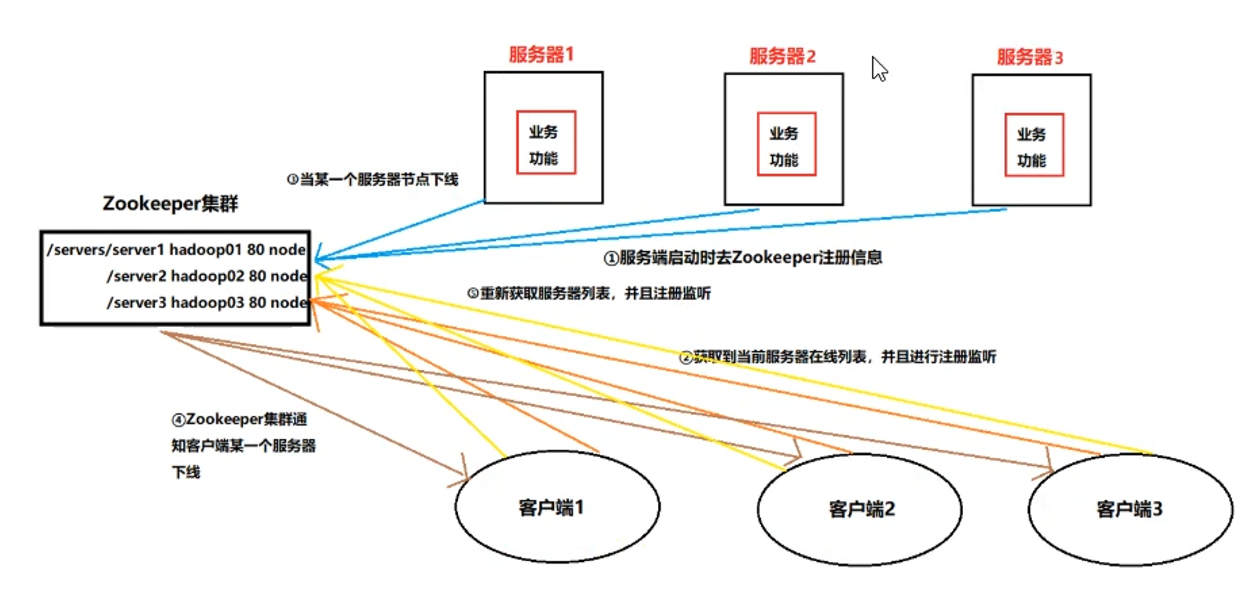
这里就不讲 zookeeper 的特点以及内部的 leader 选举。
在 Kafka 的 leader 选举:
Kraft
集群实战
准备三台同样的 linux 服务器,预装 jdk
分别配置机器名 worker1.worker2.workeī3
/i /etc/hosts
192.168.232.128 worker1
192.168.232.129 worker2
192.168.232.130 worker3
部署 Zookeeper 集群,这里采用之前单独下载的 Zookeeper 来部署集群。Zookeeper 是一种多数同意的选举机制,允许集群中少半数节点出现故障。因此,在搭建集群时,通常采用奇数节点,这样可以最大化集群的高可用特性。在后续的实现过程中,我们会在三台服务器上都部署 Zookeeper。
创建 zoo.cfg
#Zookeeper的本地数据目录,默认是/tmp/zookeeper。这是Linux的临时目录,随时会被删掉。dataDir=/app/zookeeper/data
#Zookeeper的服务端口
clientPort=2181
#集群节点配置
server.1=192.168.232.128:2888:3888
server.2=192.168.232.129:2888:3888
server.3=192.168.232.130:2888:3888
其中,clientPort 2181 是对客户端开放的服务端口。
集群配置部分,server.x 这个 x 就是节点在集群中的 myid。后面的 2888 端口是集群内部数据传输使用的端口。3888 是集群内部进行选举使用的端口。
每台服务器都需要构建对应的 myid 文件并启动 zookeeper
cd /opt/zookeeper/data
echo 1 > myid
bin/zkServer.sh --config conf start
echo 2 > myid
bin/zkServer.sh --config conf start
echo 3 > myid
bin/zkServer.sh --config conf start
部署 Kafka 集群
每台服务器修改 server.properties
#broker的全局唯一编号,不能重复,只能是数字。broker.id=1 broker.id=2 broker.id=3
#服务监听地址
listeners=PLAINTEXT://worker1:9092
#数据文件地址。同样默认是给的/tmp目录。
log.dirs=/app/kafka/logs
#默认的每个Topic的分区数
num.partitions=1
#zookeeper的服务地址 默认是软件包内置的 zookeeper localhost:2181 改为自部署的zookeeper
zookeeper.connect=worker1:2181,worker2:2181,worker2:2181
#可以选择指定zookeeper上的基础节点。
#zookeeper.connect=worker1:2181,worker2:2181,worker3:2181/kafka
启动 Kafka(后台启动)
bin/kafka-server-start.sh -daemon config/server-properties创建四个分区的主题,需要有两个副本
bin/kafka-topics.sh --bootstrap-server worker1:9092 --create --replication-factor 2 --partitions 4 --topic disTopic每个 partition 都会随机均匀分发到集群中的 2 个 Broker 节点,选出一台领导节点
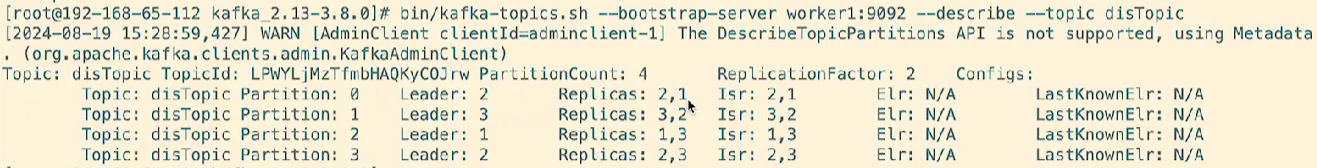
从整个过程可以看到,Kafka 当中,Topic 是一个数据集合的逻辑单元。同一个 Topic 下的数据,实际上是存储在 Partition 分区中的,Partition 就是数据存储的物理单元。而 Broker 是 Partition 的物理载体,这些 Partition 分区会尽量均匀的分配到不同的 Broker 机器上。而之前接触到的 offset,就是每个消息在 partition 上的偏移量。
在 Topic 上写消息,消息也会尽量均匀的分配(数据体量小则采取粘性策略)到不同的 Patition
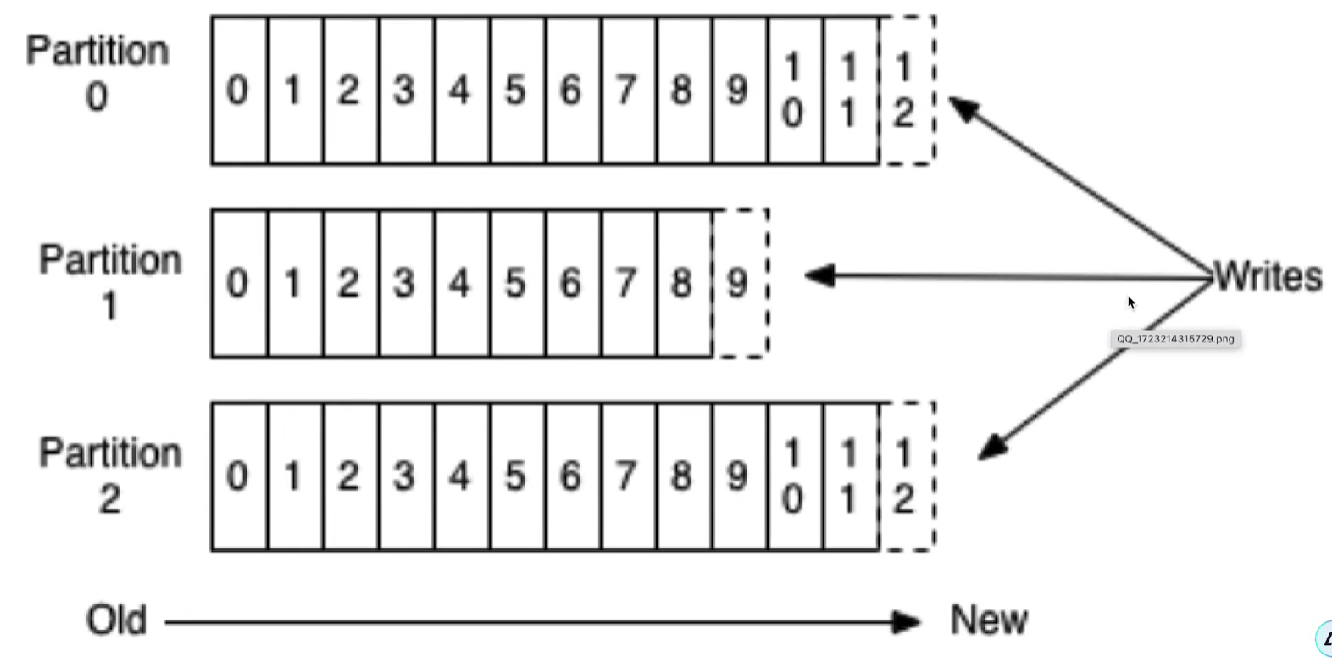
为什么要 Partition
- Kafka 设计需要支持海量的数据,而这样庞大的数据量,一个 Broker 是存不下的。那就拆分成多个 Partition,每个 Broker 只存一部分数据。这样极大的扩展了集群的 吞吐量。
- 每个 Partition 保留了一部分的消息副本,如果放到一个 Broker 上,就容易出现单点故障。所以就给每个 Partition 设计 Follower 节点,进行数据备份,从而保证 数据安全。另外,多备份的 Partition 设计也提高了读取消息时的并发度。
- 在同一个 Topic 的多个 Partition 中,会产生一个 Partition 作为 Leader。这个 LeaderPartition 会负责响应客户端的请求,并将数据往其他 Partition 分发同步。
Kafka 集群的消息流转模型
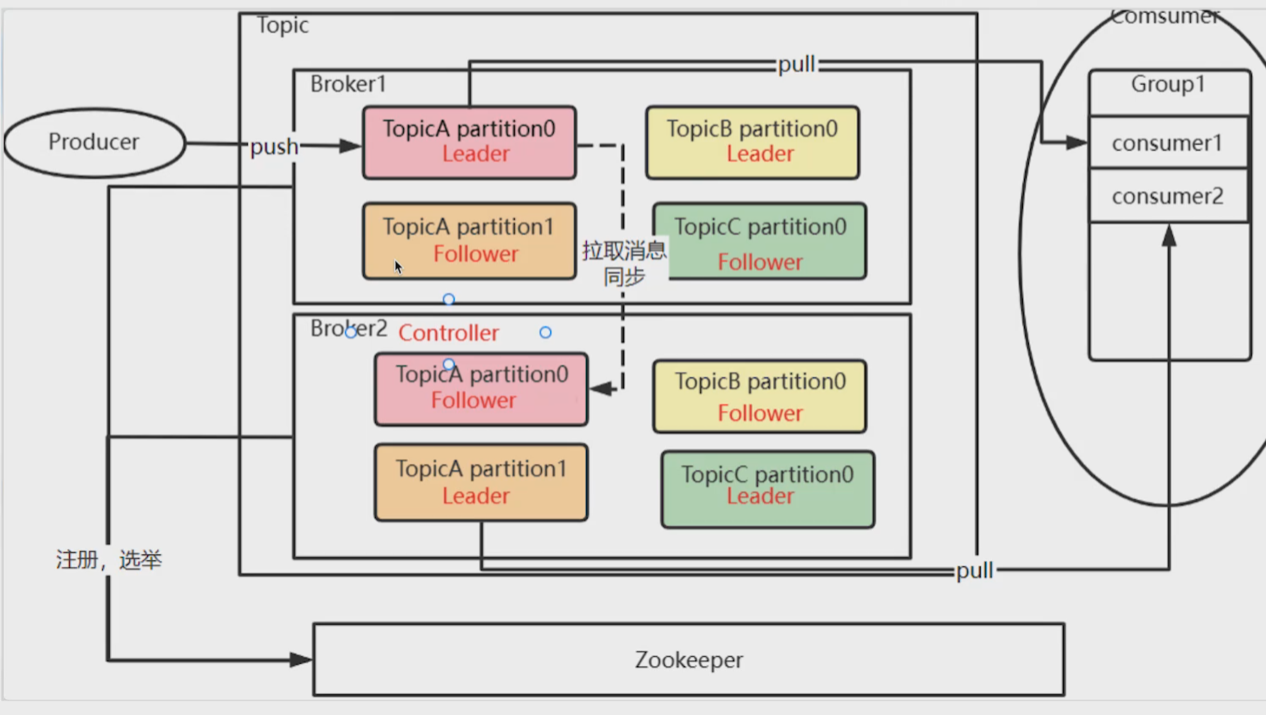
Kafka 的 Leader 选举过程
Kafka 客户端
Kafka Java 客户端
Kafka 提供了两套客户端 API, HighLevel API 和 LowLevel API。
- HighLevelAPI 封装了 kafka 的运行细节,使用起来比较简单,是企业开发过程中最常用的客户端 API。
- LowLevelAPI 则需要客户端自己管理 Kafka 的运行细节,Partition,Offset 这些数据都由客户端自行管理。这层 API 功能更灵活,但是使用起来非常复杂,也更容易出错。只在极少数对性能要求非常极致的场景才会偶尔使用。
引入依赖
<dependency>
    <groupId>org.apache.kafka</groupId>
    <artifactId>kafka-clients</artifactId>
    <version>4.3.1</version>
</dependency>
生产者发送消息
定义生产者
@Configuration
public class KafkaConfig {

    public static final String BOOTSTRAP_SERVERS = "192.168.10.3:39092";

    @Bean
    public KafkaProducer<String, String> kafkaProducer() {
        Properties props = new Properties();
        // 配置 Kafka 服务器地址
        props.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, BOOTSTRAP_SERVERS);
        // 配置拦截器
        //        props.put(ProducerConfig.INTERCEPTOR_CLASSES_CONFIG, "'com.roy.kfk.basic.MyInterceptor");
        // key 的序列化类
        props.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringSerializer");
        // value 的序列化类
        props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringSerializer");

        return new KafkaProducer<>(props);
    }
}
测试发送,
发送方式:
- 单向发送,客户端不关心服务端的应答。
- 同步发送,获取服务端应答消息前,会阻塞当前线程。
- 异步发送,消息发送后不阻塞,服务端有应答后会触发回调函数
@SpringBootTest
public class KafkaTest {

    @Autowired
    private KafkaProducer<String, String> kafkaProducer;

    private String TOPIC = "test-topic";


    @Test
    public void testKafkaProducer() throws ExecutionException, InterruptedException {
        for (int i = 0; i < 1000; i++) {
            ProducerRecord<String, String> record = new ProducerRecord<>(TOPIC, "key" + i, "value" + i);
            // 单向发送
            //            kafkaProducer.send(record);
            // 同步发送
            RecordMetadata recordMetadata = kafkaProducer.send(record).get();
            String topic = recordMetadata.topic();
            int partition = recordMetadata.partition();
            long offset = recordMetadata.offset();
            String message = recordMetadata.toString();
            System.out.println("message:" + message + ", topic:" + topic + ", partition:" + partition + ", offset:" + offset);
            // 异步发送
            //            kafkaProducer.send(record, (RecordMetadata metadata, Exception exception) -> {
            //                System.out.println("message:" + metadata.toString() + ", topic:" + metadata.topic() + ", partition:" + metadata.partition() + ", offset:" + metadata.offset());
            //                System.out.println("exception:" + exception);
            //            });
            // 可以做一些其他的事情
            //            Thread.sleep(1000);
        }
    }
}
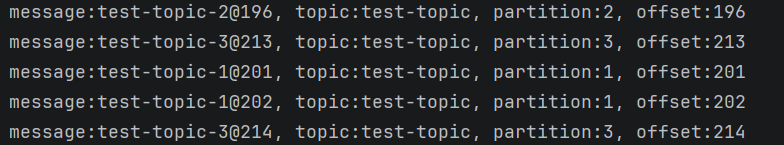
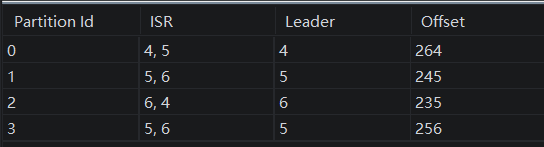
效果:同步发送消息后,得到消息的处理结果,消息均匀的分布在四个分区中。
消费者接受消息
定义消费者,订阅对应主题
@Bean
    public KafkaConsumer<String, String> kafkaConsumer() {
        Properties props = new Properties();
        props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, BOOTSTRAP_SERVERS);
        // 每个消费者都要指定一个组ID
        props.put(ConsumerConfig.GROUP_ID_CONFIG, "test-group");
        // 禁用自动提交
        props.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, false);
        // key 的反序列化类
        props.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringDeserializer");
        // value 的反序列化类
        props.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringDeserializer");
        KafkaConsumer<String, String> kafkaConsumer = new KafkaConsumer<>(props);
        return kafkaConsumer;
    }
消费者监听主题
@Test
public void testKafkaConsumer() {
    kafkaConsumer.subscribe(Collections.singleton(TOPIC));
    while (true) {
        // 超时一百纳秒
        ConsumerRecords<String, String> records = kafkaConsumer.poll(Duration.ofNanos(100));
        // 处理消息
        for (ConsumerRecord<String, String> record : records) {
            System.out.println("offset:" + record.offset() + ", key:" + record.key() + ", value:" + record.value());
        }
        // 提交 offset,消息就不会会重复推送。
        kafkaConsumer.commitSync();
        //异步提交,表示发送完提交offset请求后,就开始消费下一批数据了。不用等到Broker的确认。
        //            kafkaConsumer.commitAsync();
    }
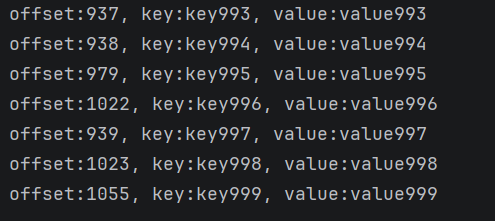
}
配置客户端属性
Properties produceProps = new Properties();
produceProps.set("","")
new KafkaProducer<>(produceProps);
Properties consumerProps = new Properties();
consumerProps.set("","")
new KafkaConsumer<>(consumerProps);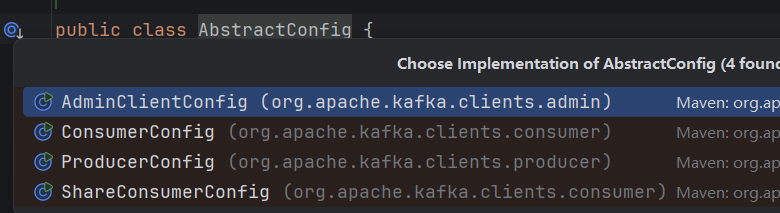
消费者分组机制
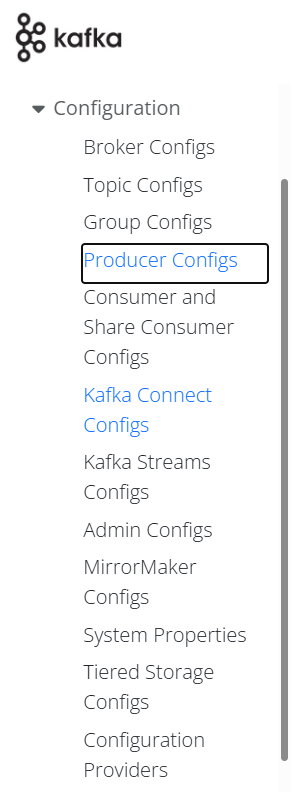
ConsumerConfig.GROUP_ID_CONFIG:表示当前 Consurer 所属的消费者组。消费者使用subscribe的组管理功能或者基于 Kafka 的偏移管理策略,则需要此属性。ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG:如果未开启,且没有手动提交偏移,则服务端的偏移不会更新,下次还会继续消费这些数据。ConsumerConfig.GROUP_INSTANCE_ID_CONFIG:可以给组成员设置一个固定的 instanceld,这个参数通常可以用来减少 Kafka 不必要的 rebalance。
生产者往 Topic 下发消息时,会尽量均匀的将消息发送到 Topic 下的各个 Partition 当中。而这个消息,会向所有订阅了该 Topic 的消费者推送。推送时,每个 ConsumerGroup 中只会推送一份。也就是同一个消费者组中的多个消费者实例,只会共同消费一个消息副本。而不同消费者组之间,会重复消费消息副本。这就是消费者组的作用。
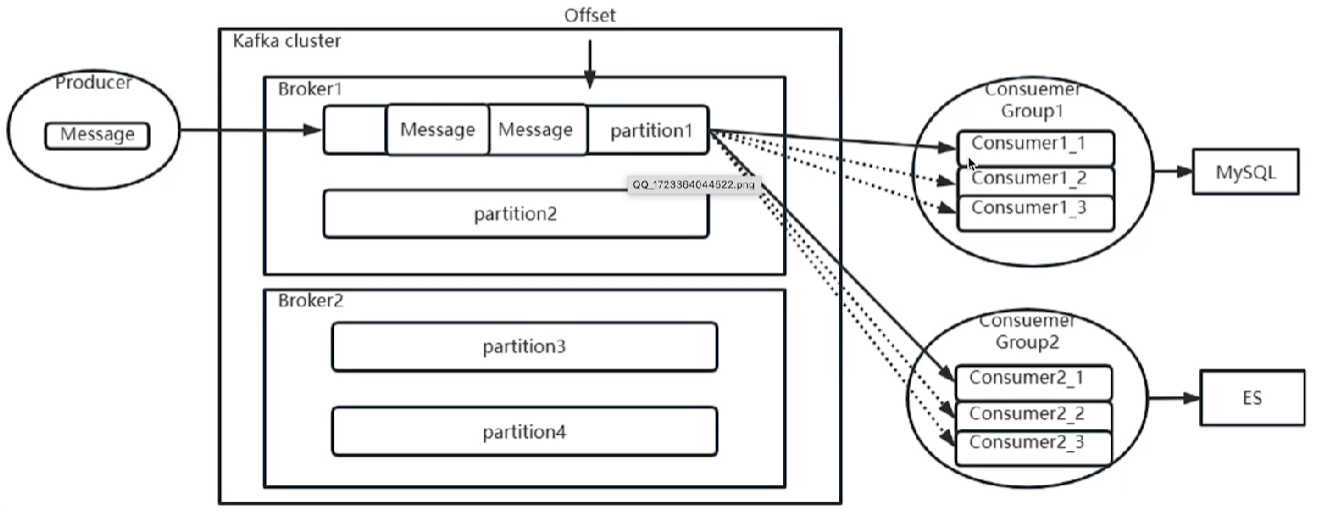
当一个消费者启动时,它会尝试加入一个消费者组。当消费者知道自己负责哪些分区后,就会周期性地调用 consumer.poll() 方法来拉取消息。拉取到 ConsumerRecords 后,消费者会遍历这些记录,对每条消息进行业务逻辑处理。 ConsumerRecord 包含了消息的所有元数据。
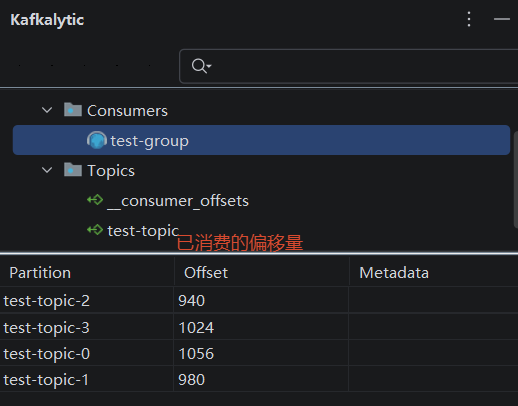
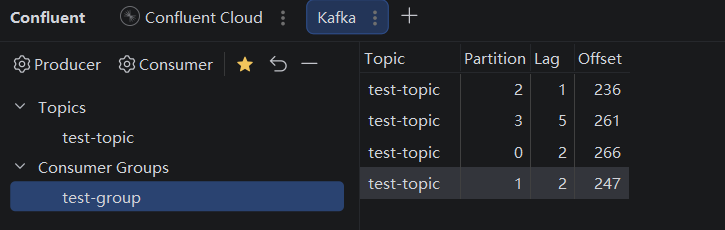
与之相关的还有 Offset 偏移量。这个偏移量表示每个消费者组在每个 Partiton 中已经消费处理的进度。在 Kafka 中,可以看到消费者组的 Offset 记录情况。
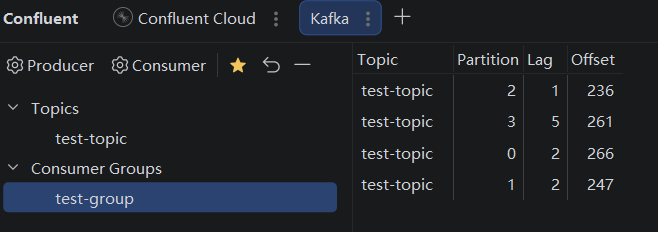
处理完消息后,消费者需要将它已经消费到的 Offset 提交给 Kafka,以便下次启动或发生重平衡时,能够从正确的位置继续消费。Offset 通常提交到 Kafka 内部的一个特殊主题 __consumer_offsets。
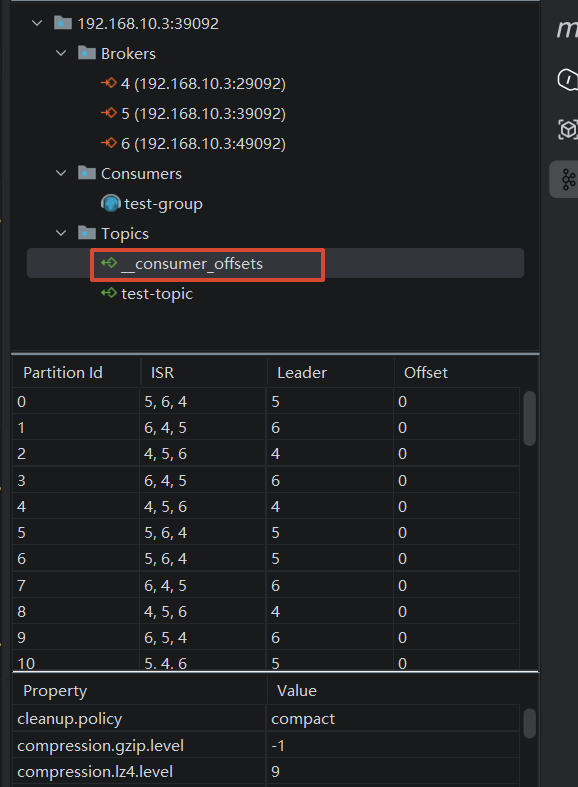
如果未开启偏移自动提交,且没有手动提交偏移,则服务端的偏移不会更新,下次还会继续消费这些数据。
@Test
    public void testKafkaConsumer() {
        kafkaConsumer.subscribe(Collections.singleton(TOPIC));
        while (true) {
            ConsumerRecords<String, String> records = kafkaConsumer.poll(Duration.ofNanos(100));
            // 处理消息
            for (ConsumerRecord<String, String> record : records) {
                System.out.println("offset:" + record.offset() + ", key:" + record.key() + ", value:" + record.value());
            }
        }
    }
效果:始终存在 Lag 10 条数据。
完整的消费者实践
public class AdvancedKafkaConsumer {

        try {
            consumer.subscribe(Collections.singletonList(TOPIC_NAME), new ConsumerRebalanceListener() {
                @Override
                public void onPartitionsRevoked(Collection<TopicPartition> partitions) {
                    // 在分区被撤销之前,同步提交当前已处理的消息的Offset
                    System.out.println("--- 重平衡:分区被撤销 ---");
                    for (TopicPartition partition : partitions) {
                        System.out.println("即将撤销分区: " + partition + ", 准备提交Offset: " + currentOffsets.get(partition));
                    }
                    if (!currentOffsets.isEmpty()) {
                        consumer.commitSync(currentOffsets); // 确保在失去分区所有权前提交
                        currentOffsets.clear(); // 清空已提交的Offset
                    }
                }

                @Override
                public void onPartitionsAssigned(Collection<TopicPartition> partitions) {
                    // 分区被分配后,可以从特定Offset开始消费
                    System.out.println("--- 重平衡:分区被分配 ---");
                    for (TopicPartition partition : partitions) {
                        System.out.println("新分配分区: " + partition + ", 从上次提交的Offset开始消费");
                        // 示例:可以从某个特定Offset开始消费,例如从0开始
                        // consumer.seek(partition, 0);
                    }
                }
            });

            System.out.println("消费者已启动,等待消息...");

            while (true) {
                ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(100)); // 短暂轮询
                if (!records.isEmpty()) {
                    for (ConsumerRecord<String, String> record : records) {
                        System.out.printf("从分区 %d, 偏移量 %d 接收消息: Key=%s, Value=%s%n",
                                record.partition(), record.offset(), record.key(), record.value());
                        // 模拟消息处理
                        // Thread.sleep(10);

                        // 记录当前处理到的下一个Offset (即 record.offset() + 1)
                        currentOffsets.put(
                            new TopicPartition(record.topic(), record.partition()),
                            new OffsetAndMetadata(record.offset() + 1)
                        );
                    }
                    // 批次处理完成后,异步提交所有分区的Offset
                    consumer.commitAsync(currentOffsets, (offsets, exception) -> {
                        if (exception != null) {
                            System.err.println("异步提交Offset失败: " + exception);
                        } else {
                            System.out.println("异步提交Offset成功: " + offsets);
                            currentOffsets.clear(); // 清空已提交的Offset
                        }
                    });
                }
            }
        } catch (Exception e) {
            System.err.println("消费者发生异常: " + e.getMessage());
            e.printStackTrace();
        } finally {
            consumer.close(); // 确保关闭消费者
            System.out.println("消费者已关闭。");
        }
    }
}
生产者拦截机制
ProducerConfig.INTERCEPTOR_CLASSES_CONFIG指定拦截器类
定义拦截器
public class KafkaInterceptor implements ProducerInterceptor {
    @Override
    // 发送记录到服务器之前触发
    public ProducerRecord onSend(ProducerRecord record) {
        System.out.println("Intercepting record: " + record);
        return record;
    }

    // 收到服务器响应后触发
    @Override
    public void onAcknowledgement(RecordMetadata metadata, Exception exception) {
        System.out.println("Acknowledgement received for record: " + metadata + " with exception: " + exception);
    }

    // 生产者连接关闭时触发
    @Override
    public void close() {
        System.out.println("Producer Closed");
    }

    // 整理配置项
    @Override
    public void configure(Map<String, ?> configs) {
        System.out.println("=================== config start =======================");
        System.out.println("Configuring interceptor with configs: " + configs);
        System.out.println("=================== config end =======================");
    }
}
生产者配置属性
props.put(ProducerConfig.INTERCEPTOR_CLASSES_CONFIG, "com.example.javademo.middleware.kafka.KafkaInterceptor");消息序列化机制
ProducerConfig.KEY_SERIALIZER_CLASS_CONFIGProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG
这两个参数,可以指定消息生产者如何将消息的 key 和 value 序列化成二进制数据。
ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIGConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG
消费者拉取消息时,自然需要进行反序列化。
在 org.apache.kafka.common.serialization 提供了 字符串的序列化和反序列化类,如果是特殊的类型则需要自定义序列化类。
在自定义序列化机制时,需要考虑的是如何用二进制来描述业务数据。例如对于一个通常的 POJ 类型,可以将他的属性拆分成两种类型: 一种类型是定长的基础类型,比如 Integer, Long, Double 等。这些基础类型转化成二进制数组都是定长的。这类属性可以直接转成序列化数组,在反序列化时,只要按照定长去读取二进制数据就可以反序列化了。另一种是不定长的浮动类型,比如 String,或者基于 String 的 JSON 类型等。这种浮动类型的基础数据转化成二进制数组,长度都是不一定的。对于这类数据,通常的处理方式都是先往二进制数组中写入一个定长的数据的长度数据(Integer 或者 Long 类型),然后再继续写入数据本身。这样,反序列化时,就可以先读取一个定长的长度,再按照这个长度去读取对应长度的二进制数据,这样就能读取到数据的完整二进制内容。
序列化类
public class UserSerializer implements Serializer<User> {

    @Override
    public byte[] serialize(String topic, User data) {
        // 简单粗暴的序列化
//        return JSON.toJSONString(data).getBytes(StandardCharsets.UTF_8);
        // 更高效率更节省空间的序列化
        byte[] nameBytes = data.getName().getBytes(StandardCharsets.UTF_8);
        // id: long 8byte + age: int 4byte + name的长度: int 4byte + name:string 不定长
        int cap = 8 + 4 + 4 + nameBytes.length;
        ByteBuffer buffer = ByteBuffer.allocate(cap);
        buffer.putLong(data.getId());
        buffer.putInt(data.getAge());
        buffer.putInt(nameBytes.length);
        buffer.put(nameBytes);

        return buffer.array();
    }
}
反序列化类
public class UserDeserializer implements Deserializer<User> {
    @Override
    public User deserialize(String topic, byte[] data) {
        // 简单粗暴的反序列化
//        return JSON.parseObject(data, User.class);
        // 更高效率更节省空间的序列化
        ByteBuffer dataBuffer = ByteBuffer.allocate(data.length);
        dataBuffer.put(data);
        dataBuffer.flip();
        long id = dataBuffer.getLong();
        int age = dataBuffer.getInt();
        int nameLength = dataBuffer.getInt();
        byte[] nameBytes = dataBuffer.get(data, 16, nameLength).array();
        String name = new String(nameBytes, StandardCharsets.UTF_8).trim();

        return new User(id, name, age);
    }
}
定义生产者和消费者进行测试
@Test
    public void testSerializer() throws ExecutionException, InterruptedException {
        Properties props = new Properties();
        // 配置 Kafka 服务器地址
        props.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, BOOTSTRAP_SERVERS);
        // 配置拦截器
//        props.put(ProducerConfig.INTERCEPTOR_CLASSES_CONFIG, "com.example.javademo.middleware.kafka.interceptor.KafkaInterceptor");
        // key 的序列化类
        props.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringSerializer");
        // value 的序列化类
        props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, "com.example.javademo.middleware.kafka.serialization.UserSerializer");

        KafkaProducer<String, User> userProducer = new KafkaProducer<>(props);

        for (int i = 0; i < 10; i++) {
            User user = new User(i + 1L, "zhangsan", 18 + i);
            ProducerRecord<String, User> record = new ProducerRecord<>(TEST_SERIALIZATION_TOPIC, "user" + i + 1, user);
            // 同步发送
            RecordMetadata recordMetadata = userProducer.send(record).get();
            String topic = recordMetadata.topic();
            int partition = recordMetadata.partition();
            long offset = recordMetadata.offset();
            String message = recordMetadata.toString();
            System.out.println("message:" + message + ", topic:" + topic + ", partition:" + partition + ", offset:" + offset);
        }
    }

    @Test
    public void testDeserializer() {
        Properties props = new Properties();
        // 配置 Kafka 服务器地址
        props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, BOOTSTRAP_SERVERS);
        // 每个消费者都要指定一个组ID
        props.put(ConsumerConfig.GROUP_ID_CONFIG, "test-serialization-group");
        // 禁用自动提交
        props.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, false);
        // key 的反序列化类
        props.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringDeserializer");
        // value 的反序列化类
        props.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, "com.example.javademo.middleware.kafka.serialization.UserDeserializer");

        KafkaConsumer<String, User> userConsumer = new KafkaConsumer<>(props);
        userConsumer.subscribe(Collections.singleton(TEST_SERIALIZATION_TOPIC));
        while (true) {
            ConsumerRecords<String, User> records = userConsumer.poll(Duration.ofNanos(100));
            // 处理消息
            for (ConsumerRecord<String, User> record : records) {
                System.out.println("offset:" + record.offset() + ", key:" + record.key() + ", value:" + record.value());
            }
            // 提交 offset,消息就不会会重复推送。
            userConsumer.commitSync();
            //异步提交,表示发送完提交offset请求后,就开始消费下一批数据了。不用等到Broker的确认。
//            userConsumer.commitAsync();
        }
    }
为什么不直接使用 JSON 的方式序列化和反序列化?因为 JSON 更占空间,首先字段名要重复,其次数字变成了字符,结构多出了 []""{} 等符号等等问题, ASCII 字符占用 1 字节,中文通常占用 3 字节,emoji 占用 4 字节,例如 User { id = 123, name = "张三" } 转换为 JSON {"id":123,"name":"张三"},合计约 26 字节,如果换成 Protobuf 这类二进制协议总大小可能 10 字节左右。对这些字符的转换也造成了 JSON 序列化效率也低。
序列化机制是在高并发场景中非常重要的一个优化机制。高效的系列化实现能够极大的提升分布式系统的网络传输以及数据落盘的能力。例如对于一个 User 对象,即可以使用 JSON 字符串这种简单粗暴的序列化方式,也可以选择按照各个字段进行组合序列化的方式。但是显然后者的占用空间比较小,序列化速度也会比较快。而 Kafka 在文件落盘时,也设计了非常高效的数据序列化实现,这也是 Kafka 高效运行的一大支撑。
在很多其他业务场景中,也需要我们提供更高效的序列化实现。例如使用 MapReduce 框架时,就需要自行定义数据的序列化方式。使用 Netty 框架进行网络调用时,为了防止粘包,也需要定制数据的序列化机制。在这些场景下,进行序列化的基础思想,和我们这里介绍的也是一样的。当然,如果我们可以进一步设计出更简短高效的数据压缩算法,那也就能更进一步提高数据传输的效率。比如对二进制数据进行压缩。而这就是算法最直接的作用。
消息分区路由机制
消息应该发送到哪个分区?
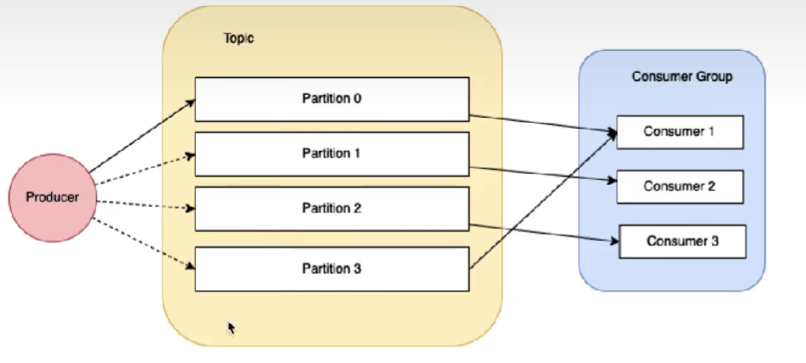
ProducerConfig.PARTITIONER_CLASS_CONFIG生产者的消息分区分配策略,确定生成记录时将记录发送到哪个分区。- 默认策略。发到同一个分区中,直到这些消息的量达到了
BATCH_SIZE_CONFIG。如果没有指定分区,则会根据 key 去分配不同分区,如果连 key 都没指定,则任意选择一个分区,粘性发送消息直到这些消息的量达到了BATCH_SIZE_CONFIG。 - 轮询策略
RoundRobinPartitioner。每次依次选择不同分区发送消息。坏处就是需要频繁切换分区操作。 - 自定义数据分区策略类。
- 默认策略。发到同一个分区中,直到这些消息的量达到了
分区上的消息应该分给哪个消费者?
ConsumerConfig.PARTITION_ASSIGNMENT_STRATEGY_CONFIG消费者的分区分配策略,确定分区上的数据分配给哪个消费者。- 范围策略
RangeAssignor。一个消费者组下有三个 Consumer。Range 策略就会将分区 0-3 分给一个 Consumer,4-6 给一个 Consumer,7-9 给一个 Consumer。 - 轮询分配策略
RoundRobinAssignor。可以理解为在 Consumer 中一个一个轮流分配分区。比如 0,3,6,9 分区给一个 Consumer,1,4,7 分区给一个 Consumer, 然后 2,5,8 给一个 Coñsumer - 默认粘性策略
StickyAssignor。在开始分区时,尽量保持分区的分配均匀。比如按照 Range 策略分(这一步实际上是随机的)。 分区的分配尽可能的与上一次分配的保持一致。比如在 range 分区的情况下,第三个 Consumer 的服务宕机了,那么按照 sticky 策略,就会保持 consumer1 和 consumer2 原有的分区分配情况。然后将 consumer3 分配的 7~9 分区尽量平均的分配到另外两个 consumer 上。这种粘性策略可以很好的保持 Consumer 的数据稳定性。 - 自定义分区分配策略类
- 范围策略
生产者消息缓存机制
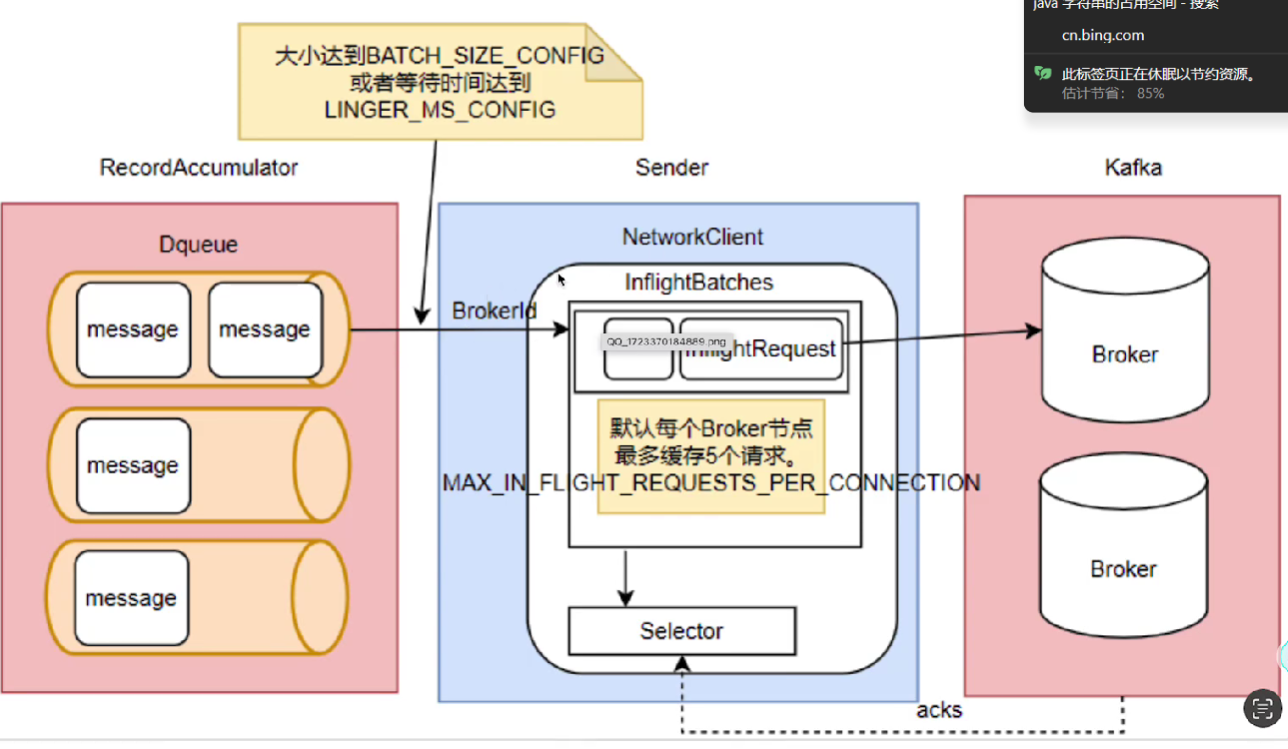
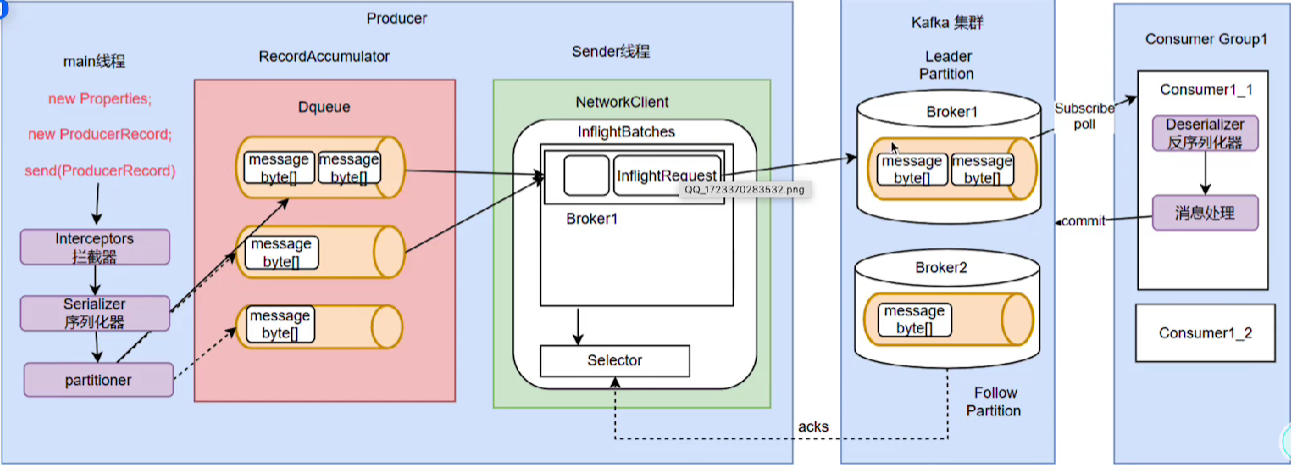
Kafka 生产者为了避免高并发请求对服务端造成过大压力,每次发消息时并不是一条一条发往服务端,而是增加了一个高速缓存,将消息集中到缓存后,批量进行发送。这种缓存机制也是高并发处理时非常常用的一种机制。
Kafka 的消息缓存机制涉及到 KafkaProducer 中的两个关键组件: accumulator 和 sender
public class KafkaProducer<K, V> implements Producer<K, V> {
    private final RecordAccumulator accumulator; // Kafka生产者的消息累加器。KafkaProducer要发送的消息都会在ReocrdAccumulator中缓存起来,然后再分批发送给kafka broker。
    private final Sender sender;
    private Future<RecordMetadata> doSend(ProducerRecord<K, V> record, Callback callback) {

    }
}
在 RecordAccumulator 中,会针对每一个 Partition,维护一个 Degue 双端队列,这些 Dequeue 队列基本上是和 Kafka 服务端的 Topic 下的 Partition 对应的。每个 Dequeue 里会放入若干个 ProducerBatch 数据。KafkaProducer 每次发送的消息,都会根据 key 分配到对应的 Deque 队列中。然后每个消息都会保存在这些队列中的某一个 ProducerBatch 中。而消息分发的规则,就是由上面的 Partitioner 组件完成的。
ProducerConfig.BUFFER_MEMORY_CONFIG累积器默认消息缓存最大的大小
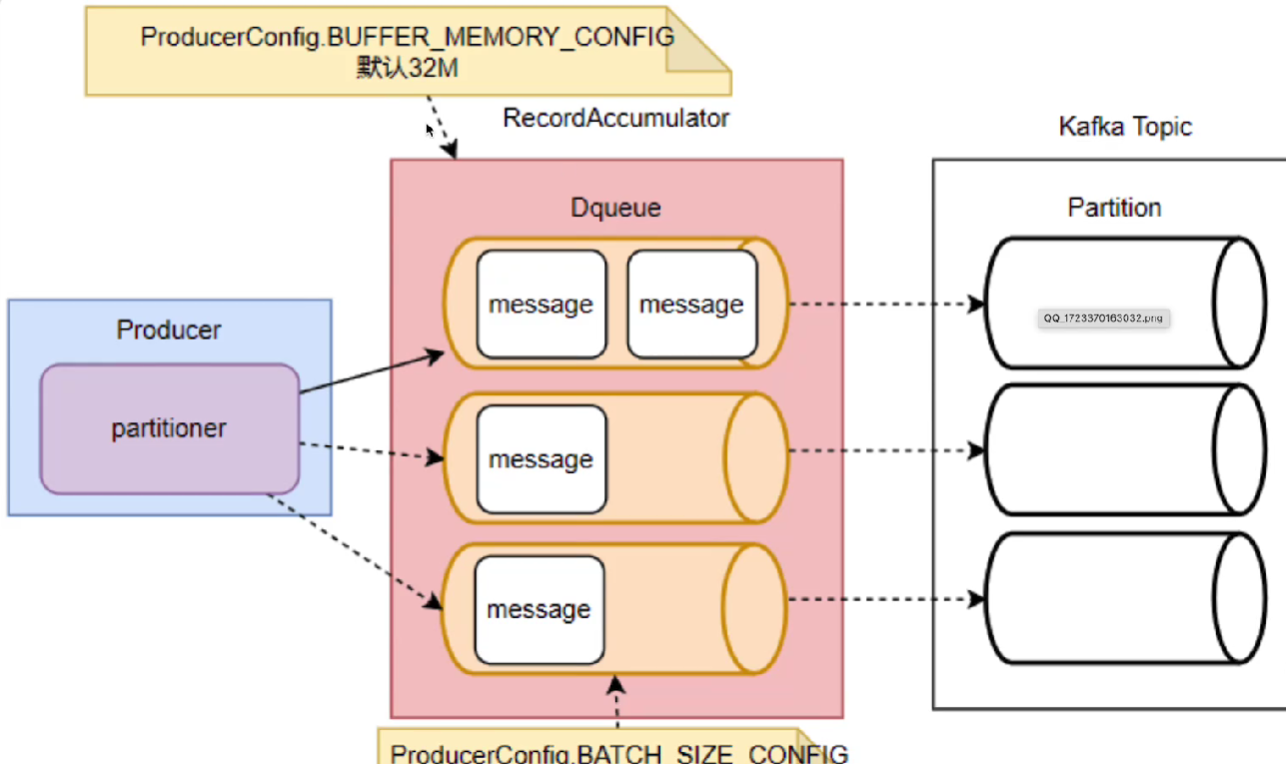
sender 就是 KafkaProducer 中用来发送消息的一个单独的线程。从这里可以看到,每个 KafkaProducer 对象都对应一个 sender 线程。他会负责将 RecordAccumulator 中的消息发送给 Kafka。
Sender 也并不是一次就把 RecordAccumulator 中缓存的所有消息都发送出去,而是每次只拿一部分消息。他只获取 RecordAccumulator 中缓存内容达到 BATCH_SIZE_CONFIG 大小的 ProducerBatch 消息。当然,如果消息比较少,ProducerBatch 中的消息大小长期达不到 BATCH_SIZE_CONFIG 的话,Sender 也不会一直等待。最多等待 LINGER_MS_CONFIG 时长。然后就会将 ProducerBatch 中的消息读取出来。LINGER_MS_CONFIG 默认值是 0。
ProducerConfig.BATCH_SIZE_CONFIG累积器开始发送消息的累计消息缓存大小阈值ProducerConfig.LINGER_MS_CONFIG累积器开始发送消息的累计消息缓存时间阈值
发送应答机制
在 Producer 将消息发送到 Broker 后,要怎么确定消息是不是成功发到 Broker 上了呢?ack = acknowledgement 确认/应答
ProducerConfig.ACKS_CONFIG生产者要求服务端在考虑请求完成之前收到的确认策略。acks=0不关心 broker 是否收到消息并写入 partition,吞吐量最高,消息安全性最低acks=1broker 端的 leader partition 接收消息记录成功即可返回响应,由 leader 向 follower 异步地复制消息,但同步可能失败导致 follower 可能没获得消息。安全性较高,吞吐量相对低。acks=all/-1broker 端的所有 partition 都要写入消息再返回响应,确保从 producer 到 broker 到 leader partition 再到 follower partition 的整个网络链路都是安全的,每次发消息需要等待更长的时间,吞吐量最低。
在生产环境中,acks = 0 可靠性太差,很少使用。acks = 1,一般用于传输日志等,允许个别数据丢失的场景。使用范围最广。acks =-1, 一般用于传输敏感数据,比如与钱相关的数据。
如果 ack 设置为 all 或者-1,Kafka 也并不是强制要求所有 Partition 都写入数据后才响应。在 Kafka 的 Broker 服务端会有一个配置参数 min.insync.replicas,控制 LeaderPartition 在完成多少个 Partition 的消息写入后,往 Producer 返回响应。这个参数可以在 broker.conf 文件中进行配置。
综上, acks 设置成 all 或者-1,能够有效提高消息的安全性。但是从消息安全性方面考虑,应答机制只是保证 Broker 可以给 Producer 一个比较靠谱的响应,但并不代表就保证了消息不丢失。Producer 拿到响应后如何进行后续处理,Kafka 是不参与的。
生产者消息幂等性
幂等性 (idempotence)是指同一个请求发送一次或者发送多次的结果是一致的,不会因为多次请求而对系统产生了副作用。
当 Producer 的 acks 设置成 1 或-1 时,Producer 每次发送消息都是需要获取 Broker 端返回的 RecordMetadata 的。
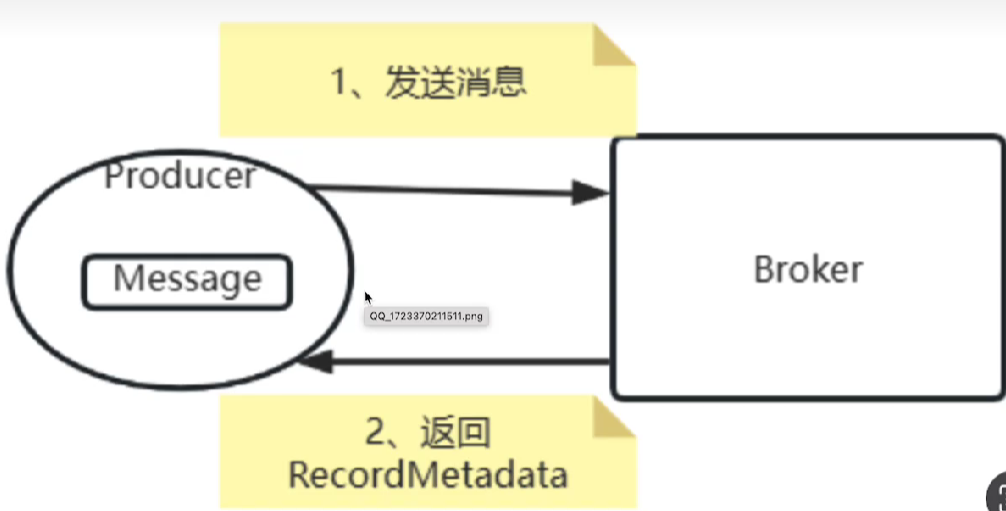
Producer 发送消息 i 的过程中,如果请求成功了,但是却没有返回。这时,Producer 就会认为消息发送失败了。那么 Producer 必然会发起重试。
ProducerConfig.RETRIES_CONFIG重试次数由参数 默认值是Integer.MAX,也就是不停的尝试。
这时问题就来了。Producer 会重复发送多条消息到 Broker 中。
Kafka 如何保证无论 Producer 向 Broker 发送多少次重复的数据,Broker 端都只保留一条消息,而不会重复保存多条消息呢?这就是 Kafka 消息生产者的幂等性问题。
首先需要理解分布式数据传递过程中的三个数据语义:
- at-least-once:至少一次。可以保证数据不丢失,但是不能保证数据不重复。实现逻辑相对简单。
- at-most-once:最多一次。保证数据不重复,但是又不能保证数据不丢失。实现逻辑相对简单。
- exactly-once:精确一次。数据即不重复也不丢失。实现逻辑复杂,需要有非常精密的设计。
在 Producer 发消息给 Broker 这个场景中:
如果要保证 at-most-once 语义,可以将 ack 级别设置为 0,生产者不关心消息是否写入,不关心服务端的应答,不会重新发送消息,不存在幂等性问题。
如果要保证 at-least-once 语义,就需要将 ack 级别设置为 0 或 -1,生产者会根据应答确保消息至少写入一次,如果没收到应答会重写发送消息,可能导致重复写入,存在幂等性问题。
为了保证消息发送的 Exactly-once 语义,在 ack 级别设置为 -1 的基础上,开启幂等性控制
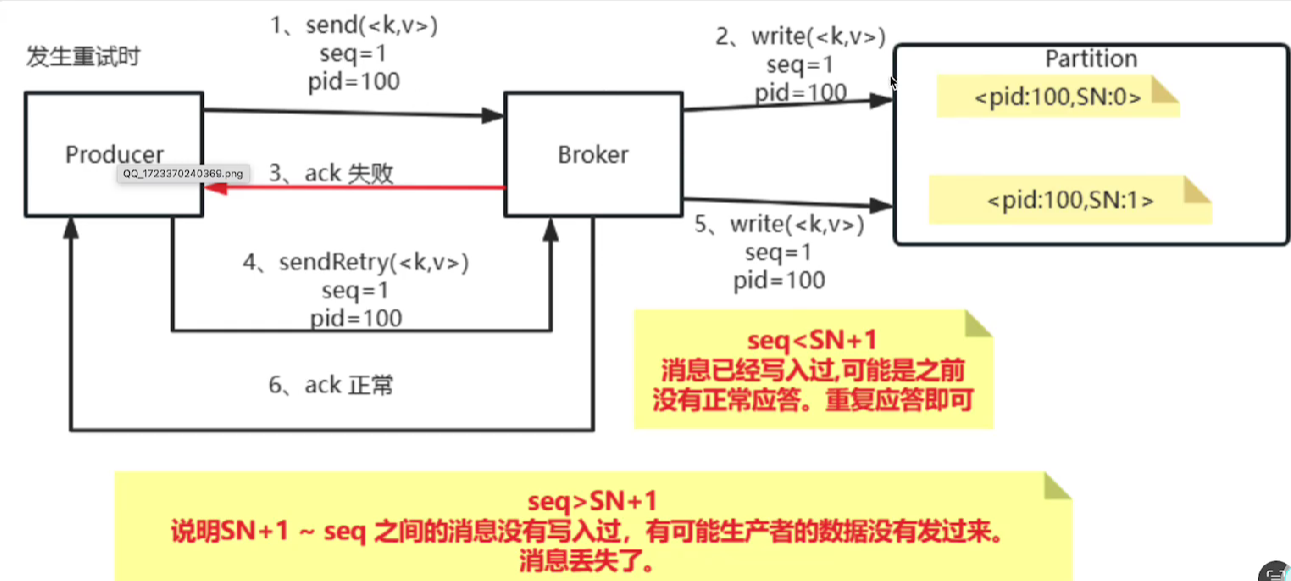
ProducerConfig.ENABLE_IDEMPOTENCE_CONFIG(开启要求ack=all否则不生效),这一在 Broker 端就会保证每条消息在一次发送过程中,Broker 端只会刚刚好持久化一条。实现机制参考如下几个概念
- PID: 每个新的 Producer 在初始化的过程中就会被分配一个唯一的 PID。这个 PID 对用户是不可见的。
- SequenceNumer: 对于每个 PID,这个 Producer 针对 Partition 会维护一个 sequenceNumber。这是一个从 0 开始单调递增的数字。当 Producer 要往同一个 Partition 发送消息时,这个 Sequence Number 就会加 1。然后会随着消息一起发往 Broker。
- Broker 端则会针对每个 <PID,Partition> 维护—个序列号(SN),只有当对应的 SequenceNumber = SN+1 时,Broker 才会接收消息,同时将 SN 更新为 SN+1。否则,SequenceNumber 过小就认为消息已经写入了,不需要再重复写入。而如果 SequenceNumber 过大,就会认为中间可能有数据丢失了。对生产者就会抛出一个 OutOfOrderSequenceException,
生产者数据压缩机制
当生产者往 Broker 发送消息时,还会对每个消息进行压缩,从而降低 Producer 到 Broker 的网络数据传输压力,同时也降低了 Broker 的数据存储压力。
ProducerConfig.COMPRESSION_TYPE_CONFIGKafka 的生产者支持四种压缩算法。CompressionType.none/GZIP/SNAPPY/LZ4/ZSTD
从 zstd 算法具有最高的数据压缩比,但是吞吐量不高。z4 在吞吐量方面的优势比较明显。在实际使用时,可以根据业务情况选择合适的压缩算法。但是要注意下,压缩消息必然增加 CPU 的消耗,如果 CPU 资源紧张,就不要压缩了。
生产者消息事务
生产者消息幂等性问题,能够解决单生产者的一条消息写入单分区的的幂等性问题。但是,如果是多条消息要写入多个分区呢?比如生产者一次发送多条消息,然后给不同的消息指定不同的 key。这批消息就有可能写入多个 Partition,而这些 Partition 是分布在不同 Broker 上的。这意味着,Producer 需要对多个 Broker 同时保证消息的幂等性。
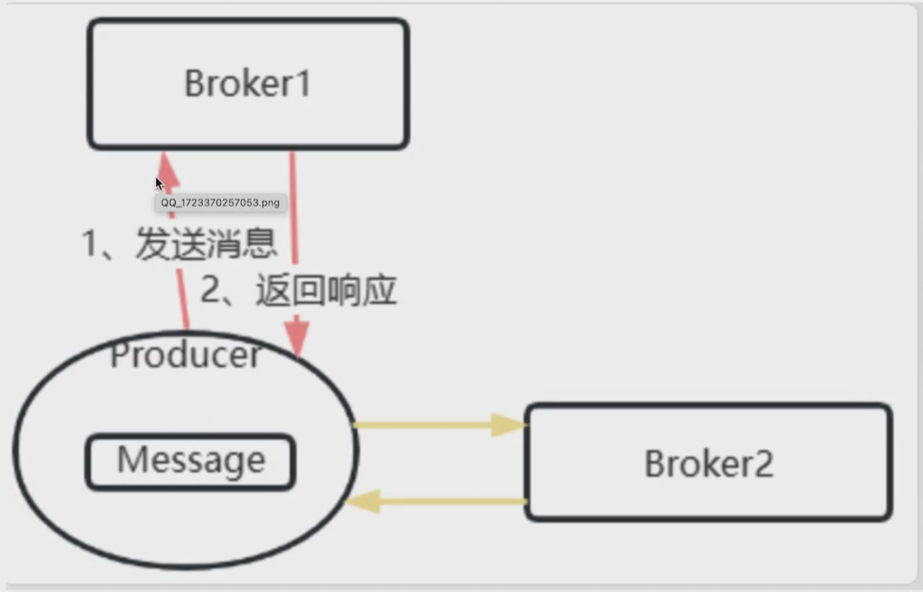
这时候,通过上面的生产者消息幂等性机制就无法保证所有消息的幂等了。这时侯就需要有一个事务机制,保证这一批消息最好同时成功的保持幂等性。或者这一批消息同时失败,这样生产者就可以开始进行整体重试,消息不至于重复。
public class KafkaProducer<K, V> implements Producer<K, V> {
    //1初始化事务
    void initTransactions();
    //2 开启事务
    void beginTransaction() throws ProducerFencedException;//3 提交事务
    void commitTransaction() throws ProducerFencedException;//4 放弃事务(类似于回滚事务的操作)
    void abortTransaction() throws ProducerFencedException;
}
案例,已 abort 的消息(前 9 条消息)会被消费者(READ_COMMITTED 隔离级别)跳过。
// 生产者 开启事务 发送消息
    @Test
    public void testTransaction() {
        Properties props = new Properties();
        // 配置 Kafka 服务器地址
        props.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, BOOTSTRAP_SERVERS);
        // 配置拦截器
//        props.put(ProducerConfig.INTERCEPTOR_CLASSES_CONFIG, "com.example.javademo.middleware.kafka.interceptor.KafkaInterceptor");
        // key 的序列化类
        props.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringSerializer");
        // value 的序列化类
        props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringSerializer");
        // 配置事务ID
        props.put(ProducerConfig.TRANSACTIONAL_ID_CONFIG, "test-transactional-id");
        KafkaProducer<String, String> transactionalProducer = new KafkaProducer<>(props);
        transactionalProducer.initTransactions();
        transactionalProducer.beginTransaction();
        for (int i = 0; i < 10; i++) {
            ProducerRecord<String, String> record = new ProducerRecord<>(TEST_TOPIC, "key" + i, "value" + i);
            try {
                // 异步发送
                transactionalProducer.send(record);
                if (i == 9) {
                    int a = 4/0;
                }
            } catch (ArithmeticException e) {
                transactionalProducer.abortTransaction();
            }
        }
        transactionalProducer.commitTransaction();
        transactionalProducer.close();
    }
注意消费者设置 READ_COMMITTED 隔离级别
@Bean
    public KafkaConsumer<String, String> kafkaConsumer() {
        Properties props = new Properties();
        props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, BOOTSTRAP_SERVERS);
        // 每个消费者都要指定一个组ID
        props.put(ConsumerConfig.GROUP_ID_CONFIG, "test-group");
        // 禁用自动提交
        props.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, false);
        // key 的反序列化类
        props.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringDeserializer");
        // value 的反序列化类
        props.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringDeserializer");
        KafkaConsumer<String, String> kafkaConsumer = new KafkaConsumer<>(props);
        return kafkaConsumer;
    }
Kafka 的事务消息还有额外两个功能:
- 一个 TransactionId 只会对应一个 PID。如果当前一个 Producer 的事务没有提交,而另一个新的 Producer 保持相同的 Transactionld,这时旧的生产者会立即失效,无法继续发送消息。
- 跨会话事务对齐。如果某个 Producer 实例异常宕机了,事务没有被正常提交。那么新的 Transactionld 相同的 Producer 实例会对旧的事务进行补齐。保证旧事务要么提交,要么终止。这样新的 Producer 实例就可以以一个正常的状态开始工作。
客户端流程总结
根据 ProducerConfig 和 ConsumerConfig 以及他们的父类 CommonClientConfig 去理解,大部分的属性都配有非常简明扼要的解释。尝试自己建立一个消息流转模型,理解其中比较重要的过程。然后重点从高可用,高并发的角度去理解 Kafka 客户端的设计,最后再尝试往其中填充具体的参数。|
Spring Boot 集成 Kafka
Spring Boot 集成
引入依赖
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-kafka</artifactId>
</dependency>
生产者,调用 KafkaTemplate 组件方法发送消息
@Controller
public class KafkaProducerController {

    @Autowired
    KafkaTemplate<String, String> kafkaTemplate;

    @GetMapping("/kafka/normal/{message}")
    public void sendMessage(@PathVariable String message) {
        kafkaTemplate.send("test-topic", message);
    }

}
消费者,声明一个 Kafka 监听器
@Component
@KafkaListener
public class KafkaConsumerListener {
    @KafkaListener(topics = {"normal-topic"})
    public void onMessage1(ConsumerRecord<?, ?> record) {
        System.out.println("topic:" + record.topic() + ",offset:" + record.offset() + ",partition:" + record.partition() + ",value:" + record.value());
    }
}
关键配置
spring:
  application:
    name: springboot-kafka-demo
  kafka:
    bootstrap-servers: 192.168.10.3:39092
    consumer:
      group-id: normal-group
      enable-auto-commit: true
    producer:
      key-serializer: org.apache.kafka.common.serialization.StringSerializer
      value-serializer: org.apache.kafka.common.serialization.StringSerializer
Kafka 基础参数配置
########### 【Kafka集君】###########
spring.kafka.bootstrap-servers=worker1:9092,worker2:9093,worker3:9093###########【刀始化生产者配置】###########
#重试次数
spring.kafka.producer.retries-0
#应答级别:多少个分区副本备份完成时向生产者发送ack确认(可选0、1、all/-1)
spring.kafka.producer.acks=1
#批量大小
spring.kafka.producer.batch-size=16384#提交延时
spring.kafka.producer.properties.linger.ms=0
#生产端缓冲区大小
spring.kafka.producer.buffer-memory = 33554432
# Kafka提供的序列化和反序列化类
spring.kafka.producer.key-serializer=org.apache.kafka.common.serialization.StringSerializerspring.kafka.producer.value-serializer=org.apache.kafka.common.serialization.StringSerializer###########【初始化消费者配置】###########
#默认的消费组ID
spring.kafka.consumer.properties.group.id=defaultConsumerGroup
#是否自动提交offset
spring.kafka.consumer.enable-auto-commit=true
#提交offset延时(接收到消息后多久提交offset)
spring.kafka.consumer.auto-commit-interval=1000
#当kafka中没有初始offset或offset超出范围时将自动重置offset
# earliest:重置为分区中最小的offset;
#latest:重置为分区中最新的offset(消费分区中新产生的数据);
#none:只要有一个分区不存在已提交的offset,就抛出异常;
spring.kafka.consumer.auto-offset-reset-latest
#消费会话超时时间(超过这个时间consumer没有发送心跳,就会触发rebalance操作)
spring.kafka.consumer.properties.session.timeout.ms=120000
#消费请求超时时间
spring.kafka.consumer.properties.request.timeout.ms-180000
#Kafka提供的序列化和反序列化类
spring.kafka.consumer.key-deserializer=org.apache.kafka.common.serialization.StringDeserializer
spring.kafka.consumer.value-deserializer=org.apache.kafka.common.serialization.StringDeserializer